前の記事「強化学習の仕組み①:行動・報酬・価値を、くじ引きの例で手計算する」では、3台のくじ引きから、もらえた報酬の平均で行動の価値を見積もりました。くじ引きには状態が1つしかなく、引いたらすぐに報酬が来ました。
迷路やゲームは違います。行動するたびに状態(今いる場所や盤面)が変わり、報酬はゴールに着いたときや勝負がついたときにしか来ません。ゴールの1歩手前の行動が良かったことはすぐに分かりますが、スタートでの最初の1歩が良かったかどうかは、ゴールに着くまで分かりません。
この記事では、この「遅れて来る報酬」を、前の状態へ少しずつ伝えていくやり方の Q 学習(キューがくしゅう)を、4マスの廊下で手計算します。そのあと、表をニューラルネットワークに置き換える考え方と、LLM の調整で強化学習がどう使われているかを見ます。紙とペンを用意してください。
4マスの廊下
S0・S1・S2・G の4マスが横に並んだ廊下を考えます。エージェントは S0 から始まり、毎回「右へ進む」か「左へ進む」を選びます。左端で左を選ぶと、その場にとどまります。G(ゴール)に着くと報酬 1 がもらえて、そこで1回分が終わります。G 以外のマスに着いたときの報酬は 0 です。スタートからゴールまでの1回分を、エピソードと呼びます。
答えは見れば分かります。ずっと右へ進むのが一番です。ここで知りたいのは、エージェントが報酬だけから、それをどうやって覚えるかです。
状態ごとの行動の価値 Q(s, a)
くじ引きでは、行動ごとに価値 Q を1つ持ちました。今度は、状態 s と行動 a の組ごとに価値を持ちます。これを Q(s, a) と書きます。「状態 s で行動 a を選び、そのあとも良い行動を続けたら、これからどれだけの報酬がもらえるか」の見積もりです。
廊下では、状態が3つ(S0・S1・S2)、行動が2つ(右・左)なので、6個の Q を表にして持ちます。この表を Q 表と呼びます。最初は全部 0 です。
| 状態 | 右 | 左 |
|---|---|---|
| S0 | 0 | 0 |
| S1 | 0 | 0 |
| S2 | 0 | 0 |
学習が終わったら、各状態で Q の大きいほうの行動を選びます。それが、この問題での方策になります。
Q 学習の更新の式
1歩進むたびに、次の式で Q 表のマスを1つ直します。
新しい Q(s, a) = 今の Q(s, a) + α × (目標 − 今の Q(s, a))
目標 = 今回の報酬 r + γ × (次の状態での Q の最大値)
くじ引きの「新しい Q = 今の Q + (1 ÷ 引いた回数) × (今回の報酬 − 今の Q)」と、同じ形をしています。違いは2つです。
1つ目は、目標に「γ × 次の状態での Q の最大値」が足されていることです。報酬がまだ来ていなくても、「次の状態から先でもらえそうな報酬」の見積もりを、今の行動の価値に入れます。ゴールの価値が、1歩ずつ手前のマスへ伝わっていくのは、この項のおかげです。
2つ目は、α(アルファ)という決まった数で直す量を決めていることです。α は学習率で、ニューラルネットワークの学習率と同じ役目です。ここでは α = 0.5 にします。
γ(ガンマ)は割引率と呼ぶ 0 から 1 の数で、ここでは 0.9 にします。1歩先の報酬を 0.9 倍、2歩先を 0.9 × 0.9 倍…と、先の報酬ほど少し割り引いて数えるための数です。同じ報酬なら、早くもらえるほうを選ぶようになります。
ゴールに着いたらそこで終わるので、ゴールの「次の状態での Q の最大値」は 0 として計算します。
手で3エピソード進める
話を短くするため、エージェントは毎回 S0 → S1 → S2 → G と右へ進んだとします(実際には ε-greedy などで左も試しますが、更新の式の働きを見るにはこれで足ります)。直すのは「右」の列だけです。
1エピソード目
S0 で右 → S1、報酬 0:  目標 = 0 + 0.9 × 0 = 0     Q(S0,右) = 0 + 0.5 × (0 − 0)   = 0
S1 で右 → S2、報酬 0:  目標 = 0 + 0.9 × 0 = 0     Q(S1,右) = 0 + 0.5 × (0 − 0)   = 0
S2 で右 → G、 報酬 1:  目標 = 1 + 0       = 1     Q(S2,右) = 0 + 0.5 × (1 − 0)   = 0.5
1回目で値が付いたのは、ゴールの手前の S2 だけです。S0 と S1 では、次の状態の Q がまだ 0 なので、何も分かりません。
2エピソード目
S0 で右:  目標 = 0 + 0.9 × Q(S1,右) = 0 + 0.9 × 0   = 0       Q(S0,右) = 0
S1 で右:  目標 = 0 + 0.9 × Q(S2,右) = 0 + 0.9 × 0.5 = 0.45    Q(S1,右) = 0 + 0.5 × (0.45 − 0) = 0.225
S2 で右:  目標 = 1                                            Q(S2,右) = 0.5 + 0.5 × (1 − 0.5) = 0.75
S2 についた価値が、1マス手前の S1 に伝わりました。
3エピソード目
S0 で右:  目標 = 0.9 × 0.225 = 0.2025    Q(S0,右) = 0 + 0.5 × (0.2025 − 0)     = 0.101
S1 で右:  目標 = 0.9 × 0.75  = 0.675     Q(S1,右) = 0.225 + 0.5 × (0.675 − 0.225) = 0.45
S2 で右:  目標 = 1                       Q(S2,右) = 0.75 + 0.5 × (1 − 0.75)    = 0.875
3回目で、ようやくスタートの S0 にも価値が付きました。ゴールで1回もらった報酬が、エピソードを重ねるごとに1マスずつ手前へ伝わっていきます。
| エピソード | Q(S0,右) | Q(S1,右) | Q(S2,右) |
|---|---|---|---|
| 1 | 0 | 0 | 0.5 |
| 2 | 0 | 0.225 | 0.75 |
| 3 | 0.101 | 0.45 | 0.875 |
| 5 | 0.405 | 0.731 | 0.969 |
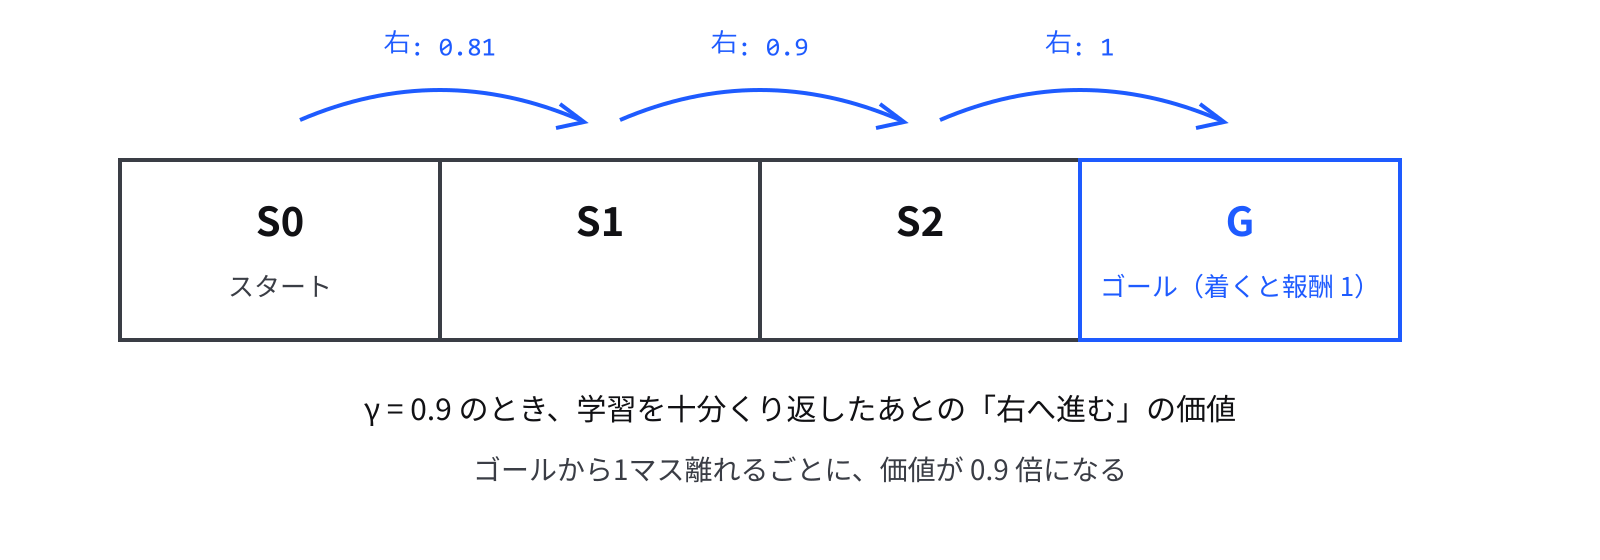
| 十分くり返したあと | 0.81 | 0.9 | 1 |
十分くり返すと、Q(S2,右) は 1、Q(S1,右) は 0.9 × 1 = 0.9、Q(S0,右) は 0.9 × 0.9 = 0.81 に近づきます。ゴールから1マス離れるごとに、価値が γ = 0.9 倍になります。
割引率がある理由
γ を 1 にすると、どの道を通っても最後に 1 がもらえるなら、遠回りでも同じ価値になります。S1 で左に戻ってから右に進み直しても、価値は変わりません。γ を 1 より小さくすると、ゴールまでの歩数が多いほど価値が下がるので、エージェントは近道を選ぶようになります。
表から、ニューラルネットワークへ
廊下の Q 表は6マスでした。テレビゲームの画面を状態にすると、画面の画素の組み合わせは数えきれないほどあり、表に書ききれません。
そこで、Q 表の代わりにニューラルネットワークを使います。状態(ゲームの画面)を入力すると、行動ごとの Q を出すネットワークです。更新の式の「目標」を正解の代わりにして、ネットワークの出す Q が目標に近づくように、重みを勾配降下法で直します。2015 年に DeepMind が発表した DQN(Deep Q-Network)は、このやり方で、Atari のテレビゲーム 49 本を画面だけから学習し、多くのゲームで人間のプレイヤーと同じくらいの点数を出しました。
ネットワークを学習させる計算は、「誤差逆伝播法を手計算する」で扱っています。
LLM の調整での強化学習
ChatGPT のような LLM は、まず大量の文章で「次のトークンを予想する」学習をします。この段階のモデルは文章の続きを書くのは得意ですが、質問に役立つ答えを返すとは限りません。そこで、人が良いと感じる答えに寄せるために、強化学習が使われてきました。代表的なやり方が RLHF(Reinforcement Learning from Human Feedback、人のフィードバックによる強化学習)です。OpenAI が 2022 年に発表した InstructGPT の論文で広く知られるようになりました。
| 強化学習の言葉 | RLHF で当たるもの |
|---|---|
| エージェント・方策 | LLM。質問(状態)から答え(行動)を作る |
| 行動 | 答えの文章(次のトークンを選ぶことのくり返し) |
| 報酬 | 答えの良さを点数にしたもの |
報酬を人が毎回付けるのは大変なので、先に「人が2つの答えのどちらを良いと選んだか」のデータをたくさん集め、そのデータから答えの点数を出すモデル(報酬モデル)を学習させます。そのうえで、LLM が報酬モデルから高い点数をもらえる答えを書くように、強化学習で直します。廊下の Q 学習と同じく、「報酬が大きくなる行動の選び方を覚える」という考え方です。
最近は、数学の問題のように答えが合っているかを機械で確かめられる課題で、「正解なら報酬 1」として強化学習させ、考える手順を長く書くモデルを育てるやり方も使われています。
課題:4エピソード目と、割引率を変えた場合
- 上の3エピソード目のあと、もう1回 S0 → S1 → S2 → G と進みました(4エピソード目)。Q(S0,右)、Q(S1,右)、Q(S2,右) はいくつになりますか。α = 0.5、γ = 0.9 のままです
- γ を 0.5 に変えて十分くり返すと、Q(S2,右)、Q(S1,右)、Q(S0,右) はそれぞれいくつに近づきますか
- 2 のように γ を小さくすると、エージェントの選び方はどう変わると考えられますか
答えと解説
- Q(S0,右) = 0.101 + 0.5 × (0.9 × 0.45 − 0.101) = 0.101 + 0.5 × 0.304 = 0.253、Q(S1,右) = 0.45 + 0.5 × (0.9 × 0.875 − 0.45) = 0.45 + 0.5 × 0.3375 = 0.619、Q(S2,右) = 0.875 + 0.5 × (1 − 0.875) = 0.9375 です。S0 を直すときに使う Q(S1,右) は、このエピソードで直す前の 0.45 です(S0 を先に直すため)
- Q(S2,右) は 1、Q(S1,右) は 0.5 × 1 = 0.5、Q(S0,右) は 0.5 × 0.5 = 0.25 に近づきます
- 先の報酬を小さく数えるので、すぐにもらえる報酬を重く見る、目先の得を優先する選び方になります。ゴールが遠い問題では、スタート付近の価値がほとんど 0 になり、学習が進みにくくなります
この記事で出てきた言葉
| 言葉 | 意味 |
|---|---|
| エピソード | スタートから終わり(ゴールや勝負の決着)までの1回分 |
| Q(s, a)・Q 表 | 状態 s で行動 a を選んだときの、これからもらえる報酬の見積もりと、それを並べた表 |
| Q 学習 | 「今回の報酬 + γ × 次の状態での Q の最大値」を目標にして、Q を少しずつ直すやり方 |
| 割引率(γ) | 先の報酬をどれだけ割り引いて数えるかを決める 0 から 1 の数 |
| DQN | Q 表の代わりにニューラルネットワークで Q を出す Q 学習 |
| RLHF | 人が選んだ好みから報酬モデルを作り、LLM を強化学習で調整するやり方 |
| 報酬モデル | 答えの良さを点数にするように学習させたモデル |
続けて読む記事
強化学習で調整される前の LLM が、文章をどうやって作っているかは、「LLM が次の1文字を予想する仕組みを、数えた確率の表で考える」から読めます。