ニューラルネットワークは、最初はでたらめな重みから始めて、答えが正解に近づく向きへ重みを少しずつ直すことで学習します。どちらへ直せばよいかを知るには、重み1つ1つについて「少し動かすと、外れ具合がどれだけ変わるか」(傾き)が要ります。実際の深層学習では、誤差逆伝播法(ごさぎゃくでんぱほう)というやり方で、何万個、何億個もある重みの傾きをまとめて出しています。
この記事では、その中身を、手で計算できる大きさで追います。損失で外れ具合を1つの数にし、傾きを掛け算でつなぐ連鎖律を確かめ、出口から傾きを戻していく誤差逆伝播法を手計算します。最後に、4人分の小さなデータで、重みとバイアスを実際に1回直します。
紙とペンを用意してください。プログラムは書きません。
この記事で使う計算
傾きと勾配降下法
グラフの傾きは、「横に少し進んだときに、縦がどれだけ変わるか」の割合です。曲がったグラフでは、場所によって傾きが変わり、その点での傾きを求めることを微分と呼びます。この記事で使う形は、次の1つです。
f(x) = (x − 3)² の、その点での傾きは 2 × (x − 3)
x = 1 なら傾きは 2 × (1 − 3) = −4 で、右下がりです。x = 3 で傾きは 0 になり、そこが f(x) のいちばん低い所です。
学習では、重み w を横軸、答えと正解のずれ(損失)を縦軸にしたグラフで、今いる場所の傾きを測り、坂を下る向きへ少しだけ動かします。これをくり返すやり方を、勾配降下法と呼びます。
新しい w = 今の w − 学習率 × 傾き
傾きがマイナスなら w は増え、プラスなら w は減ります。どちらも、損失が減る向きです。学習率は、1回にどれだけ動かすかを決める小さな数です。大きすぎると底を飛び越えて行ったり来たりし、小さすぎると底に着くまでに何千回もかかります。
重みが2つ以上あるときは、1つの重みだけを動かして、ほかを止めたときの傾きを、重みごとに別々に出します。これを偏微分と呼び、∂L/∂w のように書きます。「L(損失)を、w だけ動かしたときの傾き」と読んでください。微分のくわしい説明は、「AI の学習で使う微分と積分」にあります。
ニューロンの計算
ニューロン1つは、入力と重みの内積にバイアス b を足して z を出し、z を活性化関数に通して次へ渡します。この記事で使う活性化関数は ReLU(マイナスを 0 にして、プラスはそのまま通す関数)です。この計算の手計算は、前の記事「ニューラルネットワークの計算を手で追う」にあります。
学習の流れ
ネットワークの形が決まっても、最初のパラメータはでたらめな数なので、答えもでたらめです。学習で、パラメータを少しずつ直していきます。直し方は、上の「この記事で使う計算」の節で見た勾配降下法です。
| 順 | すること | 呼び名 |
|---|---|---|
| 1 | 今のパラメータで、入力から答えを出す | 順伝播(予測) |
| 2 | 答えと正解のずれを1つの数にする | 損失 |
| 3 | 損失が減る向きを、パラメータごとに調べる | 勾配 |
| 4 | 勾配と反対の向きに、少しだけ動かす | 更新(新しい w = 今の w − 学習率 × 傾き) |
| 5 | 1に戻ってくり返す |
1 は、前の記事で手計算した順伝播です。2 から順に見ていきます。
損失は、ずれを1つの数にしたもの
答えと正解のずれを表す数を、損失(そんしつ、loss)と呼びます。損失を計算する式を損失関数と呼びます。誤差と呼ぶこともあります。
予想を数で出すときによく使う損失は、「予想と正解の差を2乗して、平均を取ったもの」です。これを平均二乗誤差(へいきんにじょうごさ)と呼び、英語の Mean Squared Error の頭文字で MSE とも書きます。
前の記事のバイアスの節で使った4人のデータ(勉強時間 x = [1, 2, 3, 4]、点の伸び y = [3, 5, 6, 9])で、「点の伸び = w × 勉強時間」の w を 1 にしたときの損失を計算します。
予想       = [1, 2, 3, 4]       (勉強時間 × 1)
予想 − 正解 = [1−3, 2−5, 3−6, 4−9] = [−2, −3, −3, −5]
2乗        = [4, 9, 9, 25]
平均       = (4 + 9 + 9 + 25) ÷ 4 = 11.75
2乗するのは、差のプラスとマイナスが打ち消し合わないようにするためです。差のまま平均すると、+5 と −5 の2人がいたときに平均が 0 になり、どちらも大きく外れているのに「ずれなし」になってしまいます。2乗すると、どちらも 25 になります。大きく外れたものほど、損失に大きく効くようにもなります。
傾きを、少しずらして測る
3 の勾配は、パラメータ1つ1つの「損失の傾き」を並べたものです。傾きの式が分からなくても、計算で近い値を出す方法があります。パラメータをほんの少しだけずらして、損失がどれだけ変わったかを、ずらした幅で割ります。
傾き ≈ (損失(w + 0.0001) − 損失(w)) ÷ 0.0001
≈ は「だいたい等しい」という記号です。4人のデータで w = 1 の所を測ると、約 −18.5 になります。マイナスなので、w を増やせば損失が減ります。このように、少しずらして計算で傾きを出す方法を、数値微分(すうちびぶん)と呼びます。
数値微分は分かりやすいのですが、ネットワークが大きくなると困ります。手書き数字のネットワークには、13,002 個のパラメータがありました。数値微分を使うと、パラメータを1つずつ少しずらして、そのたびにネットワーク全体の順伝播をやり直すことになります。1回の更新のために、13,002 回の順伝播が要ります。LLM の大きさでは、計算が間に合いません。
そこで使うのが、次の2つの節の連鎖律と誤差逆伝播法です。
連鎖律は、傾きを掛け算でつなぐ決まり
データが1つだけの、いちばん小さな学習の例で考えます。入力は x = 2、正解は 6 で、予想は「w × 入力」とします。
予想 = w × 2
損失 = (予想 − 6)²
この損失の w での傾きは、8 × (w − 3) になります。w = 1 なら 8 × (−2) = −16 です。この式がどこから出てくるかを、順に見ていきます。
w が損失に効くまでには、2つの段階があります。w が変わると予想が変わり、予想が変わると損失が変わります。この2つの段階の傾きを、別々に出します。
1つ目は、「w を少し動かすと、予想はどれだけ変わるか」です。予想 = w × 2 なので、w を 1 増やすと予想は 2 増えます。傾きは 2 です。
2つ目は、「予想を少し動かすと、損失はどれだけ変わるか」です。損失 = (予想 − 6)² は、「この記事で使う計算」の節の (x − 3)² と同じ形をしているので、傾きは 2 × (予想 − 6) です。
w = 1 のときで、2つをつなげます。
- w = 1 なら、予想は 2 です
- 予想 = 2 の所で、損失の傾きは 2 × (2 − 6) = −8 です。予想を少し増やすと、その −8 倍だけ損失が変わります
- w を少し増やすと、予想はその 2 倍だけ増えます
w を 0.001 増やすと、予想は 0.002 増えます。予想が 0.002 増えると、損失は −8 × 0.002 = −0.016 変わります。w の 0.001 に対して損失が −0.016 なので、w での傾きは −16 です。2 × (−8) = −16 と、2つの傾きを掛ければ出ます。
損失の w での傾き = (予想の w での傾き) × (損失の予想での傾き)
                  = 2 × 2 × (予想 − 6)
                  = 2 × 2 × (2w − 6)
                  = 8 × (w − 3)
最後の行は、2 × 2 × (2w − 6) = 4 × 2 × (w − 3) と、(2w − 6) を 2 × (w − 3) に直してまとめたものです。w = 1 を入れると 8 × (−2) = −16 で、上の計算と合います。
このように、何段階かを通って効くときの傾きは、各段階の傾きの掛け算になります。この決まりを連鎖律(れんさりつ、chain rule)と呼びます。式では、次のように書きます。
∂L/∂w = ∂L/∂予想 × ∂予想/∂w
∂ の記号は、「この記事で使う計算」の節で出てきた偏微分の記号です。分数のように見える形を書き並べると、右辺の「∂予想」どうしが約分されて左辺になるように見えるので、形で覚えやすくなっています。
連鎖律は、両替にたとえると分かりやすくなります。1ドルが150円、1ユーロが1.1ドルなら、1ユーロは 1.1 × 150 = 165 円です。「ユーロが1増えるとドルがいくつ増えるか」と「ドルが1増えると円がいくつ増えるか」を掛ければ、「ユーロが1増えると円がいくつ増えるか」が出ます。傾きも、段階ごとの「何倍になって伝わるか」を掛けていけば、最初から最後まで通した傾きになります。
誤差逆伝播法は、出口から傾きを戻していくやり方
層が何枚もあるネットワークでも、連鎖律を使えば、すべての重みの傾きを出せます。その計算をどの順番でするかを決めたのが、誤差逆伝播法です。
重みが2つの、いちばん小さな2段のネットワークで見ます。
h = w₁ × x
y = w₂ × h
L = (y − 4)²

x = 1、w₁ = 2、w₂ = 3
まず、前から順に計算します(順伝播)。
h = 2 × 1 = 2
y = 3 × 2 = 6
L = (6 − 4)² = 4
次に、後ろから順に傾きを出していきます。
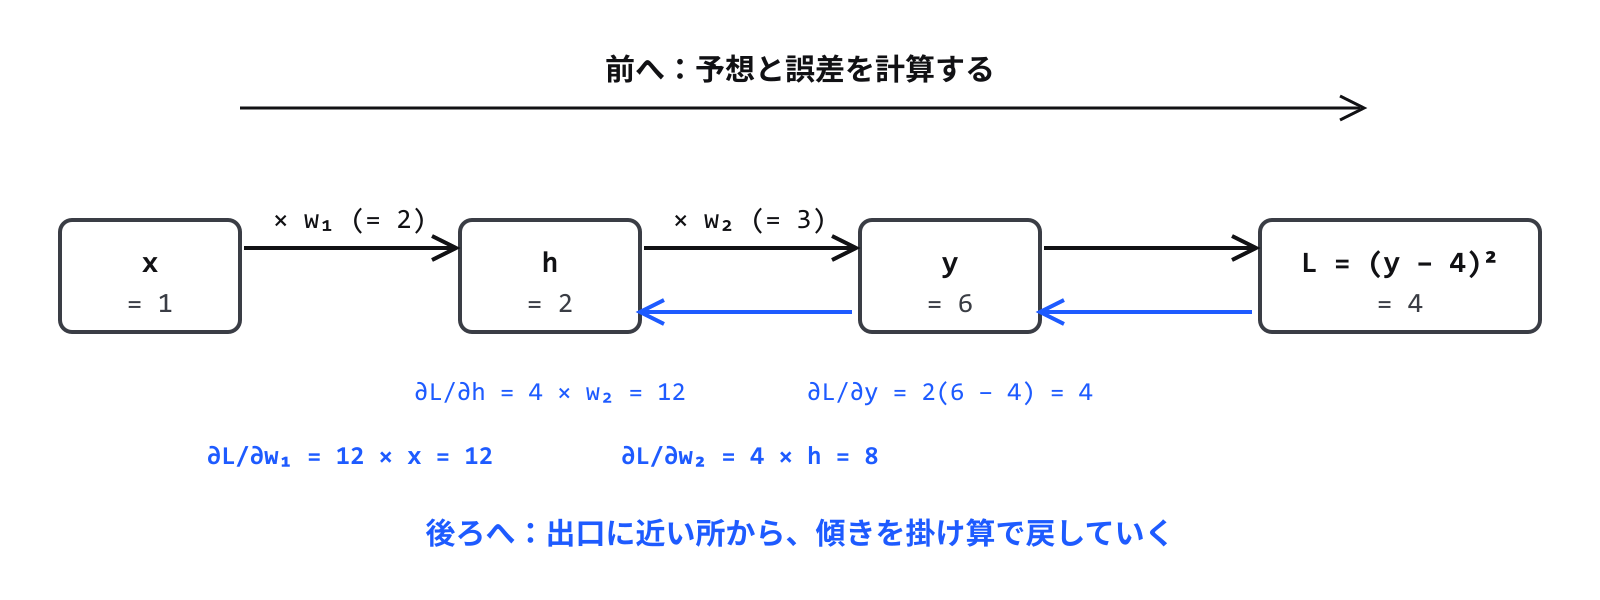
- 出口の L から始めます。L = (y − 4)² の y での傾きは、2 × (y − 4) = 2 × (6 − 4) = 4 です
- w₂ の傾きを出します。y = w₂ × h なので、w₂ を 1 増やすと y は h だけ増えます。y での傾きは 4 だったので、連鎖律で ∂L/∂w₂ = 4 × h = 4 × 2 = 8 です
- h の傾きを出します。y = w₂ × h なので、h を 1 増やすと y は w₂ だけ増えます。∂L/∂h = 4 × w₂ = 4 × 3 = 12 です
- w₁ の傾きを出します。h = w₁ × x なので、w₁ を 1 増やすと h は x だけ増えます。h での傾きは 12 だったので、∂L/∂w₁ = 12 × x = 12 × 1 = 12 です
4 では、3 で出した h での傾き 12 をそのまま使っています。出口に近い所の傾きを先に出しておけば、その手前の傾きは、1回の掛け算で出せます。L から1段ずつ前へ戻りながら、出した傾きを次の段に渡していくので、「誤差を逆向きに伝える」という意味で誤差逆伝播法と呼ばれます。英語では backpropagation(バックプロパゲーション)、略してバックプロップとも呼びます。
順伝播1回と、同じくらいの手間の逆向きの計算1回で、すべての重みの傾きがそろいます。数値微分のように、重みの数だけ順伝播をやり直す必要がありません。重みが13,002 個でも数十億個でも、この性質は同じです。
数値微分と比べて確かめる
出した傾きが合っているかを、学習の流れの節で出てきた数値微分で確かめます。w₁ だけを 0.0001 ずらして、損失の変わった量をずらした幅で割ります。
もとの損失:        h = 2×1 = 2、y = 3×2 = 6、L = (6 − 4)² = 4

w₁ を 2.0001 にする: h = 2.0001、y = 6.0003、L = (2.0003)² = 4.00120009
                    (4.00120009 − 4) ÷ 0.0001 = 12.0009

w₂ を 3.0001 にする: h = 2、y = 2×3.0001 = 6.0002、L = (2.0002)² = 4.00080004
                    (4.00080004 − 4) ÷ 0.0001 = 8.0004
w₁ だけをずらした傾きが約 12、w₂ だけをずらした傾きが約 8 で、誤差逆伝播法で出した 12 と 8 に合っています。数値微分のほうは、ずらす幅が 0 ではないので、少しだけずれます。
ReLU の傾き
ReLU をはさんだネットワークでも、やり方は同じです。ReLU の段の傾きだけ決めておけば、あとは掛け算でつなげます。
z が 0 より大きいとき: ReLU(z) = z なので、傾きは 1
z が 0 以下のとき:     ReLU(z) = 0 なので、傾きは 0
z がプラスのニューロンは、傾きをそのまま後ろへ通します。z がマイナスのニューロンは、傾きに 0 を掛けるので、そこから手前には傾きが伝わりません。そのときに反応しなかったニューロンの重みは、そのデータでは直されない、ということです。
4人のデータで、式で出した傾きを使う
4人のデータで、学習を進めます。予想は w × x + b、損失は平均二乗誤差です。正解の点の伸びを y と書きます。1人分の損失 (予想 − y)² を連鎖律でほどくと、次の傾きになります。
予想での傾き: 2 × (予想 − y)
w での傾き:   2 × (予想 − y) × x     (予想 = w×x + b を w で動かすと、x 倍で効く)
b での傾き:   2 × (予想 − y) × 1     (b を 1 増やすと、予想も 1 増える)
4人分の平均を取ったものが、損失全体の傾きです。データは、勉強時間 x = [1, 2, 3, 4] と、点の伸び y = [3, 5, 6, 9] です。
w と b を1回直す
最初の値を w = 1.0、b = 0.0、学習率を 0.02 として、1回分を手で計算します。
予想 = w×x + b = [1, 2, 3, 4]
予想 − y       = [−2, −3, −3, −5]
損失           = (4 + 9 + 9 + 25) ÷ 4 = 11.75

w での傾き = 2 × (−2×1 + −3×2 + −3×3 + −5×4) ÷ 4 = 2 × (−37) ÷ 4 = −18.5
b での傾き = 2 × (−2 + −3 + −3 + −5) ÷ 4          = 2 × (−13) ÷ 4 = −6.5

新しい w = 1.0 − 0.02 × (−18.5) = 1.37
新しい b = 0.0 − 0.02 × (−6.5)  = 0.13
新しい w と b で予想し直します。予想は [1.5, 2.87, 4.24, 5.61] で、予想 − y は [−1.5, −2.13, −1.76, −3.39] です。2乗して平均すると (2.25 + 4.5369 + 3.0976 + 11.4921) ÷ 4 = 約 5.34 で、11.75 から下がりました。1回直しただけで、損失は半分より小さくなっています。
式で出した傾きが合っているかは、数値微分でも確かめられます。w を 1.0001 にして損失を出し直すと、(損失の増えた量) ÷ 0.0001 は約 −18.499 になり、式で出した −18.5 とほぼ同じです。
くり返すと、どこに着くか
この1回分の計算を2000回くり返すと、w と b は一定の値に落ち着きます。結果だけを書きます。
| やり方 | w | b | 損失 |
|---|---|---|---|
| バイアスを使わない(b = 0 のまま、w だけ直す) | 約 2.233 | 0 | 約 0.342 |
| バイアスを使う(w と b を直す) | 1.9 | 1.0 | 0.175 |
バイアスが無いと、原点を通る線でしか合わせられないので、損失は約 0.34 で止まります。バイアスを足すと、予想の式は「点の伸び = 1.9 × 勉強時間 + 1.0」になり、損失は 0.175 まで下がります。それでも 0 にはなりません。4人のデータは1本のまっすぐな線の上にぴったり並んではいないので、どんな線を選んでも少しずれが残ります。実際の AI の学習でも、損失は 0 にはなりません。
w = 1.9、b = 1.0 のときの予想は [2.9, 4.8, 6.7, 8.6] で、予想 − y は [−0.1, −0.2, 0.7, −0.4] です。2乗して平均すると (0.01 + 0.04 + 0.49 + 0.16) ÷ 4 = 0.175 で、表の値と合います。
2000回を手で計算するのは大変です。そこで、PyTorch のような深層学習のライブラリは、傾きの式を人が書かなくても自動で作ってくれます。中でしているのは、この記事で手で追った連鎖律と誤差逆伝播法です。
課題:ニューロン1つの学習を1回進める
ニューロン1つの学習を、1回分だけ手で計算します。紙に答えを書いてから、下の答えと見比べてください。
入力 x = 2、正解 t = 5
重み w = 1、バイアス b = 1
z = w × x + b
予想 = ReLU(z)
損失 L = (予想 − t)²
学習率 0.1
- 順伝播をしてください。z、予想、損失はいくつですか
- 損失の、予想での傾き ∂L/∂予想 はいくつですか
- ReLU の段の傾きはいくつですか
- 連鎖律で、∂L/∂w と ∂L/∂b を出してください
- 勾配降下法で w と b を1回直し、新しい w と b でもう一度順伝播して、損失がいくつになったかを出してください
- もし最初のバイアスが b = −3 だったら、∂L/∂w と ∂L/∂b はいくつになりますか。そのとき、w と b は学習で直りますか
答えと解説
- z = 1×2 + 1 = 3、予想 = ReLU(3) = 3、損失 = (3 − 5)² = 4 です
- −4 です。2 × (予想 − t) = 2 × (3 − 5)
- 1 です。z = 3 が 0 より大きいからです。ここまでで、∂L/∂z = −4 × 1 = −4 です
- z = w × x + b なので、w を 1 増やすと z は x = 2 だけ増え、b を 1 増やすと z は 1 増えます。∂L/∂w = −4 × 2 = −8、∂L/∂b = −4 × 1 = −4 です
- 新しい w = 1 − 0.1 × (−8) = 1.8、新しい b = 1 − 0.1 × (−4) = 1.4 です。z = 1.8×2 + 1.4 = 5.0、予想 = 5.0 で、損失 = (5 − 5)² = 0 になりました。この例では、たまたま1回でぴったり正解に届いています
- z = 1×2 − 3 = −1 で、予想は ReLU(−1) = 0 です。ReLU の段の傾きが 0 なので、∂L/∂w = ∂L/∂b = 0 になります。傾きが 0 なので、勾配降下法で動かしても w と b は変わりません。損失は (0 − 5)² = 25 と大きいのに、このデータでは直せない状態です
6 のように、z がマイナスのままで学習が進まなくなったニューロンは、実際の深層学習でも起きることがあります。データがたくさんあれば、z がプラスになるデータで直されるので、ふつうは困りません。学習率を大きくしすぎると、たくさんのニューロンがこの状態になって学習が止まることがあり、学習率を選ぶときに気をつける理由の1つになっています。
この記事で出てきた言葉
| 言葉 | 意味 |
|---|---|
| 損失(loss)・損失関数 | 答えと正解のずれを表す数と、それを出す式 |
| 平均二乗誤差(MSE) | 予想と正解の差を2乗して、平均を取った損失 |
| 勾配 | パラメータごとの損失の傾き(偏微分)を並べたもの |
| 数値微分 | パラメータを少しずらして、計算で傾きを出す方法 |
| 連鎖律 | 何段階かを通って効くときの傾きは、各段階の傾きの掛け算になる、という決まり |
| 誤差逆伝播法 | 出口に近い所から順に、連鎖律で傾きを戻していき、すべてのパラメータの傾きを出すやり方 |
続けて読む記事
この記事で手で出した傾きは、PyTorch などの深層学習のライブラリが自動で出しています。ニューラルネットワークの考え方を使って文章を作る仕組みは、「LLM が次の1文字を予想する仕組みを、数えた確率の表で考える」から読めます。
同じ内容を式でまとめた記事として、「ニューラルネットワークの構造② 多層パーセプトロンとNNの学習」もあります。
参考にした資料
- 3Blue1BrownJapan「深層学習の仕組み, 勾配降下 | Chapter 2, 深層学習」(約20分)
- 3Blue1BrownJapan「誤差逆伝播法(バックプロパゲーション) | Chapter 3」(約13分。式を使わずに直感で説明しています)
- 3Blue1BrownJapan「誤差逆伝播と微積分 | Chapter 4」(約10分。Chapter 3 のあとに見てください)
- Noema「ニューラルネットワークの構造② 多層パーセプトロンとNNの学習」