ChatGPT や画像を見分ける AI の中には、ニューラルネットワークと呼ばれる計算の仕組みが入っています。説明では「脳の神経をまねた仕組み」と書かれることが多いのですが、中でしている計算は、掛け算と足し算と、マイナスを 0 にする操作の組み合わせです。この記事では、その計算を小さな数で手計算して確かめます。
この記事で扱うのは、入力から答えを出すまでの計算(順伝播)です。ニューロン1つの計算から始めて、ニューロンを並べた層、層を重ねたネットワークへと広げ、最後に手書き数字を見分けるネットワークのパラメータの数を数えます。答えを正解に近づけるための学習の計算は、続きの記事「誤差逆伝播法を手計算する」で扱います。
紙とペンを用意してください。プログラムは書きません。途中に小さな問題と答えを置いているので、答えを読む前に自分で計算してみてください。
この記事で使う計算
ニューラルネットワークの計算には、ベクトル、行列、傾きの3つが出てきます。ここで、この記事で使う分だけを短く確かめます。式の読み方や練習問題まで含めて学びたいときは、Noema の記事「AI で使うベクトルと行列」と「AI の学習で使う微分と積分」を読んでください。
ベクトルと内積
ベクトルは、数を決まった順番で1列に並べたものです。たとえば、ある人の1日の過ごし方を [勉強時間, 睡眠時間, スマホの時間] の順に並べると、[2, 7, 3] のようなベクトルになります。並んでいる1つ1つの数を要素と呼びます。
内積(ないせき)は、2つのベクトルの同じ番目の要素どうしを掛けて、全部足す計算です。答えは1つの数になります。過ごし方 x = [2, 7, 3] から、テストの点の伸びを予想するとします。それぞれの項目が点にどれだけ効くかを w = [10, 2, −4] と決めておくと、内積は次のとおりです。
x・w = 2×10 + 7×2 + 3×(−4)
     = 20 + 14 − 12
     = 22
w の数が大きい項目ほど、答えに強く効きます。マイナスの数(スマホの時間の −4)は、その項目が増えるほど答えを下げる向きに効きます。この「どれだけ重く見るか」を表す数を、重み(おもみ)と呼びます。重みを w と書くのは、英語の weight(重さ)の頭文字だからです。
行列とベクトルの掛け算
行列(ぎょうれつ)は、数を縦と横の長方形に並べたものです。横の並びを行、縦の並びを列と呼びます。
行列とベクトルの掛け算は、「行列の1つの行と、ベクトルとの内積」を、行の数だけくり返して並べる計算です。
[ 1  2 ]   [1]   [1×1 + 2×1]   [3]
[ 3  4 ] × [1] = [3×1 + 4×1] = [7]
行の中の数とベクトルの中の数を、前から順に組にして掛けるので、行列の列の数とベクトルの要素の数が同じでないと掛けられません。答えのベクトルの要素の数は、行列の行の数になります。2行3列の行列には要素が3つのベクトルを掛けられて、答えは要素が2つのベクトルです。
傾きと、傾きを使って少しずつ直す計算
グラフの傾きは、「横に少し進んだときに、縦がどれだけ変わるか」の割合です。傾きがプラスなら右上がりで、横の値を増やすと縦の値が増えます。マイナスなら右下がりで、増やすと減ります。
曲がったグラフでは、場所によって傾きが変わります。その点での傾きを求めることを、微分(びぶん)と呼びます。この記事で使う形は、次の1つです。
f(x) = (x − 3)² の、その点での傾きは 2 × (x − 3)
x = 1 なら傾きは 2 × (1 − 3) = −4 で、右下がりです。x = 3 で傾きは 0 になり、そこが f(x) のいちばん低い所です。
AI の学習では、答えと正解のずれを1つの数にしたもの(損失。あとで詳しく説明します)を、できるだけ小さくしたいです。重み w を横軸、損失を縦軸にしたグラフで、今いる場所の傾きを測り、坂を下る向きへ少しだけ動かします。これをくり返すやり方を、勾配降下法(こうばいこうかほう)と呼びます。
新しい w = 今の w − 学習率 × 傾き
傾きがマイナス(右下がり)なら w は増え、プラスなら w は減ります。どちらも、損失が減る向きです。学習率は、1回にどれだけ動かすかを決める小さな数です。損失が (w − 3)² のとき、w = 1 から学習率 0.1 で1回直すと、新しい w は 1 − 0.1 × (−4) = 1.4 になり、いちばん低い w = 3 に近づきます。
学習率が大きすぎると、底を飛び越えて反対側へ行ってしまいます。同じ例で学習率を 1.0 にすると、w は 1 → 5 → 1 → 5 と行ったり来たりして、3 にいつまでも着きません。小さすぎると、底に着くまでに何千回もかかります。
重みが2つ以上あるときは、1つの重みだけを動かして、ほかを止めたときの傾きを、重みごとに別々に出します。これを偏微分(へんびぶん)と呼び、∂(ラウンド、またはデル)という記号を使って ∂L/∂w のように書きます。「L(損失)を、w だけ動かしたときの傾き」と読んでください。
ニューロン1つの計算
ニューラルネットワークの部品を、ニューロンと呼びます。脳の神経細胞の名前から取っていますが、中でしているのは次の3つの計算だけです。
- 入力のベクトルと重みのベクトルの内積を取る
- バイアスと呼ぶ数を1つ足す
- 活性化関数と呼ぶ関数に通す
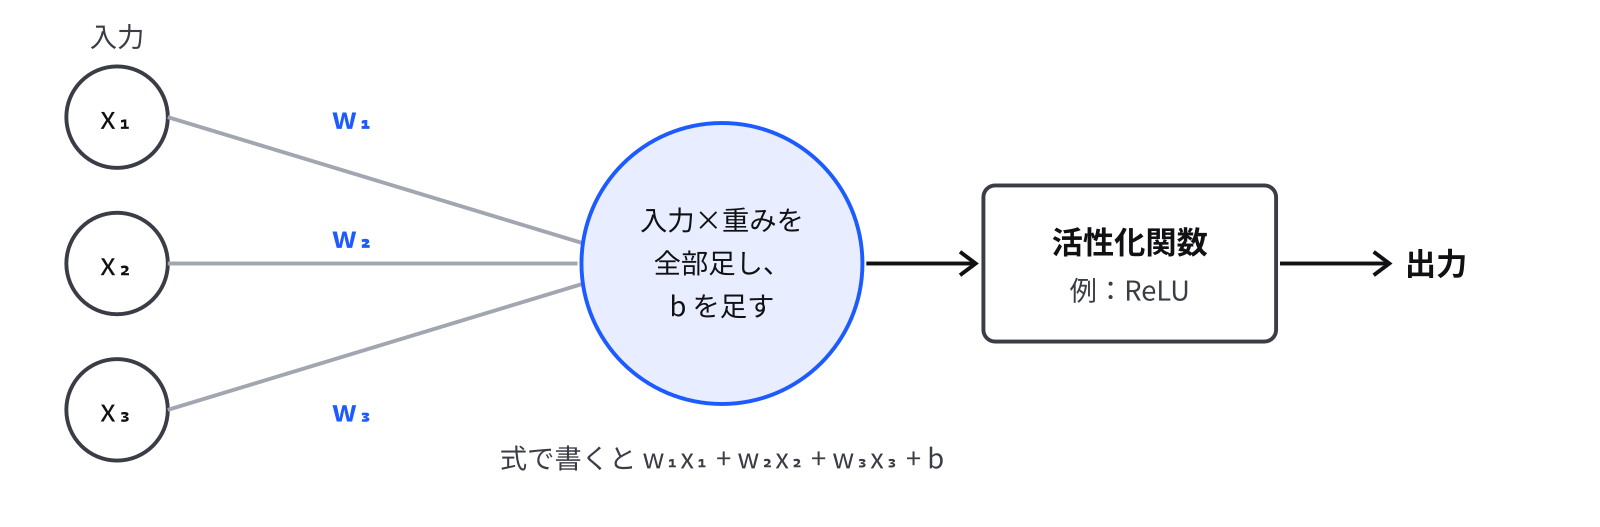
1 の内積は、「この記事で使う計算」の節で、過ごし方と重みから点の伸びを出した計算と同じです。2 と 3 が新しく出てきたので、順に見ていきます。
バイアスは、最後に足す数
バイアス(bias)は、内積のあとに足す1つの数で、b と書きます。内積に足すことを式にすると、次のようになります。
z = x・w + b = x₁w₁ + x₂w₂ + … + b
ここまでに出た z は、活性化関数に通す前の数です。
バイアスが何のためにあるのかを、小さなデータで考えます。1日の勉強時間(時間)と、小テストの点の伸びを、4人分集めたとします。このデータは、続きの記事「誤差逆伝播法を手計算する」で実際に学習させるときにも使います。
| 人 | 勉強時間 x | 点の伸び y |
|---|---|---|
| 1人目 | 1 | 3 |
| 2人目 | 2 | 5 |
| 3人目 | 3 | 6 |
| 4人目 | 4 | 9 |
「点の伸び = w × 勉強時間」という式で予想することにして、4人にいちばん合う w を探すとします。この式は、勉強時間が 0 のときに必ず予想が 0 になります。グラフで言えば、必ず原点を通るまっすぐな線です。4人のデータは、1人目は 3 倍、2人目は 2.5 倍、3人目は 2 倍、4人目は 2.25 倍で、原点から少しずれた所を通っています。どんな w を選んでも、4人全員には合わせきれません。計算すると、いちばん良い w = 2.2333 のときでも、ずれ(続きの記事で説明する損失)は約 0.34 残ります。
「点の伸び = w × 勉強時間 + b」と b を足すと、線を上下にずらせるようになります。学習させると、w = 1.9、b = 1.0 で、ずれが 0.175 まで下がります。バイアスは、重みと同じく学習で直していく数です。重みとバイアスをまとめて、パラメータと呼びます。
活性化関数は、z を形を変えて次へ渡す関数
活性化関数(かっせいかかんすう)は、z を受け取って、次へ渡す数に変える関数です。今いちばんよく使われているのは ReLU(レルー、ランプ関数とも呼ぶ)です。
ReLU(z) = z が 0 より大きければ z、そうでなければ 0
マイナスの数を 0 にして、プラスの数はそのまま通します。ReLU(3) = 3、ReLU(−0.5) = 0、ReLU(0) = 0 です。
小さな数で、ニューロン1つの出力を計算します。
入力  x = [1, 2]
重み  w = [0.5, −1]
バイアス b = 1

z = 1×0.5 + 2×(−1) + 1 = 0.5 − 2 + 1 = −0.5
出力 = ReLU(−0.5) = 0
z がマイナスだったので、出力は 0 になりました。重みを w = [2, 1]、バイアスを b = −1 に変えると、z = 1×2 + 2×1 − 1 = 3 で、出力は 3 です。
ReLU を通したニューロンは、「z がプラスのときだけ反応して、マイナスのときは黙っている」という動きをします。画像を見分ける深層学習では、手前の層は線やふちに、奥の層は耳や目の形に反応すると説明されることがあります。「反応する」というのは、そのニューロンの z がプラスになって、0 でない数を次へ渡すことです。
なぜ活性化関数が要るのか
活性化関数を外して、内積とバイアスだけでニューロンを作ったらどうなるかを考えます。答えから言うと、層をいくら重ねても、1つの層と同じことしかできなくなります。
バイアスを省いた、入力も出力も1つずつの小さな例で見ます。1つ目の層は入力を3倍し、2つ目の層はそれを2倍するとします。
1つ目の層: h = 3 × x
2つ目の層: y = 2 × h = 2 × (3 × x) = 6 × x
2つの層を通しても、結局は「6倍する層」1つと同じです。行列でも同じことが起き、行列 A を掛けてから行列 B を掛けるのは、B と A を先に掛け合わせた1つの行列を掛けるのと同じ答えになります。掛け算と足し算だけの計算は、何回重ねても掛け算と足し算1回分にまとまってしまうからです。
間に ReLU をはさむと、このまとまりが崩れます。マイナスを 0 にする所で、グラフが折れ曲がるからです。折れ曲がった線を何本も組み合わせると、曲がりくねった形も近似できます。深層学習が、画像や文章のような込み入ったものを扱えるのは、層を重ねたうえで、層と層の間に活性化関数をはさんでいるからです。
確認問題
入力 x = [3, 1]、重み w = [1, −2]、バイアス b = 0.5 のニューロンがあります。
- z はいくつですか
- ReLU に通した出力はいくつですか
- バイアスだけを変えて、出力を 0 より大きくするには、b をいくつより大きくすればよいですか
答え
- 1.5 です。3×1 + 1×(−2) + 0.5 = 3 − 2 + 0.5
- 1.5 です。プラスなのでそのまま通ります
- −1 より大きくします。内積の部分は 3 − 2 = 1 なので、z = 1 + b が 0 より大きくなるのは b が −1 より大きいときです。b を小さくするほど、このニューロンは反応しにくくなります。バイアスは「どのくらいで反応し始めるか」を決める数とも言えます
層を重ねる
ニューロンを何個か縦に並べたものを、層(そう)と呼びます。同じ入力を、並べたニューロンがそれぞれ自分の重みで計算します。
1つの層は、行列とベクトルの掛け算
入力 x = [1, 2] を、2個のニューロンが受け取る層を考えます。
ニューロン1: 重み [1, −1]、バイアス 0
ニューロン2: 重み [0.5, 1]、バイアス −1
1つずつ計算すると、次のようになります。
ニューロン1: z = 1×1 + 2×(−1) + 0  = −1   → ReLU → 0
ニューロン2: z = 1×0.5 + 2×1 + (−1) = 1.5 → ReLU → 1.5
2つのニューロンの重みを、行に並べて行列にします。1つの行が、1つのニューロンの重みです。
W = [ 1    −1 ]     x = [1]     b = [ 0]
    [ 0.5   1 ]         [2]         [−1]

z = W x + b = [−1 ]     h = ReLU(z) = [0  ]
              [1.5]                   [1.5]
W x の上の行は、ニューロン1の重み [1, −1] と x の内積で、下の行はニューロン2の重み [0.5, 1] と x の内積です。行列とベクトルの掛け算は、行ごとの内積を並べる計算だったので、2つのニューロンの計算がちょうど1回の掛け算にまとまります。1つの層の計算は、「重みの行列とベクトルを掛けて、バイアスのベクトルを足し、要素ごとに ReLU に通す」と書けます。層の出力を h と書くことが多いのは、隠れ層(かくれそう、hidden layer)の頭文字です。隠れ層は、入力と出力の間にある層のことで、外からは中の数が見えないのでこう呼ばれます。
2つ目の層につなぐ
この h = [0, 1.5] を入力にして、ニューロンが1個の出力の層につなぎます。重みは [2, −1]、バイアスは 0.5 とします。
出力 = 0×2 + 1.5×(−1) + 0.5 = −1
出力の層には、ReLU を付けないことがよくあります。マイナスの答えも出したいことがあるからです。
入力から順に層を通して、答えを出すまでの計算を、順伝播(じゅんでんぱ)と呼びます。AI の説明でよく出てくる「推論」は、学習が終わったネットワークで、この順伝播をすることです。
手計算の流れを書き直す
ここまでの順伝播を、数の流れとして1か所にまとめます。入力 x = [1, 2] から出力までです。
1つ目の層:  z₁ = W₁x + b₁ = [1×1 + (−1)×2 + 0,  0.5×1 + 1×2 − 1] = [−1, 1.5]
ReLU:       h  = [0, 1.5]
2つ目の層:  2×0 + (−1)×1.5 + 0.5 = −1.0
z₁ の1つ目の要素 −1 は、ReLU を通ると 0 になります。2つ目の要素 1.5 はそのままです。出力は −1.0 です。途中で ReLU がマイナスの数を 0 にしている所を、自分の手で確かめてください。
手書き数字を見分けるネットワーク
ここまでの計算を、大きくしたものを見ます。28 × 28 マスの白黒の手書き数字の画像を見て、0〜9 のどれかを当てるネットワークです。
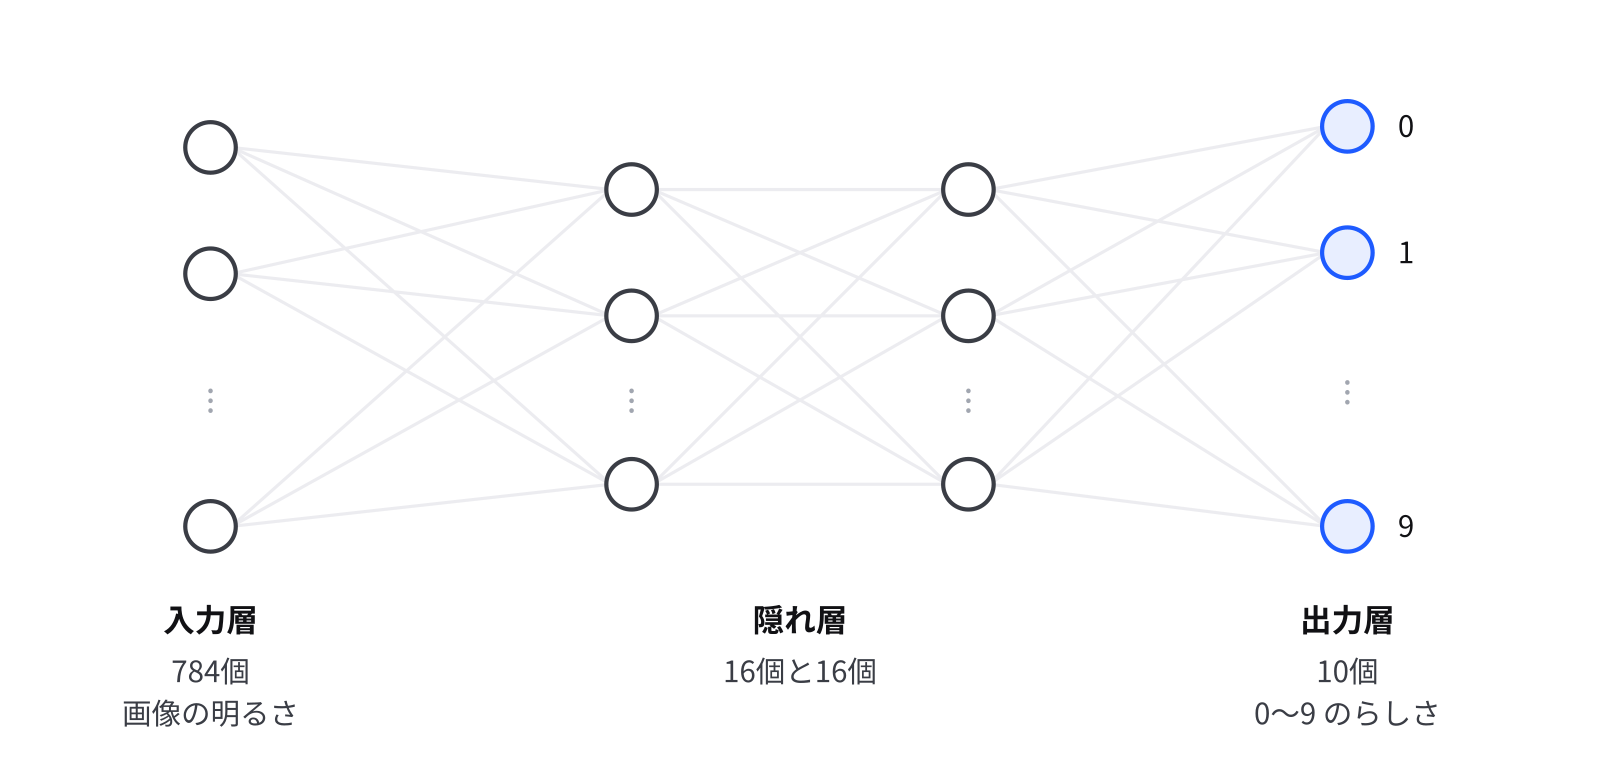
| 層 | 丸の数 | 何を表すか |
|---|---|---|
| 入力層 | 784 | 28×28 の画像の、1マスごとの明るさ |
| 隠れ層1 | 16 | 途中の計算 |
| 隠れ層2 | 16 | 途中の計算 |
| 出力層 | 10 | 0〜9 のそれぞれらしさ |
入力層は、画像をベクトルにしたものです。白黒の画像は、小さなマスの明るさ(たとえば 0 が黒、1 が白)の集まりです。28 × 28 = 784 個のマスの明るさを、左上から順に1列に並べると、要素が 784 個のベクトルになります。入力層では計算はしないので、丸の数は入力の数そのものです。
出力層の10個の数は、「0 らしさ」「1 らしさ」…「9 らしさ」です。一番大きい数が出た丸の番号を、答えにします。番号は 0 から数えます。たとえば 4 個の数 [0.1, 2.5, −1.0, 0.3] のうちいちばん大きいのは 2.5 で、0 から数えて 1 番目なので、答えは 1 です。
1つ目の隠れ層の計算は、16行784列の重みの行列 W1 を掛け、16個のバイアスを足し、ReLU に通すことです。行列の列の数 784 と、画像のベクトルの要素の数 784 が同じなので掛けられて、答えは行の数と同じ 16 個の数になります。16 × 784 = 12,544 個の掛け算と足し算が、1回の行列の掛け算にまとまっています。
パラメータの数を数える
層と層の丸は、すべて線でつながっています。線1本に重みが1つ、丸1つにバイアスが1つあります。行列で言えば、重みの数は「行の数 × 列の数」、バイアスの数は行の数です。
| つなぎ目 | 重みの行列の形 | 重みの数 | バイアスの数 |
|---|---|---|---|
| 入力層 → 隠れ層1 | 16 × 784 | 12,544 | 16 |
| 隠れ層1 → 隠れ層2 | 16 × 16 | 256 | 16 |
| 隠れ層2 → 出力層 | 10 × 16 | 160 | 10 |
| 合計 | 12,960 | 42 |
合わせて 13,002 個のパラメータがあります。学習とは、この13,002 個の数を、たくさんの画像で答え合わせをしながら、ちょうどよい値に合わせていくことです。ChatGPT などの中の LLM では、この数が数十億〜数千億個になります。
確認問題
入力が 4 個、隠れ層が 3 個、出力が 2 個のネットワークがあります。
- 入力層から隠れ層への重みの行列の形は、何行何列ですか
- パラメータ(重みとバイアス)は全部で何個ですか
答え
- 3行4列です。行の数がそこに並ぶニューロンの数(3)、列の数が受け取る入力の数(4)です。(3, 4) の行列に (4,) のベクトルを掛けると (3,) になり、隠れ層の3個の数が出ます
- 23 個です。入力層から隠れ層が 重み 3×4 = 12 と バイアス 3、隠れ層から出力層が 重み 2×3 = 6 と バイアス 2 で、12 + 3 + 6 + 2 = 23 です
この記事で出てきた言葉
| 言葉 | 意味 |
|---|---|
| ベクトル・内積 | 数を1列に並べたもの。内積は、同じ番目どうしを掛けて全部足した数 |
| 行列 | 数を縦と横の長方形に並べたもの。ベクトルとの掛け算は、行ごとの内積を並べること |
| 重み | 入力をどれだけ重く見るかを表す数。学習で直していく |
| 勾配降下法・学習率 | 傾きと反対の向きに少しずつ動いて損失の低い所を探すやり方と、1回に動かす量 |
| ニューロン | 入力と重みの内積にバイアスを足し、活性化関数に通す、ネットワークの部品 |
| バイアス(b) | 内積のあとに足す数。どのくらいで反応し始めるかを決める |
| 活性化関数・ReLU | z の形を変えて次へ渡す関数。ReLU はマイナスを 0 にしてプラスはそのまま通す |
| パラメータ | 重みとバイアスをまとめた呼び名。学習で直す数 |
| 層・隠れ層 | ニューロンを並べたもの。隠れ層は入力と出力の間にある層 |
| 順伝播 | 入力から順に層を通して、答えを出す計算 |
続けて読む記事
この記事では、決まった重みとバイアスで答えを出す計算を追いました。最初の重みはでたらめな数なので、答えもでたらめです。重みを少しずつ直して答えを正解に近づける計算は、「誤差逆伝播法を手計算する」で、同じ4人のデータを使って手計算します。
同じ内容を式と一緒にまとめた記事として、「ニューラルネットワークの構造① 単層パーセプトロンができるまで」もあります。
参考にした資料
- 3Blue1BrownJapan「ニューラルネットワークの仕組み | Chapter 1, 深層学習」(約18分。この記事の「層を重ねる」の節と同じ手書き数字の例を、動く図で見られます)
- Noema「ニューラルネットワークの構造① 単層パーセプトロンができるまで」