この記事は⓪「AIを理解するための前提知識」の内容、または同等の数学の基礎知識を前提とします。
第1章:単層パーセプトロン
1.1 ニューロンと形式ニューロン
1.1.1 ニューロン(神経細胞)
【ニューロンの構造】
ニューロン(神経細胞)とは、脳や神経系を構成し、情報を処理・伝達する役割を持つ細胞です。主に以下の3つの部分で構成されています。
- 【細胞体】:ニューロンの本体部分です。細胞の生命活動を維持するとともに、ほかの細胞から受け取った情報を統合・処理する役割を持っています。
- 【樹状突起】:細胞体から木の枝のように多数伸びている短い突起です。他のニューロンから送られてくる信号を受け取る、アンテナのような役割を持っています。
- 【軸索】:細胞体から長く伸びている突起です。細胞体で処理された電気信号を、別のニューロンや筋肉などへ送る役割を持っています。
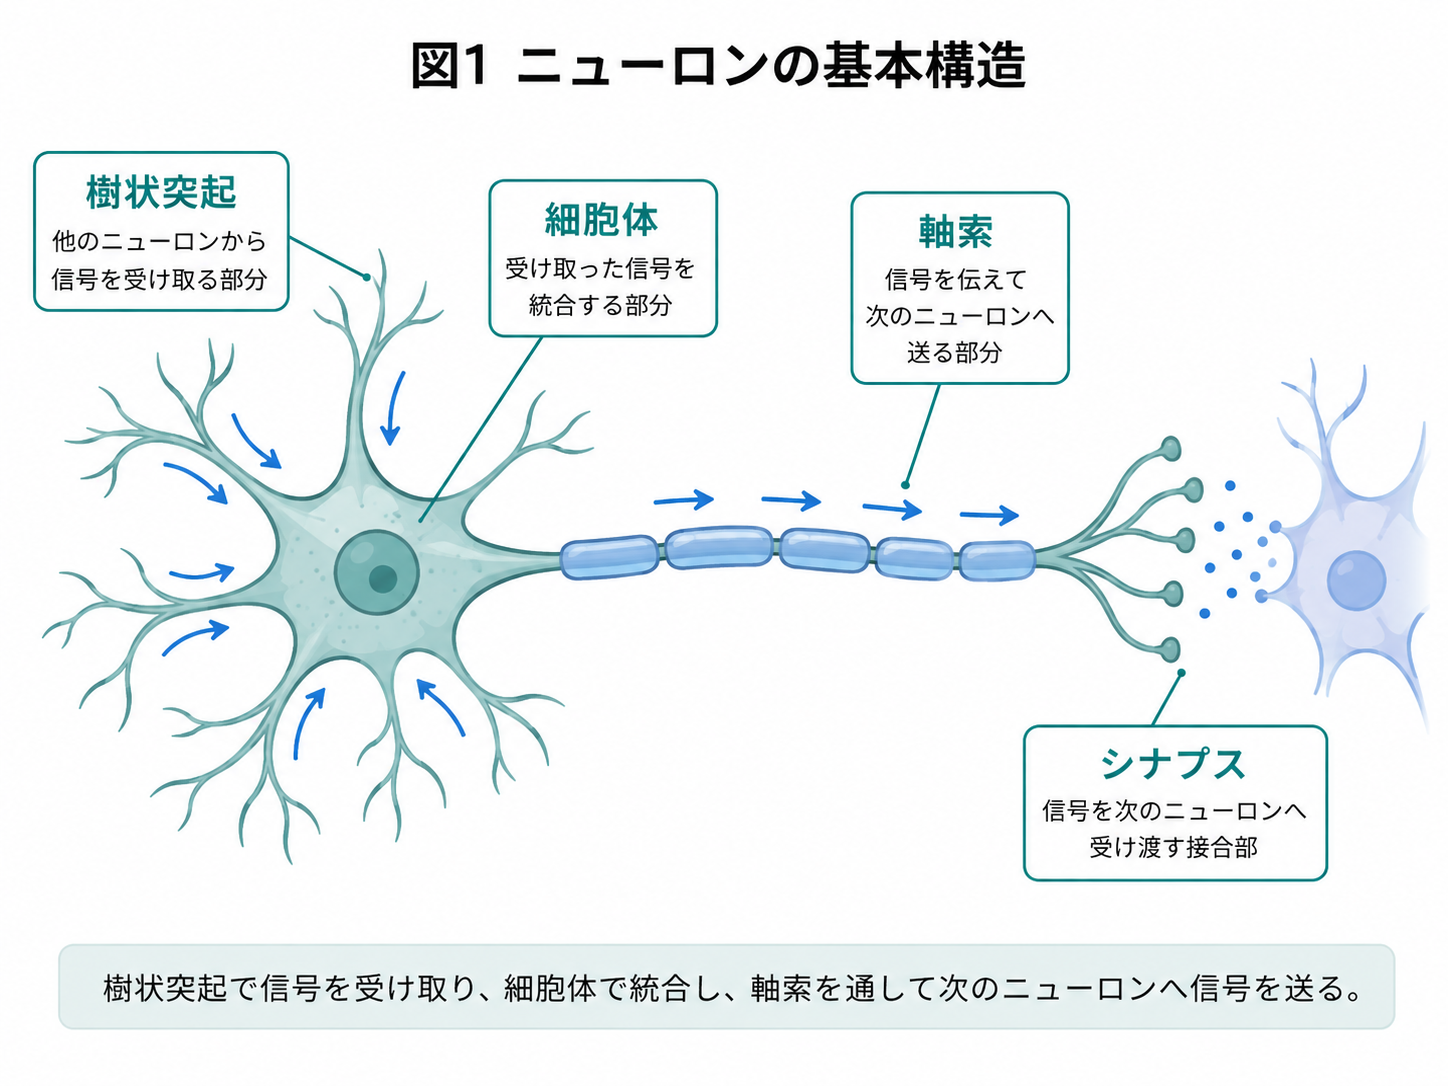
ニューロンで発生した信号は軸索を通り、他のニューロンなどへ伝えられます。ニューロン同士が情報を受け渡す接合部を【シナプス】といいます。
【発火】
ニューロンでは、入力によって膜電位が変化し、それが一定の閾値を超えると活動電位が発生します。この現象を、ニューラルネットワークの説明ではしばしば【発火】と表現します。
また、活動電位が発生した直後には、ニューロンが新たな刺激に反応できない、または反応しにくい期間があります。特に、どれだけ強い刺激を与えても新しい活動電位を発生させられない期間を【絶対不応期】といいます。
【抑制】
神経系には、ニューロンを興奮させる入力だけでなく、ニューロンの発火を起こりにくくする【抑制性入力】も存在します。
このように、生体のニューロンでは複数の興奮性・抑制性入力を統合し、その結果に応じて信号を出力しています。
こうした性質は、ニューロンの働きを論理計算や数理モデルとして表現する際にも重要な考え方となりました。
【ニューラルネットワークと脳】
こうした脳内の情報処理の仕組みから着想を得て、ニューラルネットワーク(Neural Network:NN)をはじめとするさまざまなモデルが研究されてきました。
ただし、現在のニューラルネットワークは、生物の脳をそのまま再現したものではありません。
代表的なフィードフォワードニューラルネットワークと脳を比較すると、次のような違いがあります。
- フィードフォワードNNでは、入力から出力まで基本的に一方向へ信号が流れます。一方、脳には信号が以前のニューロン群へ戻るような再帰的な接続も数多く存在します。
- 脳では非常に多数のニューロンが複雑かつ比較的局所的に接続されています。一方、一般的な全結合型NNでは、隣接する層のノード同士が広く接続された密な構造を持つ場合があります。
1.1.2 形式ニューロン
実際の脳を構成する神経細胞(ニューロン)は、複数の他の細胞から信号を受け取ります。
そして、受け取った入力の影響を統合し、その結果が一定の閾値を超えると活動電位を発生させ、次のニューロンへ情報を伝えます。
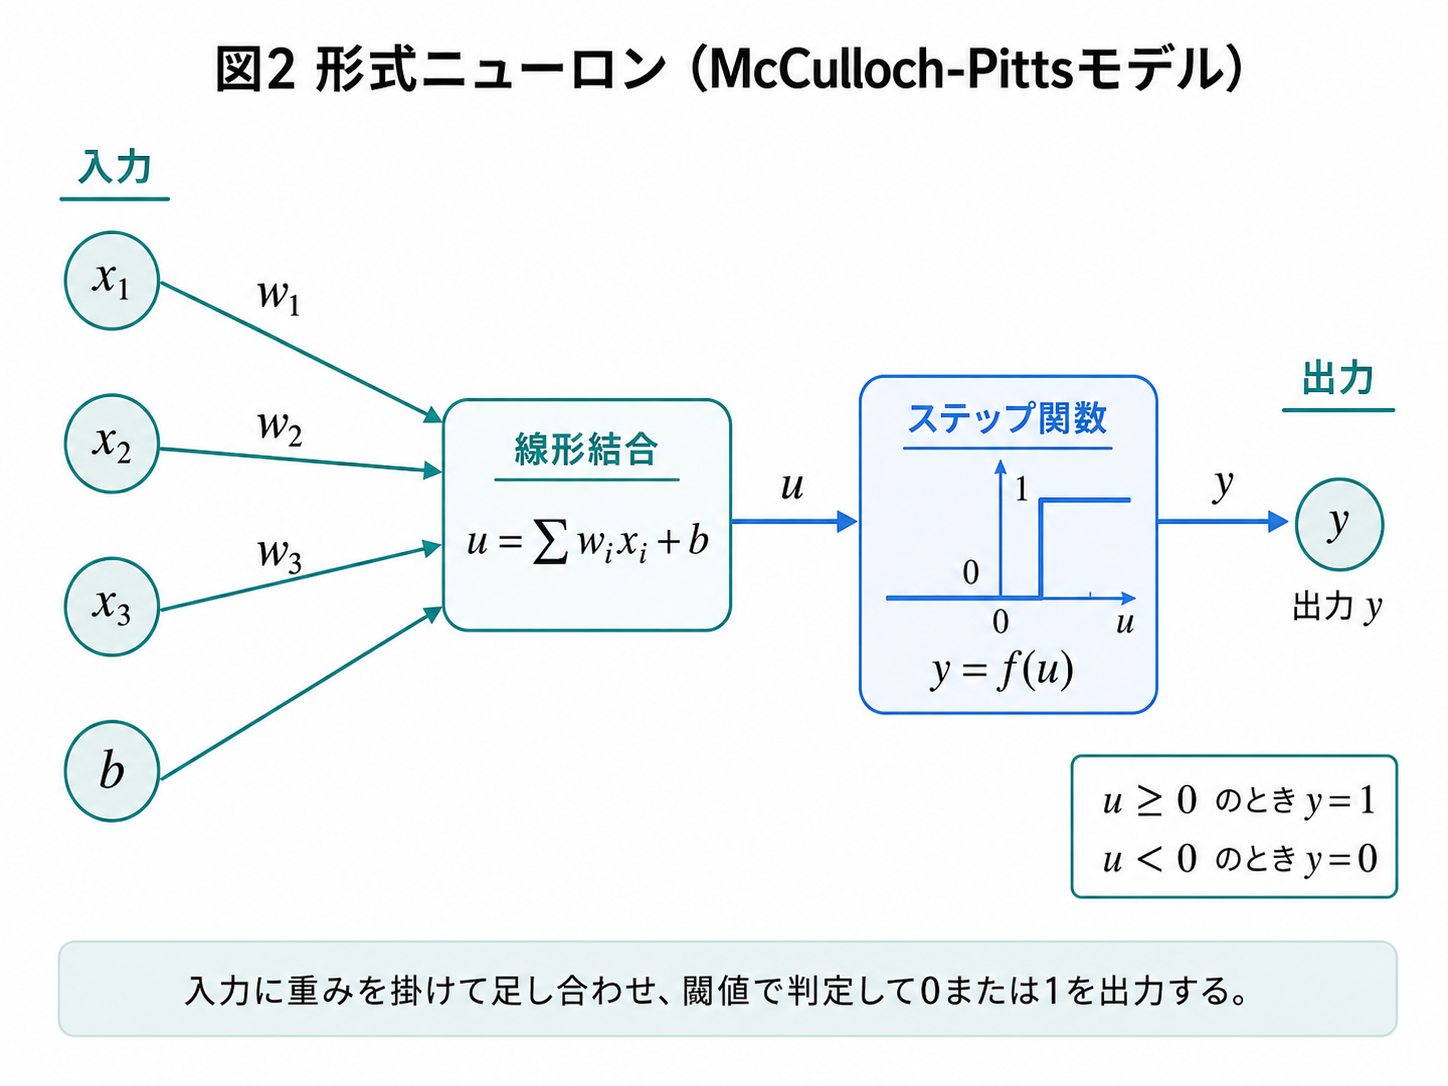
1943年、Warren McCullochとWalter Pittsは、このニューロンの働きを単純化した数理モデルを提案しました。
これを【形式ニューロン(McCulloch-Pitts neuron)】と呼びます。
【1943年の原型と、本記事で用いる数式の区別】
McCullochとPittsの原論文は、ニューロンの発火を論理命題として扱い、ニューロンの接続によって論理演算を実現するモデルを示しました。記法はCarnapの論理言語を基礎とし、『Principia Mathematica』の記法も取り入れています。
原型では、一定数の興奮性シナプスが同時に活動すると発火し、抑制性シナプスが活動すると発火を阻止する、という条件を置いています。閾値や全か無かの応答は当初からありますが、以下の「任意の実数の重み・バイアス・ステップ関数」による表記を、そのまま1943年の定式化とみなすことはできません。また、原型のネットワークでは接続構造を固定し、誤差に応じて重みを更新する学習規則は導入していません。(原論文、特にpp. 118–121)
以下では、後のパーセプトロンにつなげるため、【現代的な閾値ニューロンの表現】を用います。これは1個のニューロンの計算を表す式です。重みは入力の影響の大きさを表すパラメータであり、一般に「送信元のニューロンの数」そのものではありません。原型の抑制も、単に任意の負の重みを付けることとは区別が必要です。
まず、 個の入力信号を
とします。
一般に、 番目の入力を と表します。
各入力には、その入力が出力にどれだけ影響するかを表す【重み】 を掛けます。
さらに、発火のしやすさを調整するために【バイアス】 を加えます。
ニューロンの内部状態 は、入力と重みの積の和として、
と表せます。
和を展開すると、
です。
重み付き和 を【線形結合】と呼びます。バイアスまで含む式は、厳密には【アフィン変換】です。閾値を と書けば、 とすることで、重み付き和が閾値以上かどうかを で判定できます。
この内部状態 が0以上であれば1を出力し、0未満であれば0を出力するものとします。
ステップ関数 を用いると、
と表せます。
ここで、
とします。
つまり、入力をまとめて計算し、その値が閾値以上かどうかで出力を決めるのが、ここで扱う閾値ニューロンです。
単一の閾値ニューロンではXORを表現できませんが、複数の形式ニューロンを組み合わせれば表現できます。例えば、 AND NOT と、NOT AND をそれぞれ計算し、その結果をORで結べばXORになります。これは、信号の伝達に必要な遅延を考慮すれば、1943年の論理回路としても構成できます。
このように、ニューロンを組み合わせて論理演算を表す考え方は当初から存在しました。後の多層ネットワークとの共通点は【複数の計算単位を組み合わせて表現力を高めること】であり、学習方法まで同じという意味ではありません。以降では、結合の変化に関するヘブの仮説、そして誤差からパラメータを更新するパーセプトロンの学習規則へと進みます。
1.2 ヘブ則(ヘッブの法則)
形式ニューロンによってニューロンの働きを数理的に表現できるようになりました。
しかし、目的の出力、例えばANDやORなどの論理演算を得るためには、適切な結合の強さを決める必要があります。
この「結合の強さを経験によって変化させる」という考え方につながる重要な原理として、1949年にDonald Hebbが提唱した【ヘブ則(Hebb's rule)】があります。
ヘブ則の基本的な考え方は、
同時に活動するニューロン同士の結合は強くなる
というものです。
Hebbの原著『The Organization of Behavior』(1949年、第4章、p. 62)では、ある細胞が別の細胞の発火に繰り返し寄与すると、その結合の効率が高まるという仮説が述べられています。以下はその考え方を単純化した現代的な学習則であり、原著の式をそのまま引用したものではありません。入力 と出力 に基づいて、重み を更新します。
ある入力 と、その結果として出力 が得られたとき、重みの更新量 を
と定義します。
ここで、(イータ)は【学習率(Learning Rate)】と呼ばれる正の定数です。
学習率 は、1回の学習で重みをどの程度変化させるか、つまり更新の歩幅を決定します。
新しい重みは、
として更新されます。
例えば、
かつ、
の場合、
なので、
となり、
です。
したがって、
となり、その入力経路の重み が強化されます。
ヘブ則の2つの数学的欠点
ヘブ則は「学習」という考え方の重要な基礎ですが、単純なヘブ則にはいくつかの問題があります。
【1. 正解との誤差を直接利用しない】
ヘブ則の式
には、「本来出したかった正解の出力」、つまり教師データが含まれていません。
単純には、
入力と出力が同時に活動したら、その結合を強くする
という仕組みです。
そのため、モデルの予測が正解とどれだけ異なっていたのかを利用して、正解に近づく方向へ直接パラメータを修正する仕組みにはなっていません。
【2. 重みが増加し続ける可能性がある】
例えば、
かつ、
という状態が繰り返される場合、
となります。
学習率は正の値なので、
です。
したがって、
となります。
そのため、
という更新を繰り返すと、重み が増加し続ける可能性があります。
このような問題に対処するため、実際には重みの正規化や減衰など、追加の仕組みを導入した学習則も用いられます。
教師あり学習と教師なし学習
ここで、機械学習における【教師あり学習】と【教師なし学習】について簡単に整理します。
【教師あり学習】
AIに「入力データ」と「正解」をセットで与え、自分の予測と正解を比較しながら学習させる方法です。
例えば、
画像 + 「犬」または「猫」という正解ラベル
を与えて画像分類を学習させる場合が該当します。
【教師なし学習】
AIに正解ラベルのないデータを与え、データに含まれる構造や共通点などを学習させる方法です。
例えば、大量の購買履歴から、似た特徴を持つ顧客をグループ分けするクラスタリングなどがあります。
1.3 パーセプトロンの学習規則
形式ニューロンの考え方だけでは、目的に合わせてパラメータを自動的に調整する仕組みがありませんでした。
また、単純なヘブ則では、正解と予測の違いを直接使ってパラメータを修正することができません。
1950年代、Frank Rosenblattは形式ニューロンなどの研究を発展させ、【パーセプトロン(Perceptron)】を提案しました(Rosenblatt, 1958)。歴史的な提案には感覚・連合・応答の各単位を含む構成がありますが、ここでは学習可能な線形しきい値分類器に焦点を絞ります。
本記事で扱う単層パーセプトロンは、
線形結合 → ステップ関数 → 出力
という基本構造を持ちます。
さらに、予測を間違えた場合に重みを修正する【誤差訂正学習(Error Correction Learning)】を行います。
これは、教師信号とモデルの出力を比較し、その違いを利用してパラメータを修正するという教師あり学習の基本的な考え方です。
誤差訂正学習の数学的定義
パーセプトロンでは、データに対して「本来出力すべき正解」を教師信号 として与えます。
ここでは、
とします。
現在のパーセプトロンの出力を とすると、正解と予測の差は、
で表されます。
重みの更新量 は、
と定義されます。
そして、
として重みを更新します。
したがって、更新式全体は、
と書くこともできます。
同様に、バイアス の更新量を、
とします。
そして、
として更新します。
したがって、
と表すこともできます。
ヘブ則の更新式、
と比較すると、パーセプトロンでは、
という【正解と予測の差】を利用していることが大きな違いです。
数式が意味する「自動修正」のメカニズム
この
という単純な引き算によって、パラメータがどのように修正されるのかを具体的に見てみます。
【① 正解した場合】
例えば、
かつ、
の場合を考えます。
このとき、
となります。
また、
かつ、
の場合も、
です。
したがって、
に代入すると、
となります。
バイアスについても、
なので、
です。
したがって、重みもバイアスも更新されません。
つまり、
正解している場合は、現在の状態を維持する
という動作になります。
【② 本当は1なのに0と予測した場合】
本来は発火すべき、
なのに、
と予測した場合を考えます。
このとき、
です。
したがって、
に代入すると、
となります。
また、バイアスについては、
となります。
入力が、
であれば、その入力に対応する重み は増加します。
内部状態は、
であるため、関連する重みやバイアスが増加すると、同じような入力に対して が大きくなる方向へ変化します。
その結果、次回は1を出力しやすくなります。
つまり、
出力が小さすぎたため、1を出しやすい方向へ修正する
という処理です。
【③ 本当は0なのに1と予測した場合】
本来は発火すべきでない、
なのに、
と予測した場合です。
このとき、
となります。
したがって、
に代入すると、
です。
また、バイアスについては、
となります。
入力が、
であれば、その入力に対応する重み は減少します。
その結果、同じような入力に対する内部状態、
が小さくなる方向へ変化し、次回は0を出力しやすくなります。
つまり、
出力が大きすぎたため、1を出しにくい方向へ修正する
という処理です。
パーセプトロンの収束定理
このように、パーセプトロンは、
間違えたときに、正しく分類できる方向へパラメータを修正する
というアルゴリズムを持っています。
ここで数学的に重要なのが【パーセプトロンの収束定理】です。
有限個の学習データが【線形分離可能】であり、一定の正の学習率で重みとバイアスを更新しながら全データを繰り返し提示する場合、有限回の誤分類更新の後に、学習データをすべて正しく分類できる重みとバイアスが得られます。これは学習データについての保証であり、未知のデータでの正解を保証するものではありません。(Cornell大学講義資料:収束定理と証明)
一方、学習データが線形分離不可能である場合、この収束は保証されません。
1.4 パーセプトロンの限界とXOR問題
単層パーセプトロンには、
【線形分離可能な問題しか分類できない】
という重要な制約があります。
この限界を理解するために、2つの入力 、 を持つパーセプトロンが、どのようにデータを分類しているのかを数式で確認します。
内部状態は、
です。
出力 が0から1へ切り替わる境界では、内部状態 がちょうど0になります。
したがって、分類境界は、
で表されます。
この式を について解いてみます。
が0でない場合、
です。
したがって、
となります。
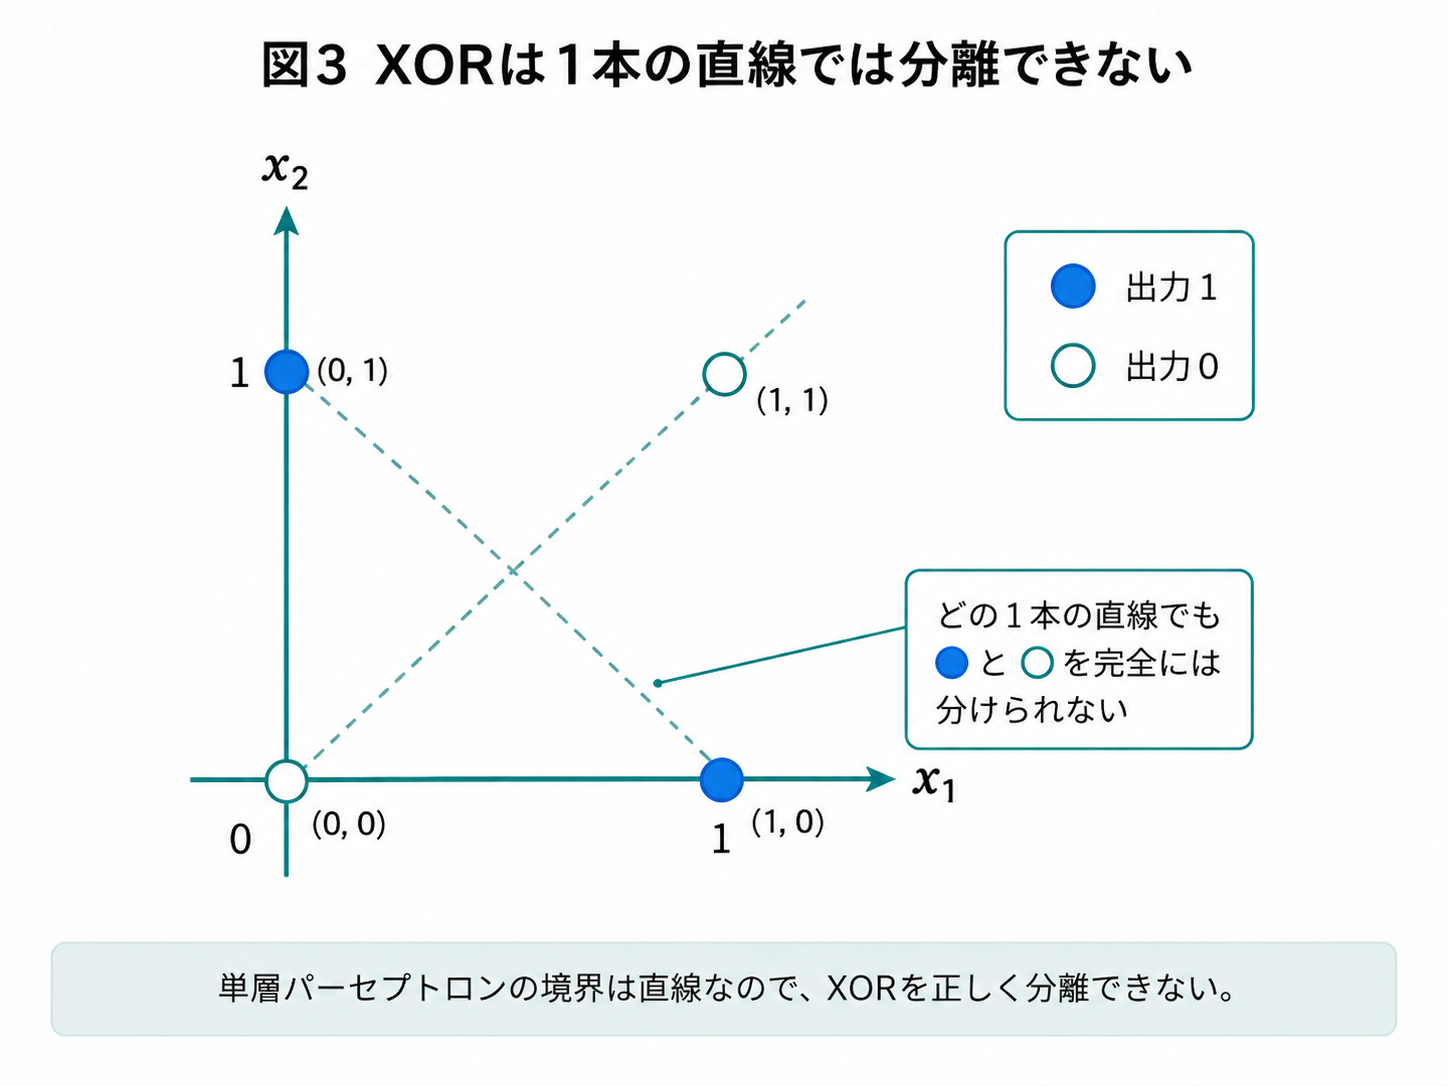
これは、- 平面における【1本の直線】を表す方程式です。
傾きは、
切片は、
です。
つまり、2入力の単層パーセプトロンは、
空間に1本の直線を引き、その直線によって0と1を分類するモデル
と考えることができます。
一般に、入力が 次元の場合、分類境界は、
となり、これは【超平面(hyperplane)】を表します。
XOR(排他的論理和)の数学的証明
XORは、2つの入力が異なる場合のみ1を出力し、同じ場合は0を出力する論理演算です。
| 目標出力 | ||
|---|---|---|
| 0 | 0 | 0 |
| 1 | 0 | 1 |
| 0 | 1 | 1 |
| 1 | 1 | 0 |
単層パーセプトロンがXORを正しく分類できると仮定します。内部状態を とし、 なら 、 なら とします。各入力を代入すると、次の4条件が必要です。
| 条件 | 入力 | 必要な不等式 |
|---|---|---|
| 1 | ||
| 2 | 、すなわち | |
| 3 | 、すなわち | |
| 4 | 、すなわち |
条件2と3を足すと です。一方、条件1の より なので、
となり、条件4の と矛盾します。したがって、4条件を同時に満たす重みとバイアスは存在せず、【単層パーセプトロンではXORを表現できない】ことが示されました。
この結論は、元の2入力をそのまま受け取る単一の線形しきい値分類器についてのものです。複数の形式ニューロンを組み合わせた回路や、中間層を持つネットワークまでXORが表現できない、という意味ではありません。
次章へのつながり
XOR問題から分かる重要なポイントは、
【学習方法をどれだけ工夫しても、モデル自体に十分な表現能力がなければ解けない問題が存在する】
ということです。
単層パーセプトロンの分類境界は、2次元では直線、一般の 次元空間では超平面です。
そのため、XORのような線形分離不可能な問題は、単層パーセプトロンでは正しく分類できません。
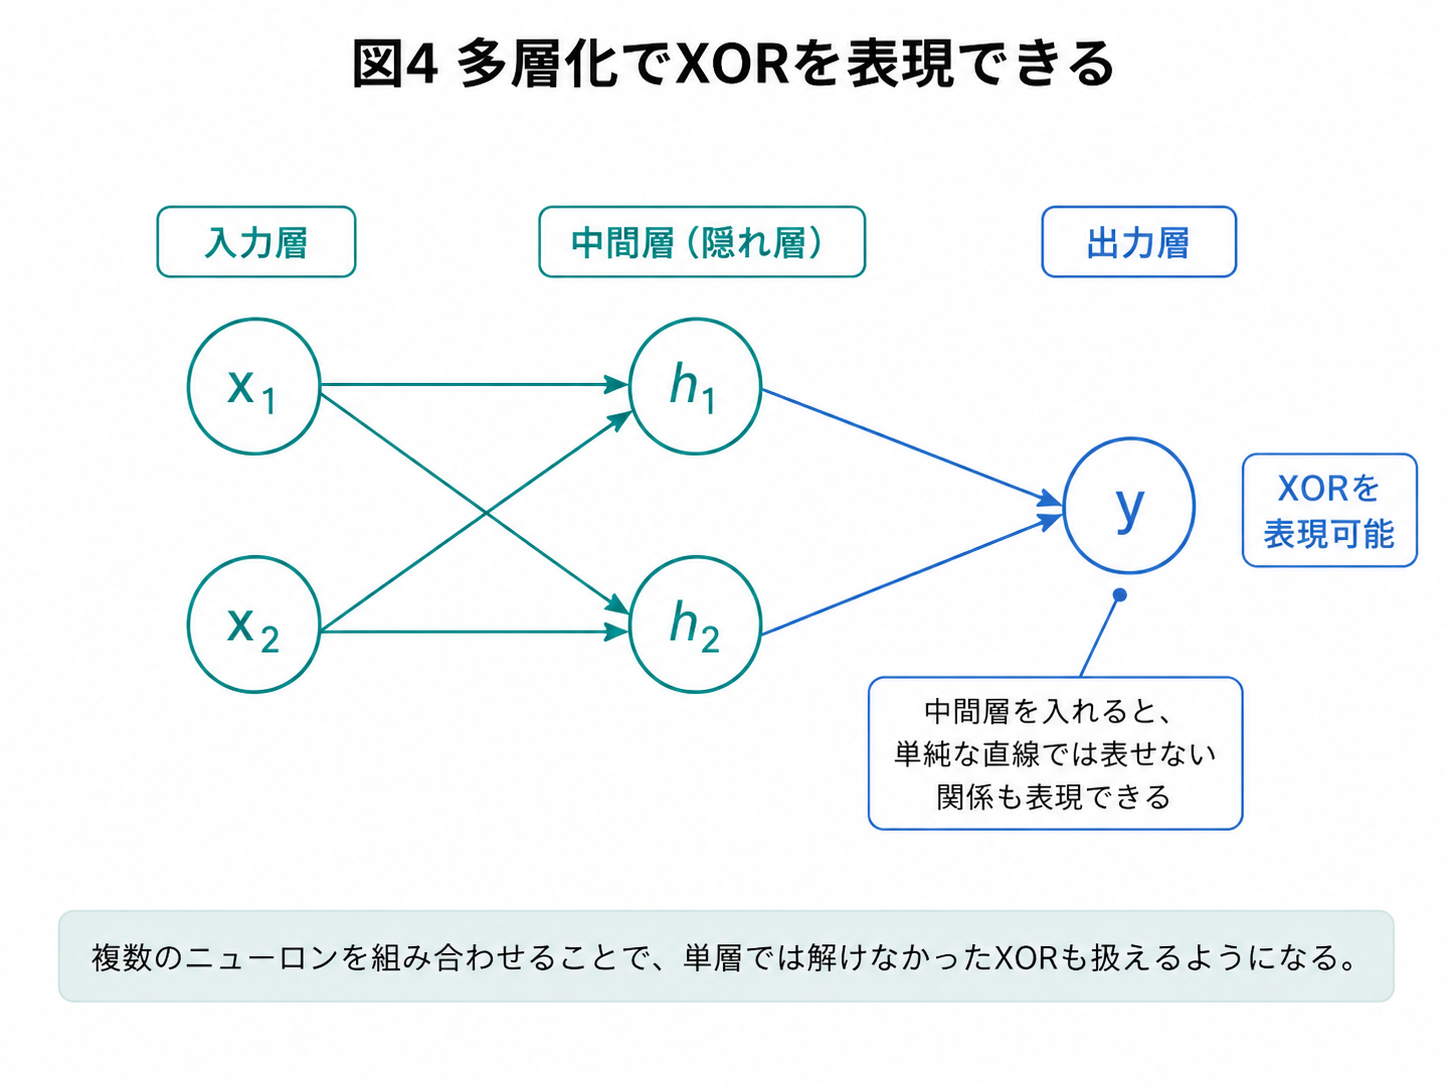
この問題を解決するための重要な考え方が【多層化】です。
例えば、
入力層
  ↓
中間層(隠れ層)
  ↓
出力層
というように複数の層を組み合わせます。
複数のニューロンや層を組み合わせることで、単純な1本の直線だけでは表現できなかった、より複雑な分類境界を表現できるようになります。
しかし、多層化すると新たな問題が生まれます。
それが、
多層ニューラルネットワークの多数の重みを、どのように効率よく学習させるのか
という問題です。
その中心となる手法が【誤差逆伝播法(Backpropagation)】です。
次章では、多層ニューラルネットワークの仕組みと、誤差逆伝播法によってどのように学習が行われるのかを見ていきます。