第0章:前提知識
はじめに
前提知識は四則演算と簡単な文字式です。シリーズの事前読了は不要で、行列や微分は本記事で説明します。
一連の記事「ニューラルネットワークの構造」を、完全な初心者でも読めるようになるためにこの記事を制作しました。
AIの基本的な知識があり、簡単な行列計算や微分ができる人は、この記事を飛ばして「ニューラルネットワークの構造① 単層パーセプトロンができるまで」から読み進めても問題ありません。
ニューラルネットワークを学び始めると、
- 重み
- バイアス
- 関数
- ベクトル
- 行列
- 微分
- 偏微分
- 勾配
といった言葉や記号が登場します。
この記事では、これらを一つずつ確認しながら、
「ニューラルネットワークの記事に出てくる数式を読める」
「簡単な計算なら自分で追える」
状態を目指します。
0.1 AI・機械学習・ニューラルネットワークとは
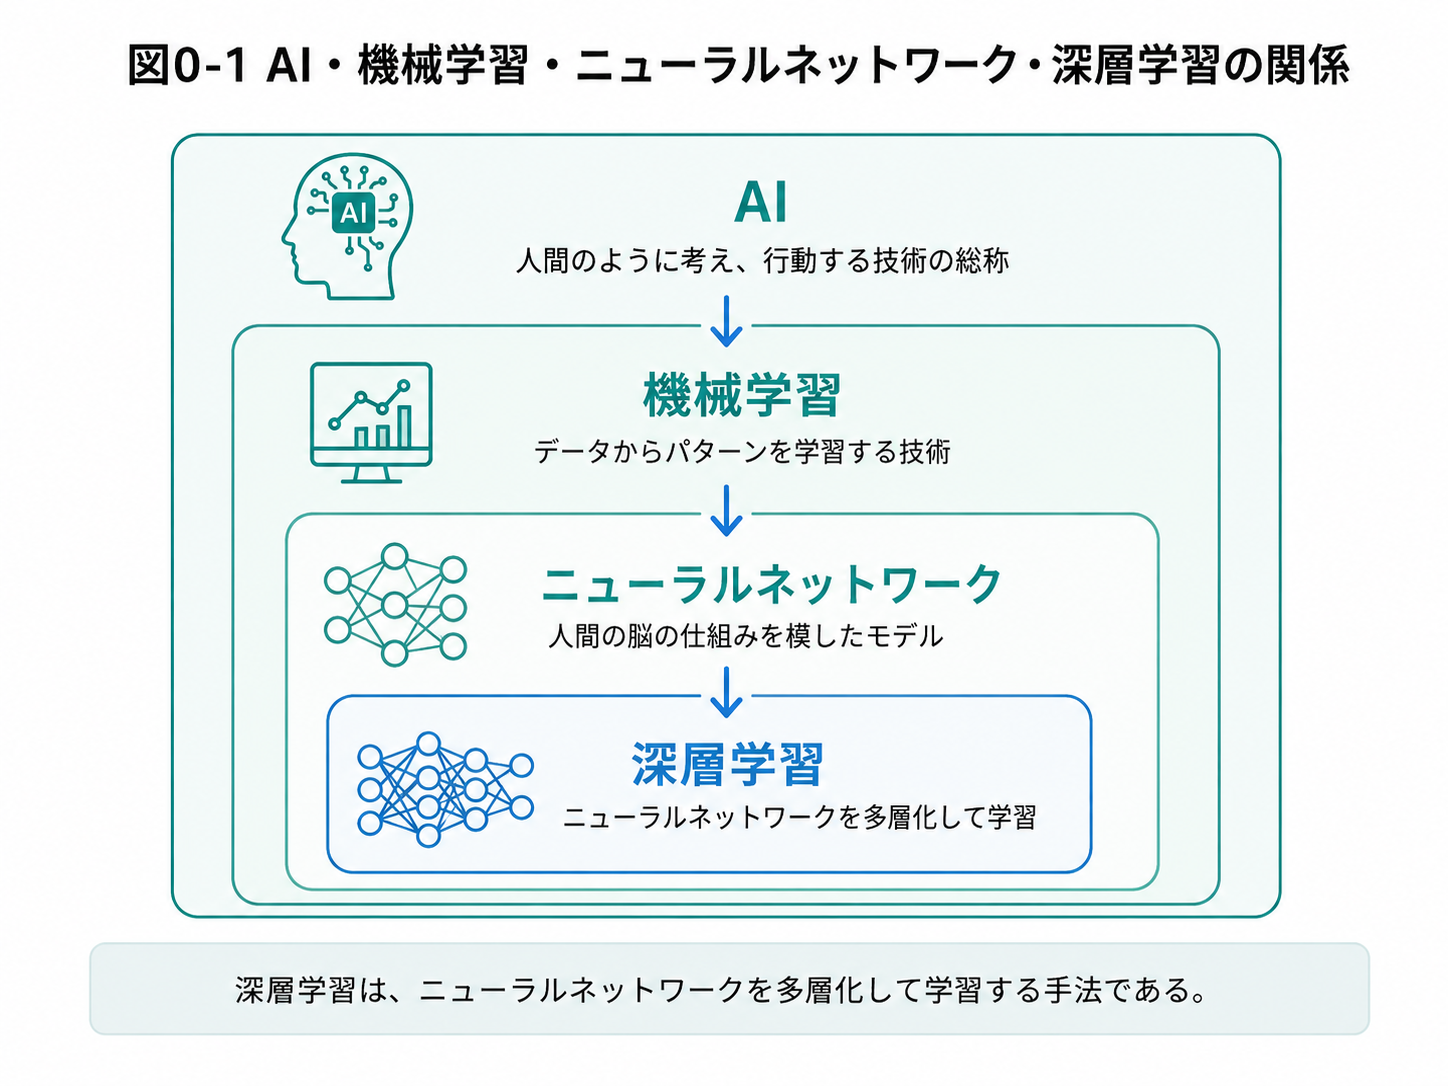
まず、4つの言葉を簡単に整理します。
【AI(人工知能)】
人間が行うような認識・判断・推論などを、コンピュータで実現しようとする技術や研究分野の総称です。
【機械学習】
データを利用して、予測や判断を行うモデルを学習させる技術です。
【ニューラルネットワーク】
機械学習で使われるモデルの一種です。生物の神経細胞の仕組みから着想を得ています。
【深層学習】
多数の層を持つニューラルネットワークを学習させる手法です。
0.2 機械学習は「入力から出力を予測する」
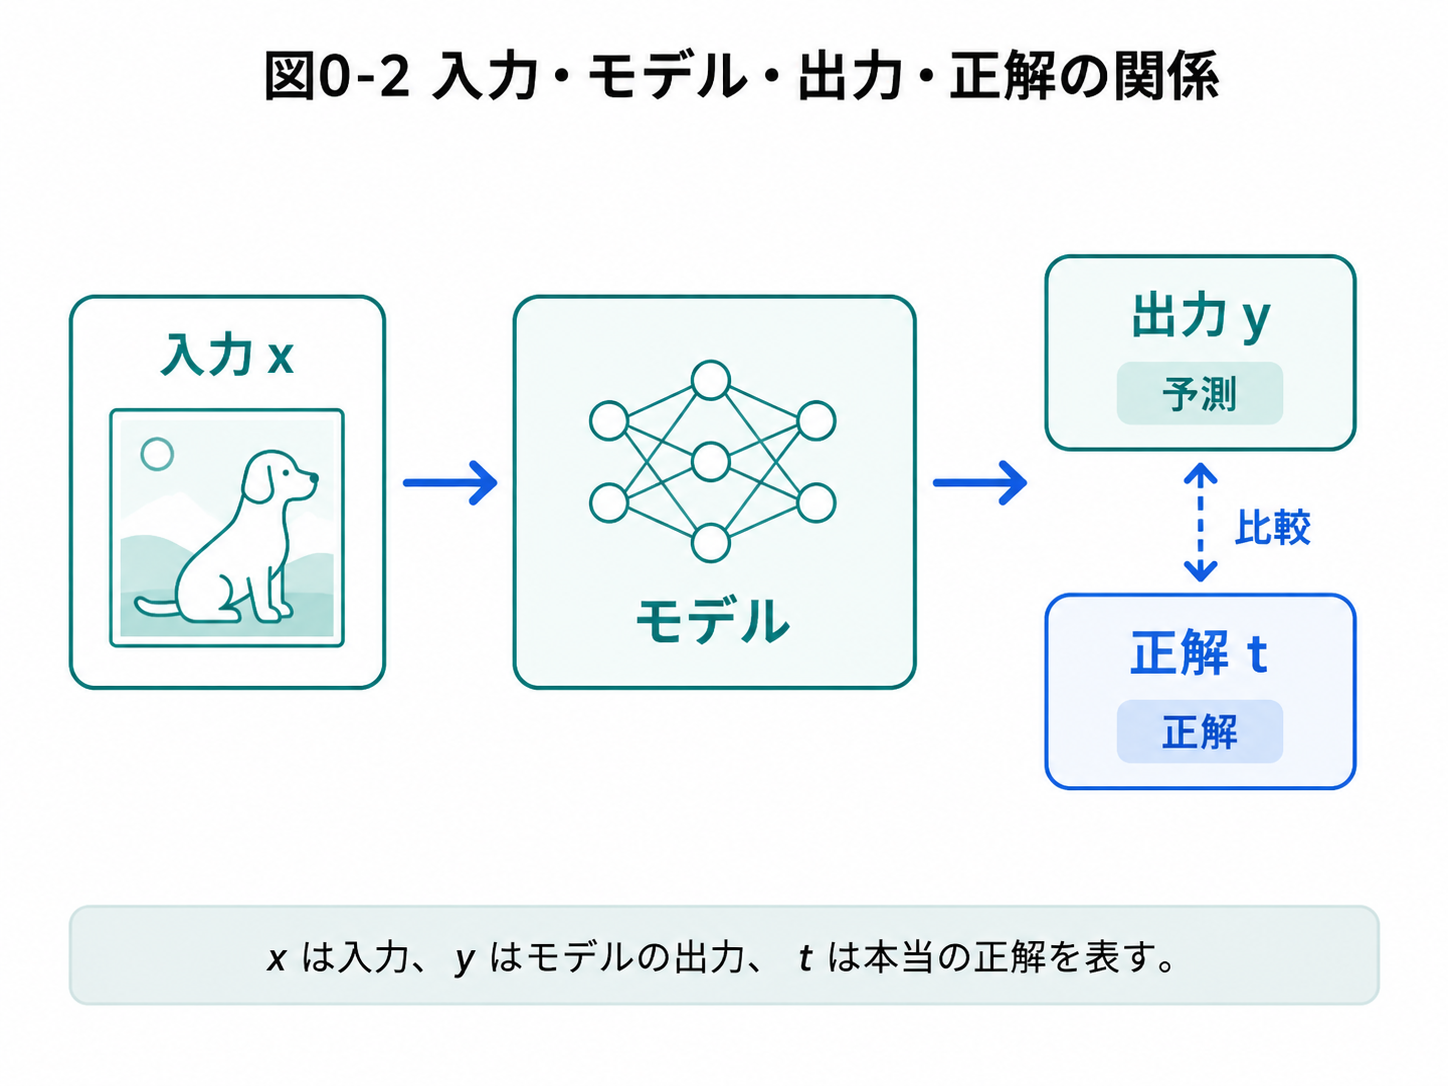
機械学習モデルは、入力を受け取り、何らかの計算を行って出力を返します。
数学では主に、
- x:入力
- y:モデルの予測
- t:本当の正解
と表します。
例えば住宅価格を予測する場合、
- 家の広さ
- 駅からの距離
- 築年数
などが入力になります。
このように、モデルが予測に利用する情報を【特徴量(Feature)】と呼びます。
複数の特徴量がある場合は、
のように番号をつけます。
例えば、
= 家の広さ
= 駅からの距離
= 築年数
というように対応させることができます。
また、データを使ってモデル内部の値を調整する段階を【学習(Training)】、学習済みのモデルを使って新しいデータを予測する段階を【推論(Inference)】と呼びます。
0.3 分類とは何か
【分類(Classification)】とは、入力されたデータをいくつかのグループに分ける問題です。
例えば、
- 犬 / 猫
- 迷惑メール / 通常メール
- 合格 / 不合格
などがあります。
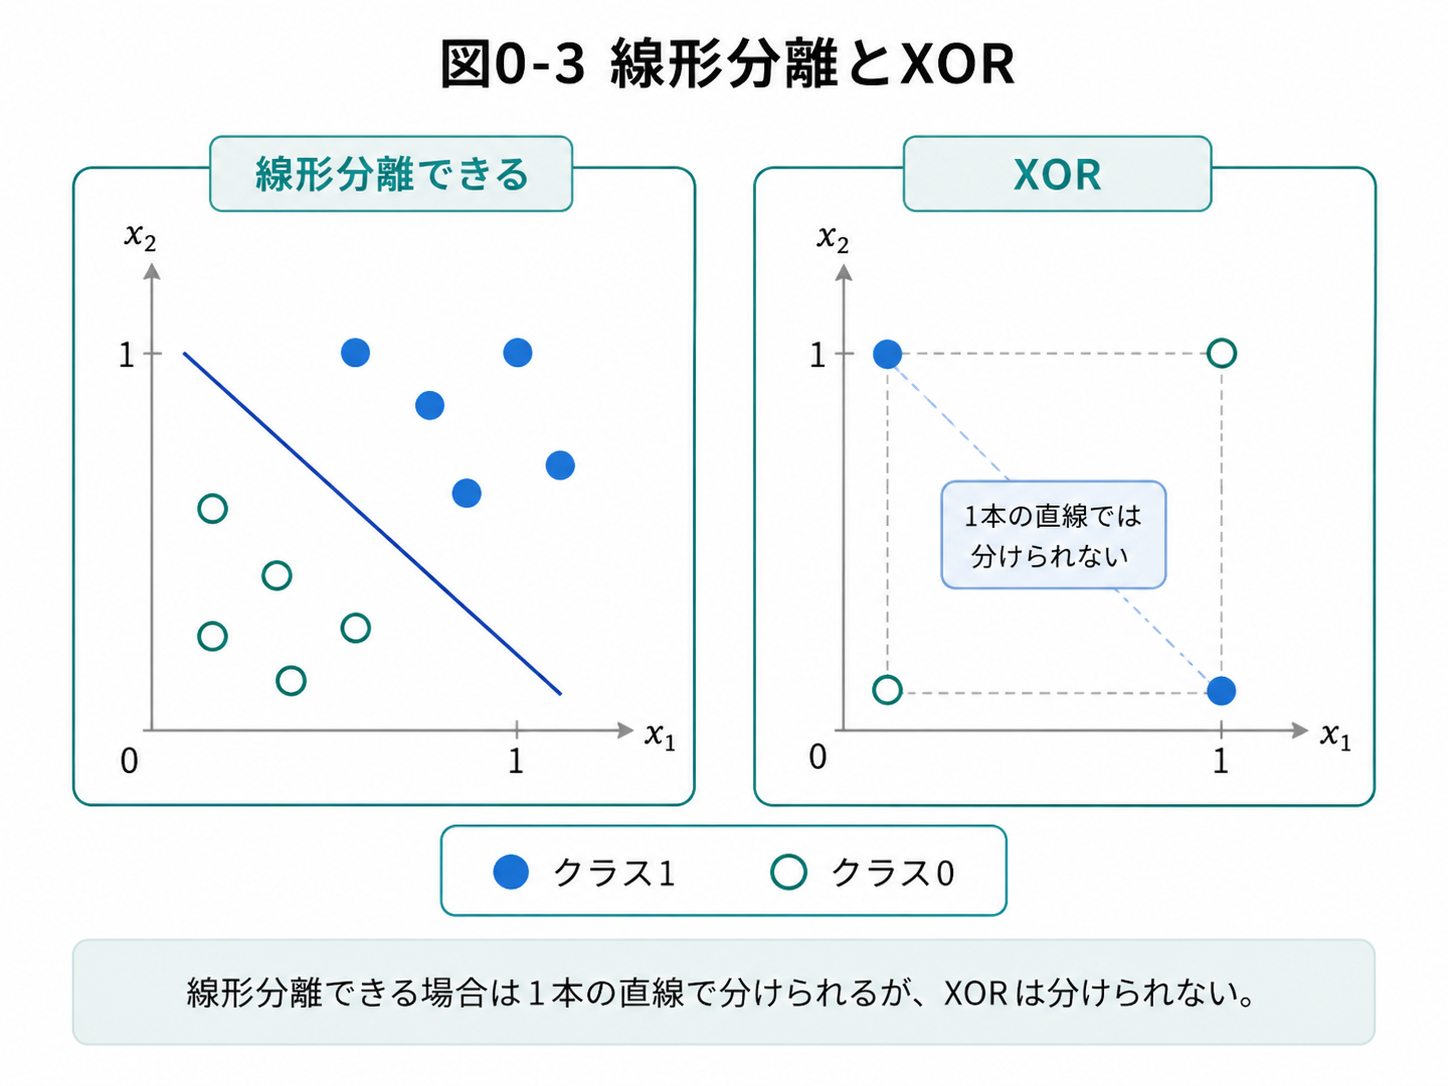
2つの特徴量 、 がある場合、1つのデータを
(, )
という平面上の点として表すことができます。
異なるクラスの点を1本の直線で完全に分けられる場合を【線形分離可能】、分けられない場合を【線形分離不可能】と呼びます。
AND・OR・XOR
ニューラルネットワークの歴史では、AND、OR、XORという論理演算がよく登場します。
入力 、 は、それぞれ0または1を取るとします。
【AND】
両方が1の場合だけ1になります。
| AND | ||
|---|---|---|
| 0 | 0 | 0 |
| 0 | 1 | 0 |
| 1 | 0 | 0 |
| 1 | 1 | 1 |
【OR】
どちらか一方でも1なら1になります。
| OR | ||
|---|---|---|
| 0 | 0 | 0 |
| 0 | 1 | 1 |
| 1 | 0 | 1 |
| 1 | 1 | 1 |
【XOR】
2つの入力が異なる場合だけ1になります。
| XOR | ||
|---|---|---|
| 0 | 0 | 0 |
| 0 | 1 | 1 |
| 1 | 0 | 1 |
| 1 | 1 | 0 |
ANDやORは1本の直線で0と1を分離できますが、XORは1本の直線では分離できません。
この性質が、次の記事で単層パーセプトロンの限界を考えるときに重要になります。
0.4 関数とは何か
【関数】とは、入力を受け取り、決められたルールに従って出力を返すものです。
例えば、
f(x) = 2x
という関数を考えます。
x = 3 を入力すると、
f(3) = 6
となります。
数学では、
y = f(x)
と書き、
「xを関数 f に入力すると、結果として y が出力される」
ことを表します。
ニューラルネットワークも、大きく見れば「入力を受け取って出力を返す関数」と考えることができます。
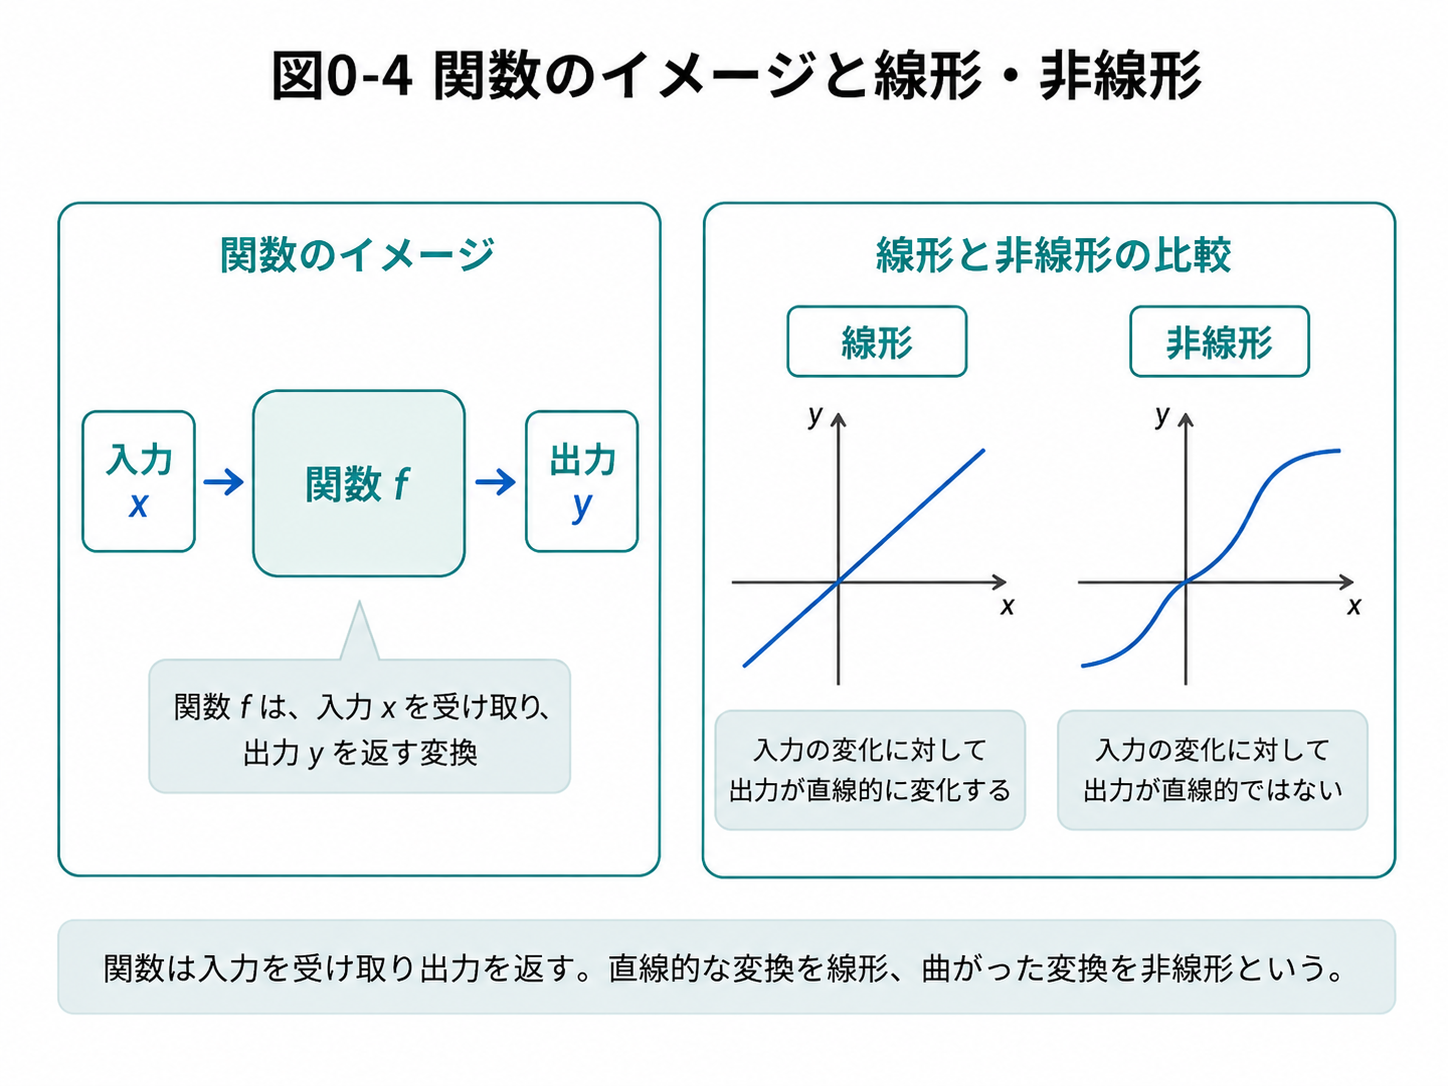
今後は【線形】と【非線形】という言葉も頻繁に登場します。
ここではまず、
- 線形的な処理:入力を足したり、定数倍したりする処理
- 非線形な処理:それだけでは表せない、曲がりや折れ曲がりを生む処理
というイメージを持っておけば十分です。
なお、数学的には y = ax + b のように b を含む変換は厳密には「アフィン変換」と呼ばれます。
ニューラルネットワークでは、
Wx + b
というアフィン変換と、非線形な活性化関数を組み合わせて使います。
0.5 ニューラルネットで使う数式の読み方
1. 添字
例えば、
は、
1番目の入力
2番目の入力
3番目の入力
を表します。
一般に、
と書けば「i番目の入力」という意味です。
同様に、
なら、1番目、2番目、3番目の重みを表します。
2. Σ(シグマ)
Σは、
【指定された範囲の値をすべて足す】
という意味です。
例えば、
は、
という意味です。
また、
なら、
です。
したがって、
という式を見たら、
「それぞれの入力 に重み を掛け、それを全部足している」
と考えれば大丈夫です。
3. ←
例えば、
という式は、
【現在の w を、w + 1 という新しい値に置き換える】
という意味です。
プログラムで書く、
w = w + 1
とほぼ同じ意味です。
機械学習では、重みなどのパラメータを何度も更新するため、この記号がよく使われます。
4. ベクトル
複数の数字をひとまとめにしたものを【ベクトル】と呼びます。
例えば、
は、 と という2つの数字を1つにまとめたものです。
5. 行列
数字を縦横に並べたものを【行列】と呼びます。
例えば、
です。
ニューラルネットワークでは、大量に存在する重みを行列 W としてまとめて扱います。
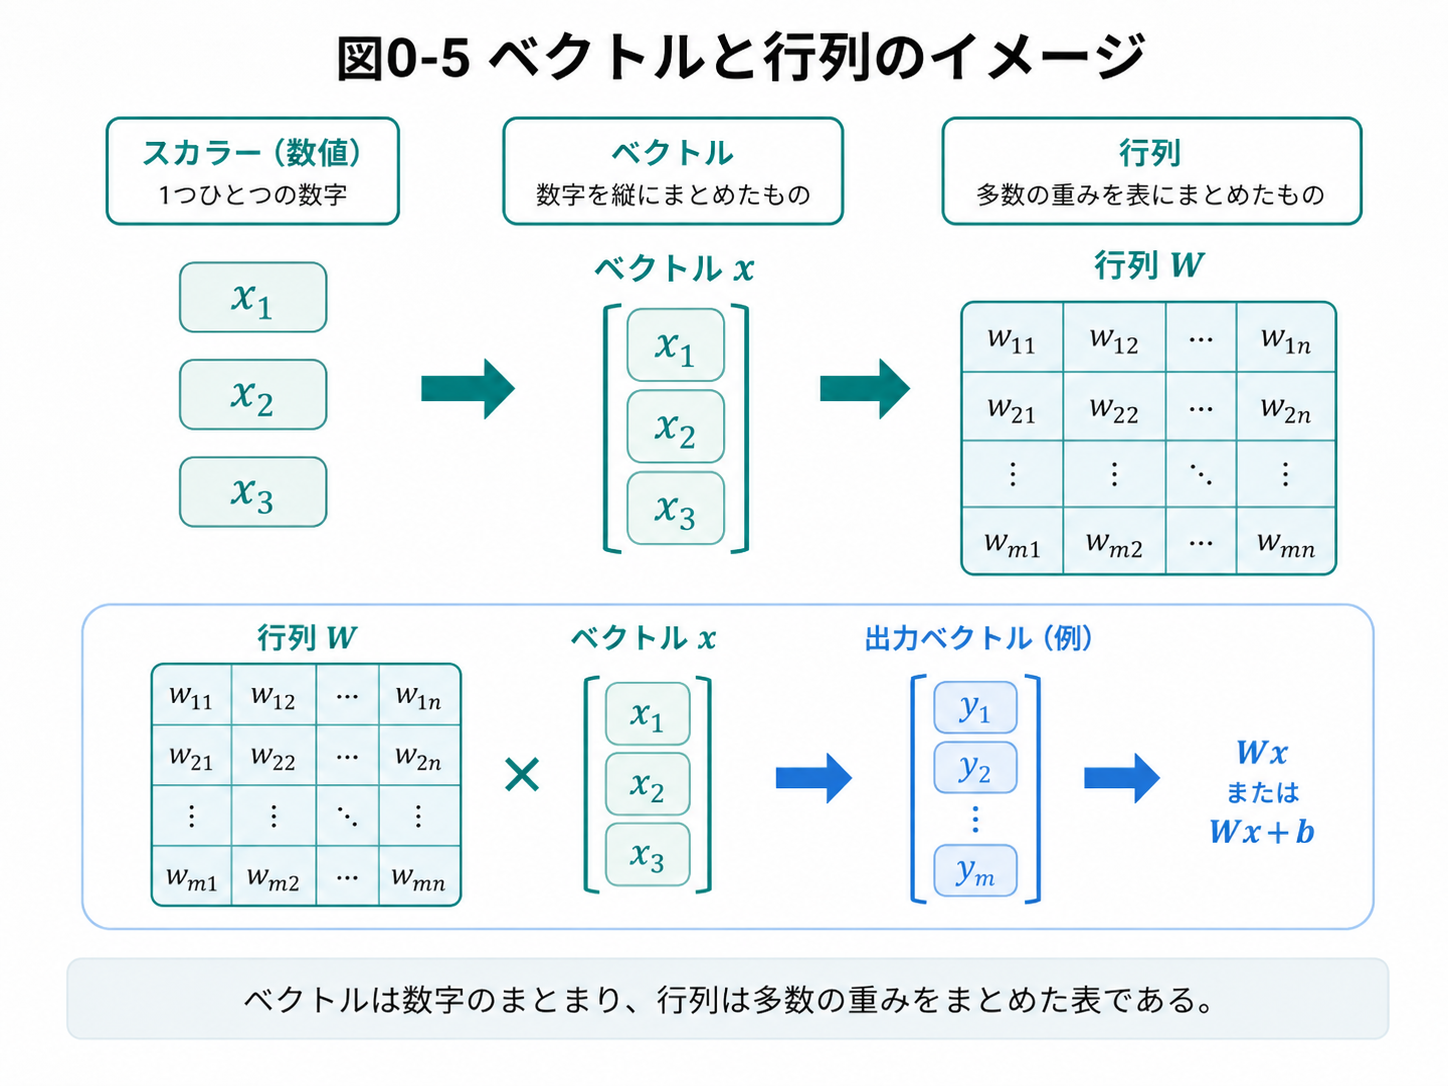
行列とベクトルを実際に掛けてみる
例えば、
とします。
計算したいのは、
です。
行列とベクトルを掛けるときは、
【行列の1行と、ベクトルの各要素を掛けて足す】
と考えます。
まず1行目です。
なので、
です。
次に2行目です。
なので、
です。
したがって、
となります。
つまり、
【行 × 列】
の組み合わせで計算します。
バイアスを加える
さらに、
とすると、
なので、
となります。
この、
という形は、ニューラルネットワークで何度も登場します。
行列同士の掛け算
行列同士でも、基本は同じく【行 × 列】です。
例えば、
とします。
AB の左上は、
右上は、
左下は、
右下は、
です。
したがって、
となります。
ここでは、
【行列の掛け算は、左側の行と右側の列を掛け合わせて足す】
と覚えておけば十分です。
0.6 「学習」とはパラメータを変えること
ニューラルネットワークでは、
のような計算が基本になります。
ここで、
- x:入力
- y:出力
- w:重み
- b:バイアス
です。
w や b のように、学習によって調整される値を【パラメータ(Parameter)】と呼びます。
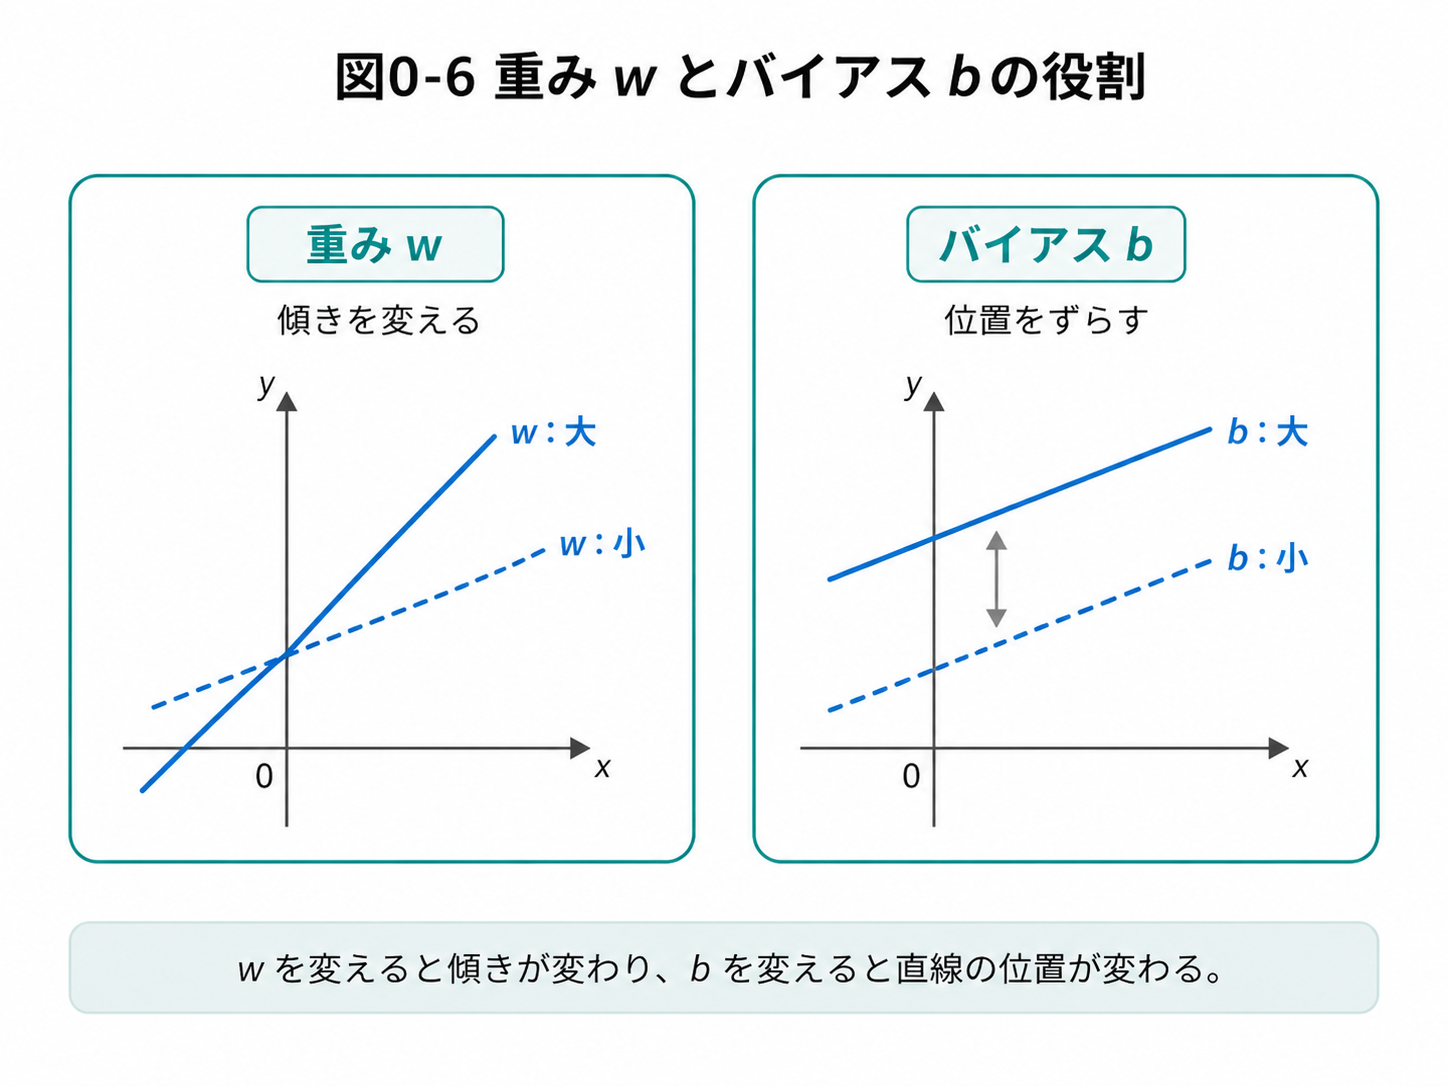
機械学習における【学習】とは、予測が正解に近づくように、w や b などのパラメータを少しずつ調整することです。
0.7 微分とは何か
【微分】は、その場所での関数の変化の割合、つまり【傾き】を求める計算です。
は、
「xを少し変えたとき、yがどれくらい変化するか」
を表します。
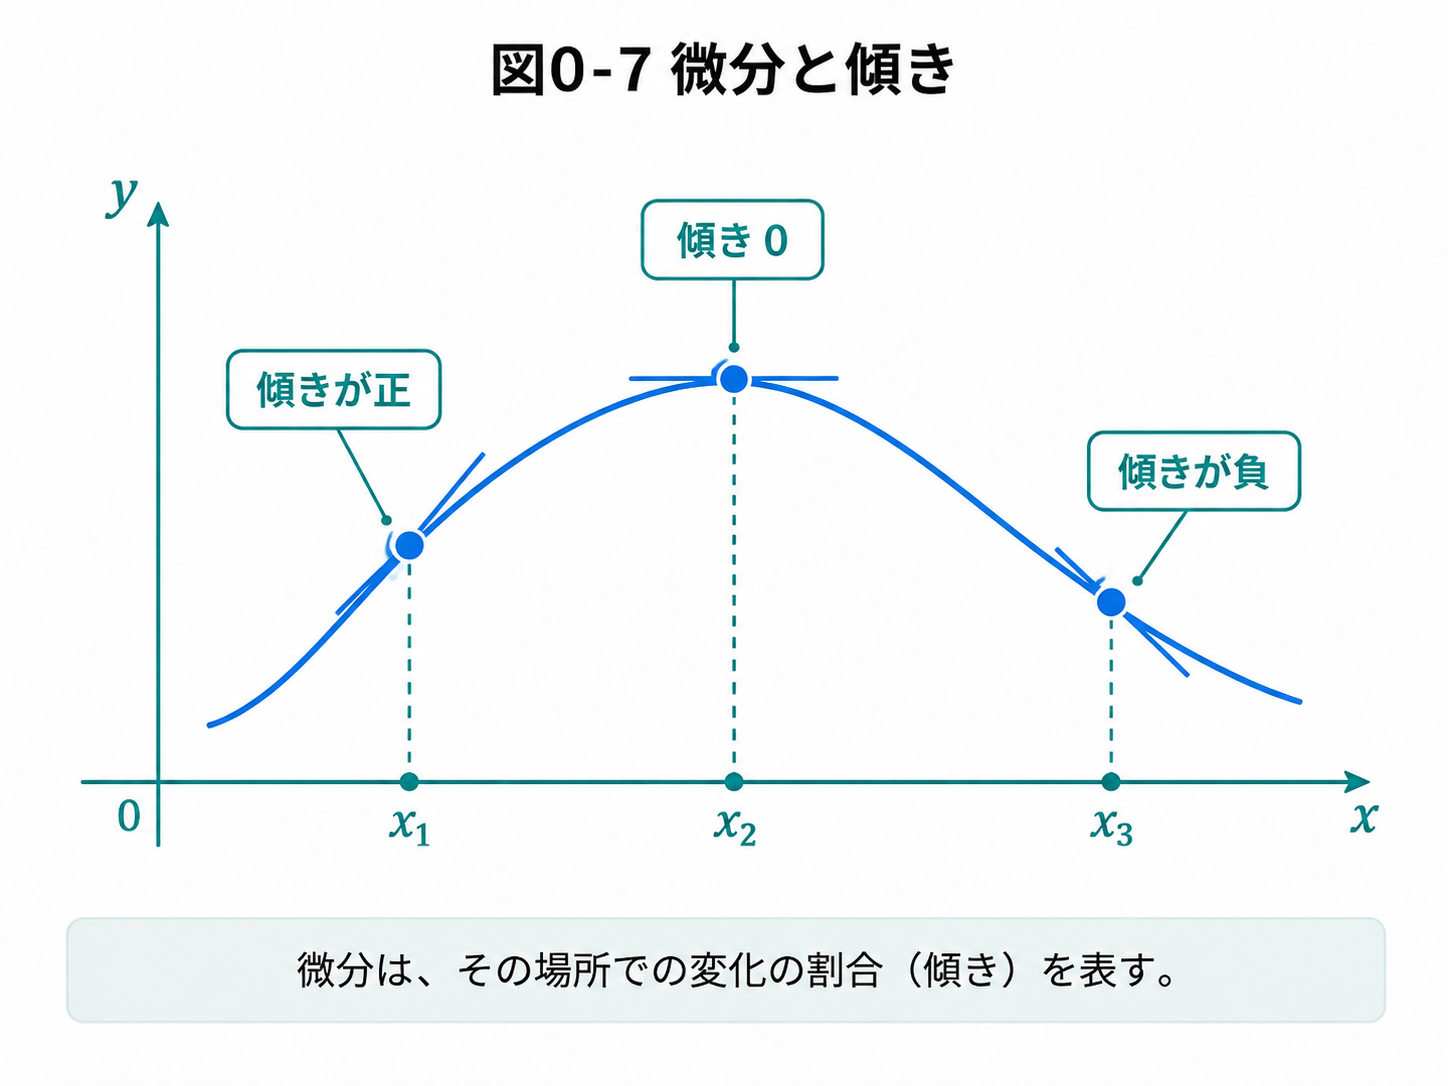
微分を実際に計算する
例えば、
を考えます。
これを x について微分すると、
となります。
例えば x = 3 の場所では、
です。
つまり、その場所での傾きは6です。
べき乗の微分
まず覚えておきたい基本公式は、
です。
例えば、
となります。
定数の微分
定数は、xを変えても値が変わらないため、微分すると0になります。
例えば、
を微分すると、
です。
5の部分は微分すると0になります。
足し算の微分
複数の項が足されている場合、それぞれを別々に微分できます。
例えば、
なら、
となります。
x² の微分は 2x、
3x の微分は 3、
5 の微分は 0
だからです。
0.8 偏微分・勾配・連鎖律
偏微分
ニューラルネットワークには大量のパラメータがあります。
そのため、複数の変数のうち1つだけに注目して微分する【偏微分】を使います。
例えば、
という関数を考えます。
w について偏微分するときは、x と b を定数として扱います。
したがって、
です。
一方、b について偏微分すると、
となります。
偏微分をもう1つ計算してみる
例えば、
という関数を考えます。
について偏微分すると、 を定数として扱うため、
となります。
について偏微分すると、
です。
このように、
【どの変数について微分するのか】
を指定するのが偏微分です。
勾配
すべてのパラメータについて偏微分した結果をまとめたものを【勾配(Gradient)】と呼びます。
例えば、
なら、
なので、勾配は、
と表せます。
勾配は、
【関数の値が最も急激に増える方向】
を示します。
機械学習では損失を小さくしたいため、その逆方向へパラメータを動かします。
これが後に登場する【勾配降下法】の基本です。
連鎖律
ニューラルネットワークでは、1つの計算結果が次の計算へ渡されます。
例えば、
w
→
y
→
L
という関係があるとします。
w が変わると y が変わり、その結果 L も変わります。
このような「影響のつながり」を計算する方法が【連鎖律(Chain Rule)】です。
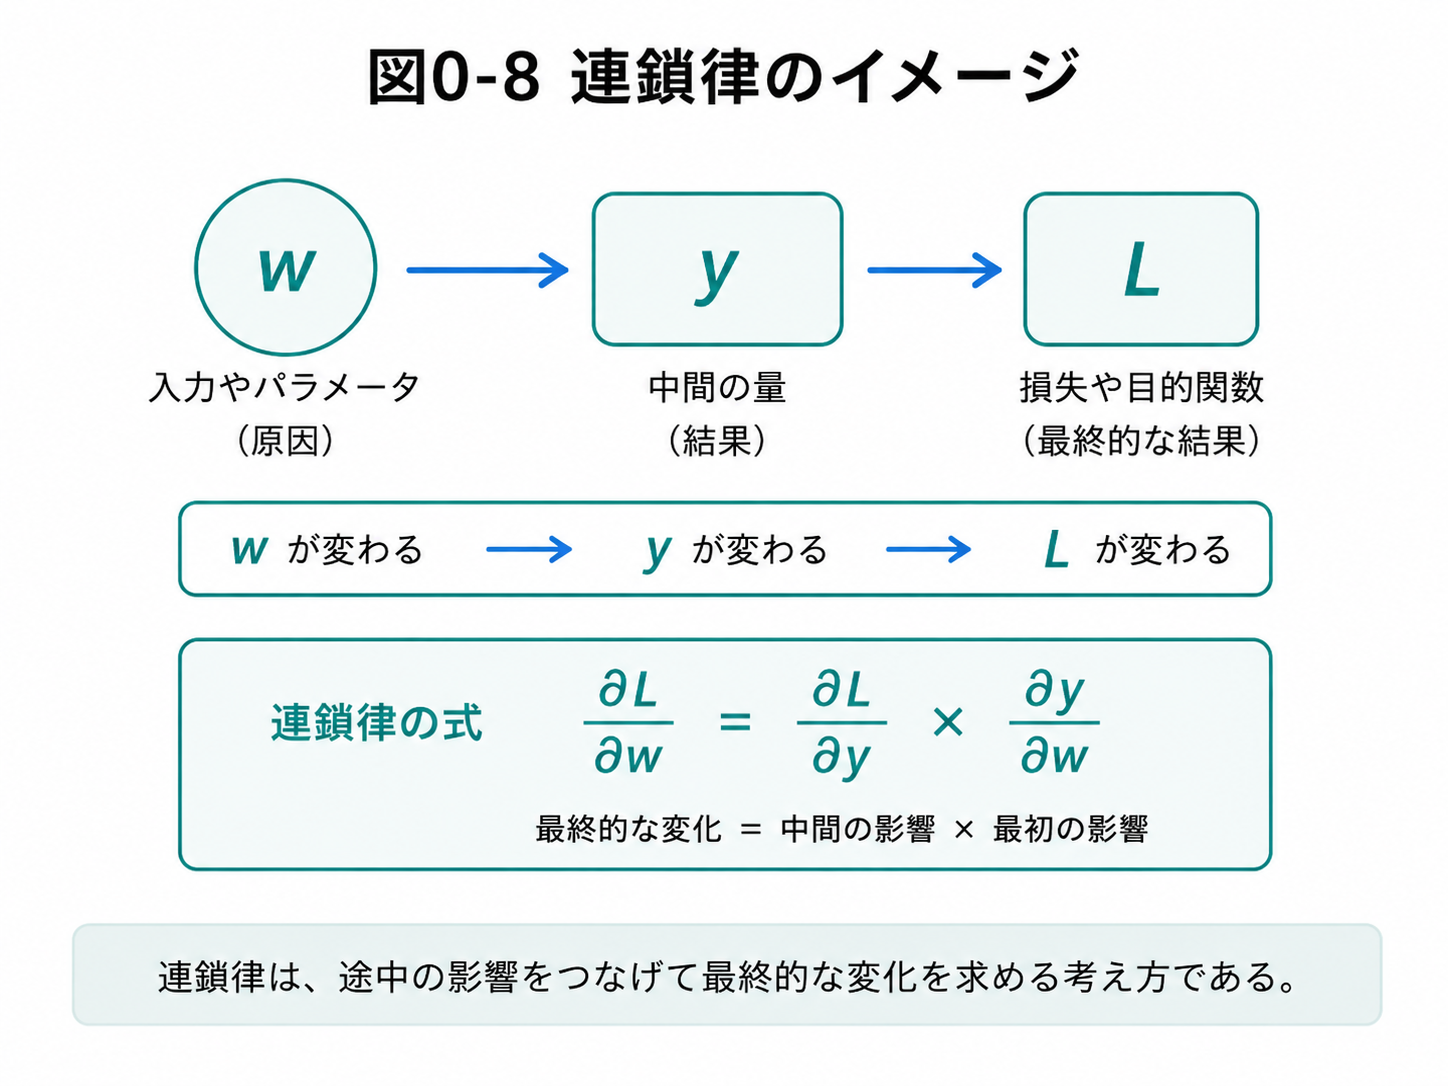
例えば、
そして、
とします。
求めたいのは、
です。
連鎖律を使うと、
と分解できます。
まず、
を y について微分します。
となります。
また、
なので、
です。
したがって、
となります。
これが連鎖律です。
数字を入れて計算してみる
例えば、
x = 2
w = 3
b = 1
t = 10
とします。
まず予測 y は、
なので、
です。
正解は t = 10 なので、
となります。
先ほど求めた、
に代入すると、
です。
バイアスについては、
で、
なので、
となります。
つまり、
です。
パラメータを更新する
例えば学習率を、
とします。
重みは、
によって更新します。
数字を代入すると、
なので、
となります。
バイアスも、
なので、
となります。
つまり、
w:3 → 3.6
b:1 → 1.3
と更新されました。
このように、
【予測する → 誤差を求める → 微分する → パラメータを更新する】
という処理を繰り返すことで、モデルを学習させます。
この連鎖律が、多層ニューラルネットワークで使われる【誤差逆伝播法(Backpropagation)】の基礎になります。
0.9 ニューラルネットワークの学習を先に眺めてみる
ここまでの内容をまとめると、ニューラルネットワークの学習は、
【予測する → 間違いを測る → パラメータを修正する】
という処理の繰り返しです。
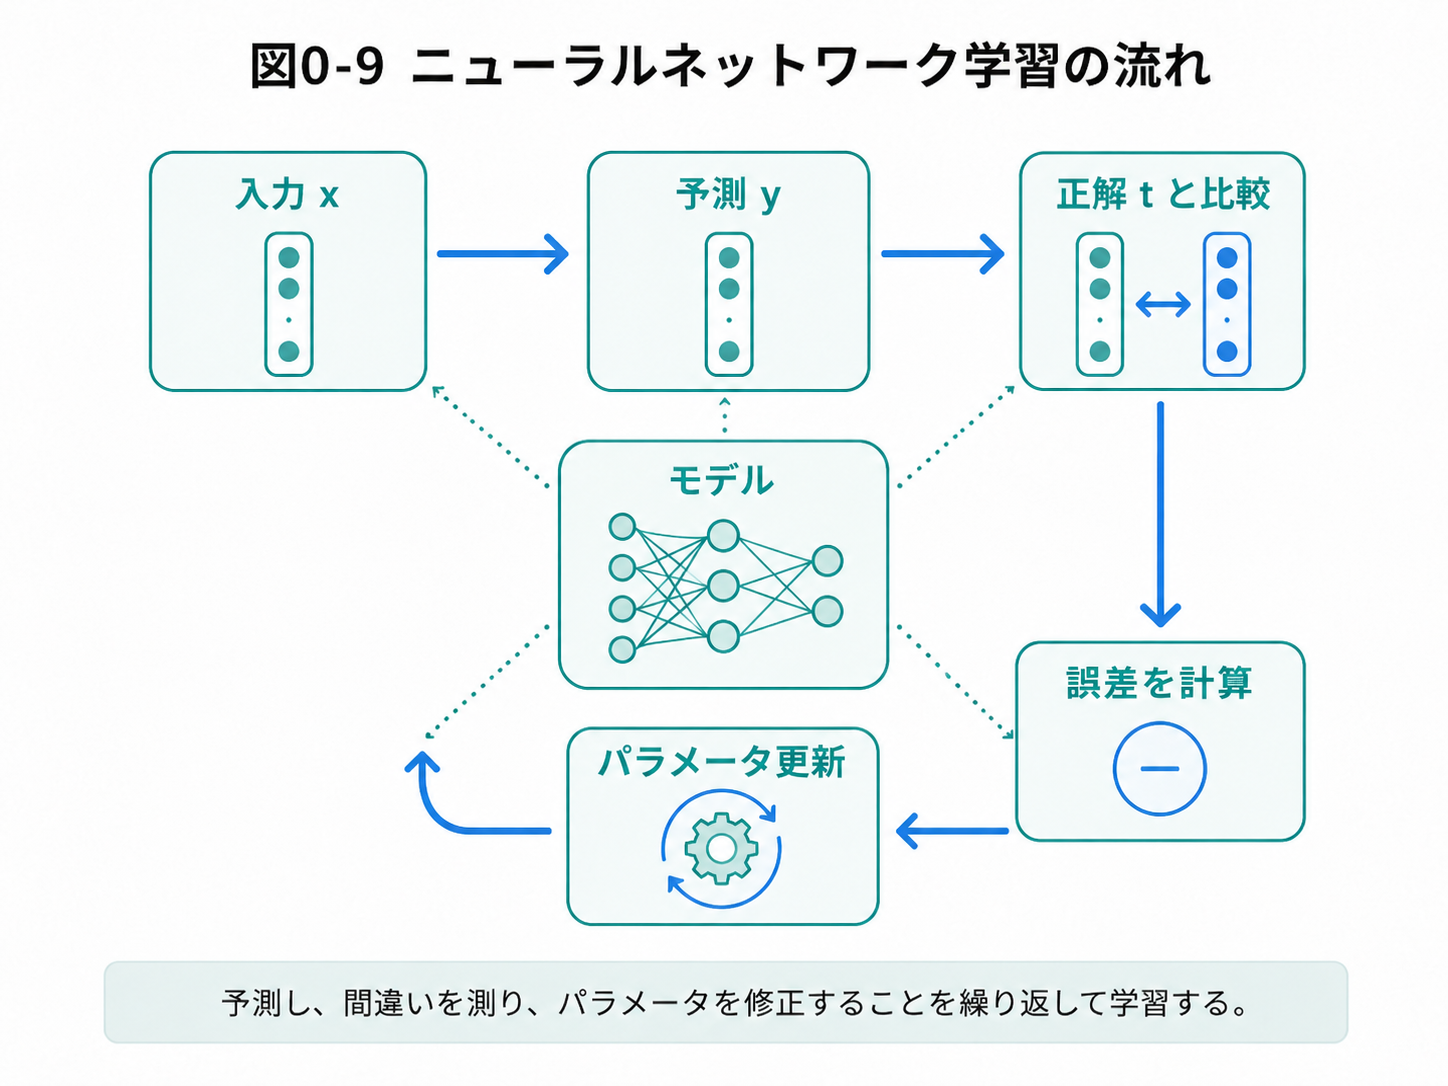
ネットワークが複雑になっても、この基本的な流れは変わりません。
0.10 ここまでで覚えておきたいこと
この記事で特に覚えておきたい記号は、
- x:入力
- y:モデルの予測
- t:正解
- w:重み
- b:バイアス
です。
また、
【パラメータ】
学習によって調整する値。
【関数】
入力を受け取り、何らかの計算をして出力を返すもの。
【ベクトル】
複数の数字をまとめたもの。
【行列】
数字を縦横に並べたもの。
【微分】
ある変数を少し変えたとき、関数がどれくらい変化するかを調べるもの。
【偏微分】
複数の変数のうち、1つに注目して微分すること。
【勾配】
各パラメータについての偏微分をまとめたもの。関数が最も急激に増える方向を示す。
【連鎖律】
複数の計算を経由する影響を、順番につなげて計算する方法。
という意味も押さえておいてください。
すべてを暗記する必要はありません。
次の記事以降でも、実際に使いながらもう一度確認していきます。
次回:ニューラルネットワークの構造① 単層パーセプトロンができるまで
ここまでで、
入力
出力
関数
分類
線形分離
ベクトル
行列
重み
バイアス
微分
といった基本的な考え方を確認しました。
次の記事では、
【1個の人工ニューロンは、どのように情報を処理するのか】
というところからニューラルネットワークの仕組みを見ていきます。
生物のニューロンを単純化した【形式ニューロン】から始め、
形式ニューロン
↓
ヘブ則
↓
パーセプトロン
↓
誤差訂正学習
↓
線形分離
↓
XOR問題
という流れで、
ニューラルネットワークがどのように「学習するモデル」へ発展していったのかを見ていきます。