第2章:多層パーセプトロン
2.1 多層化によるXOR問題の解決
単層パーセプトロンがXOR(排他的論理和)を解けない数学的理由は、入力空間に対して1つの線形境界(直線)しか引けないためでした。この問題を解決するためには、入力層と出力層の間に中間層(隠れ層)を追加し、ネットワークを多層化(Multi-layer)する必要があります。
多層化の数学的な本質は、「入力空間の座標を、線形分離可能な新しい座標空間へ変換(写像)すること」にあります。
多層パーセプトロンの数理モデル
入力層(2ユニット)、中間層(2ユニット)、出力層(1ユニット)からなる2層のパーセプトロンを定義します。
入力ベクトルを 、中間層への重み行列を 、バイアスベクトルを とします。中間層の出力ベクトル は、ステップ関数 を用いて以下のように計算されます。
さらに、出力層への重みベクトルを 、バイアスを とすると、最終的な出力 は以下のように計算されます。
XORを解く具体的なパラメータ行列
XOR演算は、論理積(AND)、論理和(OR)、否定論理積(NAND)の組み合わせによって と表現できます。これを行列とベクトルに落とし込んでみましょう。
中間層の1つ目のユニット にORゲートの役割を、2つ目のユニット にNANDゲートの役割を持たせます。出力層のユニット にはANDゲートの役割を持たせます。各パラメータを以下のように設定します。
空間変換の証明(真理値表)
設定したパラメータに基づき、4つの入力パターンが中間層 でどのように変換され、最終出力 に至るかを計算します。
| 入力 | 入力 | 中間出力 (OR) | 中間出力 (NAND) | 最終出力 (AND) |
|---|---|---|---|---|
| 0 | 0 | 0 | 1 | 0 |
| 1 | 0 | 1 | 1 | 1 |
| 0 | 1 | 1 | 1 | 1 |
| 1 | 1 | 1 | 0 | 0 |
【数学的考察】
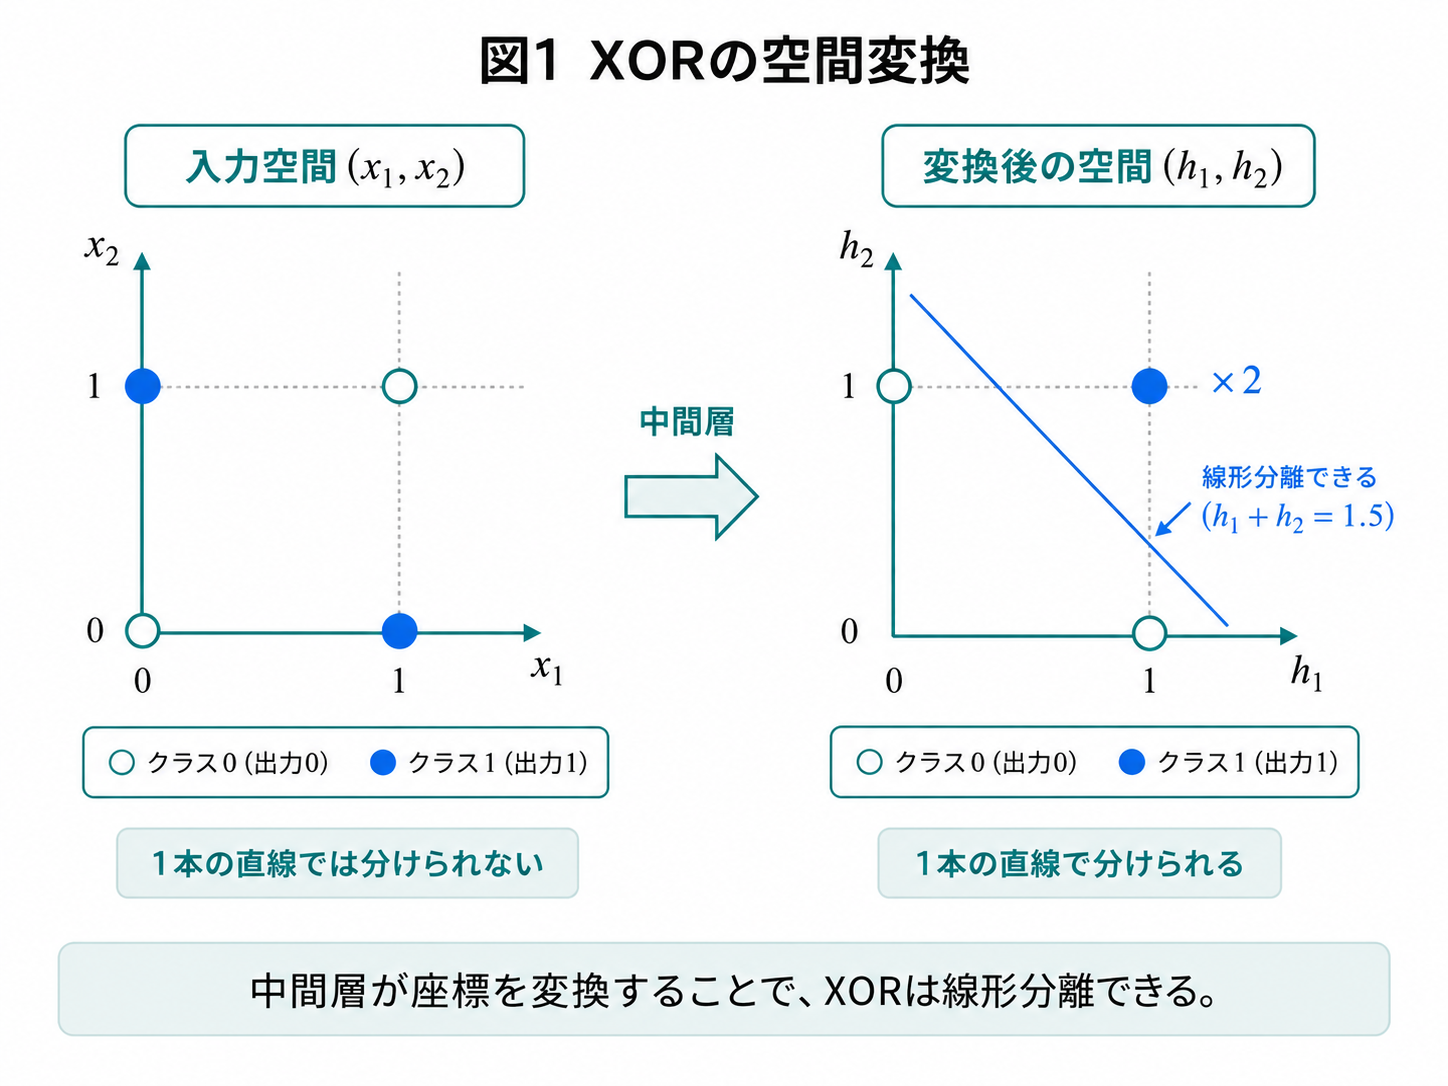
元の入力空間 において、出力が1となる座標 と は、出力が0となる座標 と に対角線上に配置されており、直線で分離不可能でした。
しかし、中間層による一次変換と非線形変換(ステップ関数)を経た新しい座標空間 を見てください。
出力が1となるデータは共に座標 に重なり、出力が0となるデータは座標 と に移動しています。この新しい空間であれば、最後のANDゲートによって という1本の直線で完全に線形分離することが可能になります。
これが、多層化(ニューラルネットワークの深層化)が非線形問題を解決できる数学的な理由です。
2.2 損失関数と勾配降下法の数学的詳細
2.1節では、適切な重み行列 が与えられれば多層パーセプトロンが非線形分離(XOR)を解けることを確認しました。ディープラーニングの学習とは、この最適なパラメータ行列をデータから自動的に算出する「数理最適化問題」を解くことに他なりません。
その最適化の要となるのが損失関数(Loss Function)と勾配降下法(Gradient Descent)です。
1. 損失関数(二乗誤差)の数学的必然性
ネットワークの出力 と、正解の教師データ との誤差を測る際、単純な引き算 では正の誤差と負の誤差が相殺されてしまうという問題があります。また、絶対値 は の点で微分不可能(尖点を持つ)であるため、微積分を用いた最適化には不向きです。
そのため、微分可能かつ誤差を常に正の値として評価できる二乗誤差(Squared Error)が標準的な損失関数 として採用されます。
ここで、先頭の は数学的な便宜のための係数です。この関数 を について微分した際、肩の数字の が前に出て と相殺され、導関数がシンプルに となるように設計されています。
2. 偏微分と合成関数の微分(チェインルール)
学習の目的は、損失 が最小(極小値)となるパラメータ を求めることです。そのためには、「 を微小量変化させたとき、 がどれだけ変化するか」を示す偏微分 (勾配)を計算する必要があります。
しかし、 の式には直接 が含まれていません。実際には、出力 が の関数であり()、 はその の関数であるという「合成関数」の構造を持っています。
したがって、高校数学で学ぶ合成関数の微分(連鎖律:Chain Rule)を用いて、以下のように分解して偏微分を計算します。
- 第一項 は、損失関数 を で微分したもので、 となります。
- 第二項 は、出力関数 を で微分したもので、 となります。
これらを掛け合わせることで、勾配は極めてシンプルに求められます。
(※これは1.3節で学んだパーセプトロンの誤差訂正学習の式 と本質的に同じ構造であることが数学的に証明できます。)
3. 勾配降下法によるパラメータの更新
求めた勾配 は、「現在の の位置において、関数の値 が最も急激に増加する方向と割合」を表します。我々の目的は を「減少(最小化)」させることであるため、勾配の逆符号をパラメータに加算します。
ここで、(イータ)は学習率(Learning Rate)と呼ばれる正の定数です。
この数式が最適化においてどう振る舞うかを分類します。
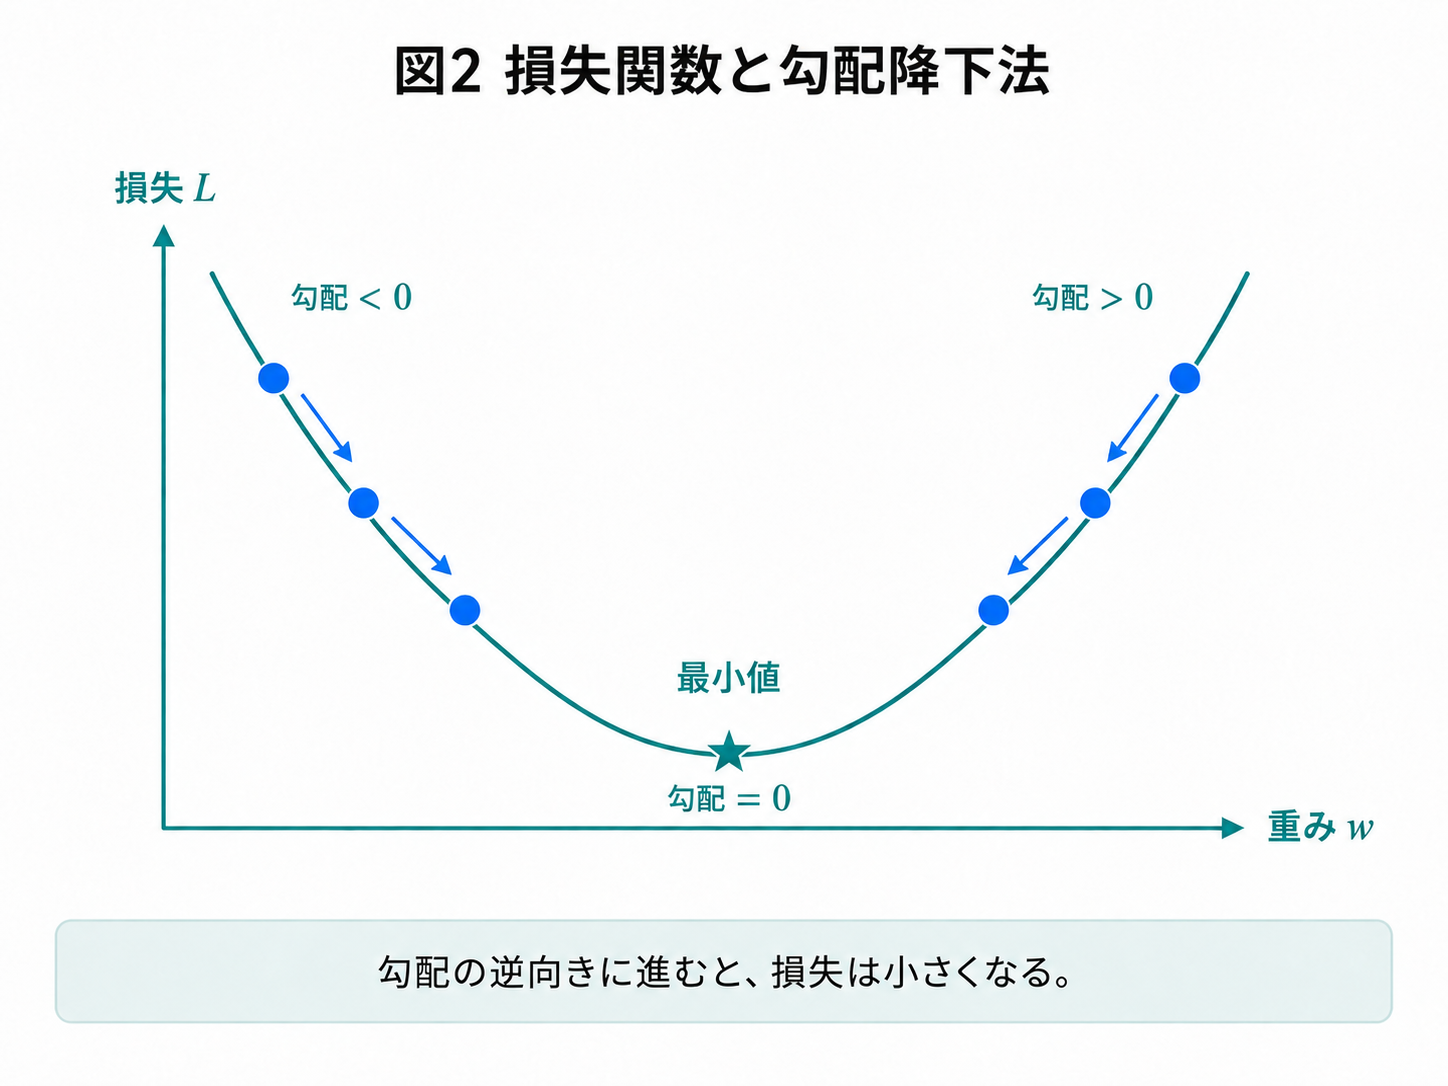
- (傾きが正)の領域: が極小値より右側にあります。更新式は となるため、 は減少し、左(極小値の方向)へ移動します。
- (傾きが負)の領域: が極小値より左側にあります。更新式は すなわち加算となるため、 は増加し、右(極小値の方向)へ移動します。
- (傾きがゼロ)の点: 更新量が となり、学習が収束(完了)します。
4. 活性化関数と微分のジレンマ
このように、微積分を用いることでパラメータの自動最適化が可能になります。
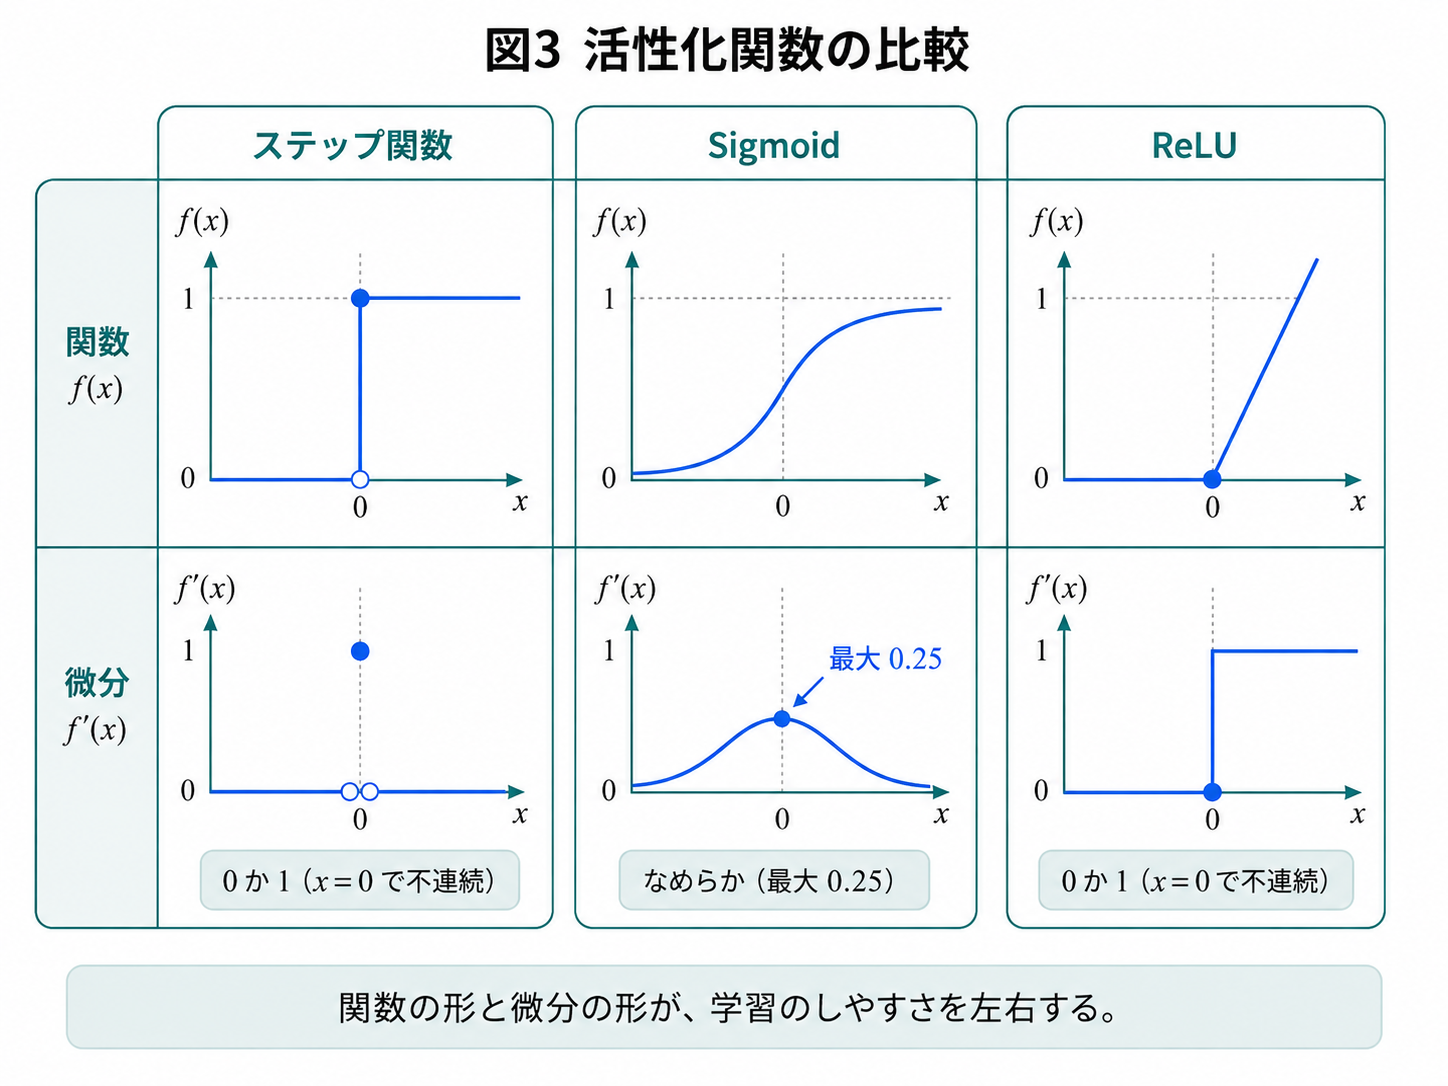
しかし、ここで一つの致命的な矛盾が発生します。第1章から用いてきた形式ニューロンのステップ関数 は、 の一点で微分不可能であり、それ以外のすべての場所で微分(傾き)が になってしまいます。
勾配(傾き)が であるということは、上記の更新式において となり、学習が一切進まないことを意味します。
勾配降下法による学習を成立させるためには、「非線形であり、かつ、すべての定義域で滑らかに微分可能である」という条件を満たす新たな関数(シグモイド関数など)を導入する必要があります。
2.3 誤差逆伝播法(バックプロパゲーション)
前節で、勾配降下法を機能させるためには「すべての定義域で滑らかに微分可能な関数」が必要であることを確認しました。多層パーセプトロンの学習アルゴリズムを完成させるため、まずは新しい活性化関数を導入し、続いてネットワーク全体を最適化する誤差逆伝播法(Backpropagation)の数学的構造を紐解きます。
1. 連続的な活性化関数の導入:シグモイド関数
ステップ関数に代わる微分可能な関数として、歴史的に広く用いられてきたのがシグモイド関数(Sigmoid function) です。
この関数は、入力 を から の間の連続値に変換します。重要なのはその導関数(微分)です。シグモイド関数を で微分すると、以下のように関数自身 を用いた非常に簡潔な形で表現できるという数学的な利点があります。
この性質により、コンピュータ上での微分の計算コストを大幅に削減することが可能になります。
2. ネットワークの数式化
入力層から中間層、出力層へと繋がる2層のネットワークを定義し、各層の計算を変数に分割します。
- 入力:
- 中間層への入力:
- 中間層の出力:
- 出力層への入力:
- 最終出力:
損失関数は二乗誤差 を用います。
3. 出力層のパラメータの勾配計算
まず、出力層の重み についての勾配 を求めます。2.2節で学んだ合成関数の微分(連鎖律)を用いて、以下のように3つの微分の積に分解します。
それぞれの項を計算します。
- (二乗誤差の微分)
- (シグモイド関数の微分)
- (線形結合の微分)
ここで、計算を整理するために「出力層における誤差成分」を示す変数 を定義します。
この を用いると、出力層の重みの勾配は非常にシンプルに記述できます。
4. 中間層のパラメータの勾配計算(連鎖律の拡張)
次に、入力側に近い中間層の重み の勾配 を求めます。連鎖律をさらに長く繋げる必要があります。
ここが誤差逆伝播法の核心です。式の前半部分 は、すでに先ほど として計算済みです。したがって、一から計算し直す必要はなく、前の層の計算結果をそのまま再利用できます。
中間層における誤差成分 は、出力層の誤差 を用いて以下のように逆算されます。
(※ は要素ごとの掛け算を表します)
この を用いることで、中間層の重みの勾配も出力層と全く同じ形式で求められます。
5. 誤差逆伝播法の本質
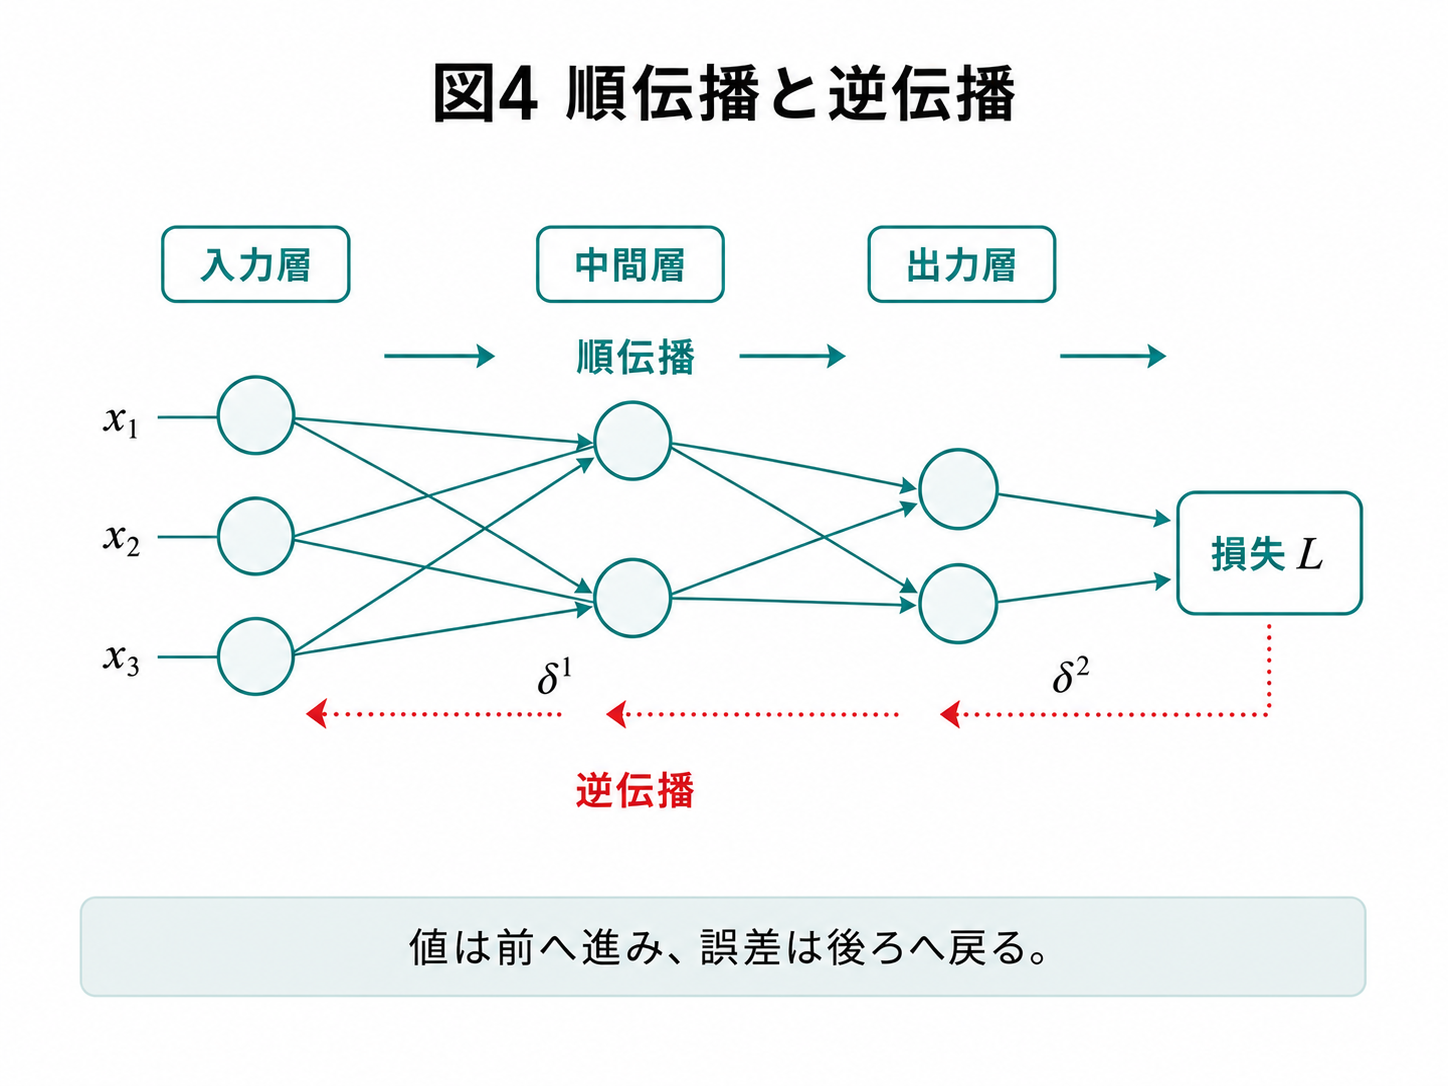
このように、出力層の誤差 を一つ前の層へ伝達し、それに重みと活性化関数の微分を掛けることで を求めるという漸化式が成立します。
後ろの層の誤差 重みと微分を掛ける 前の層の誤差
この計算手順を踏むことで、ネットワークが何層に深く(ディープに)なっても、出力層から入力層に向かって「誤差 」を逆方向に伝播させていくだけで、すべてのパラメータの勾配を極めて効率的かつ正確に計算することができます。
これが、現代の深層学習を根底から支える誤差逆伝播法(Backpropagation)の数学的メカニズムです。
2.4 勾配消失問題
誤差逆伝播法は、微分の連鎖律を用いることで効率的な学習を可能にする非常に優れたアルゴリズムです。しかし、ネットワークの層を深く(ディープに)していくと、勾配消失問題(Vanishing Gradient Problem)という深刻な数学的壁に直面します。
1. 微分の連鎖律における「乗算」の性質
多層ニューラルネットワークにおいて、入力層に近いパラメータ(重み)の勾配を求めるためには、出力層から入力層までのすべての層の「活性化関数の微分」と「重み」を掛け合わせる必要があります。
層の総数を とし、入力層付近の重み の勾配を微分の連鎖律で展開すると、大まかに以下のような構造を含みます。
2. シグモイド関数の導関数の最大値
ここで、前節で導入した活性化関数であるシグモイド関数 の導関数を思い出してください。
シグモイド関数の出力 は から の値を取るため、この導関数が最大値をとるのは (すなわち )のときです。その最大値を計算します。
つまり、シグモイド関数の微分値は、どのような入力が与えられても最大で にしかならないという決定的な数学的性質を持っています。
3. 指数関数的な減衰(勾配消失の証明)
この性質を先ほどの連鎖律の式に当てはめてみます。計算を単純化するため、各層の重み が 前後であったと仮定します。
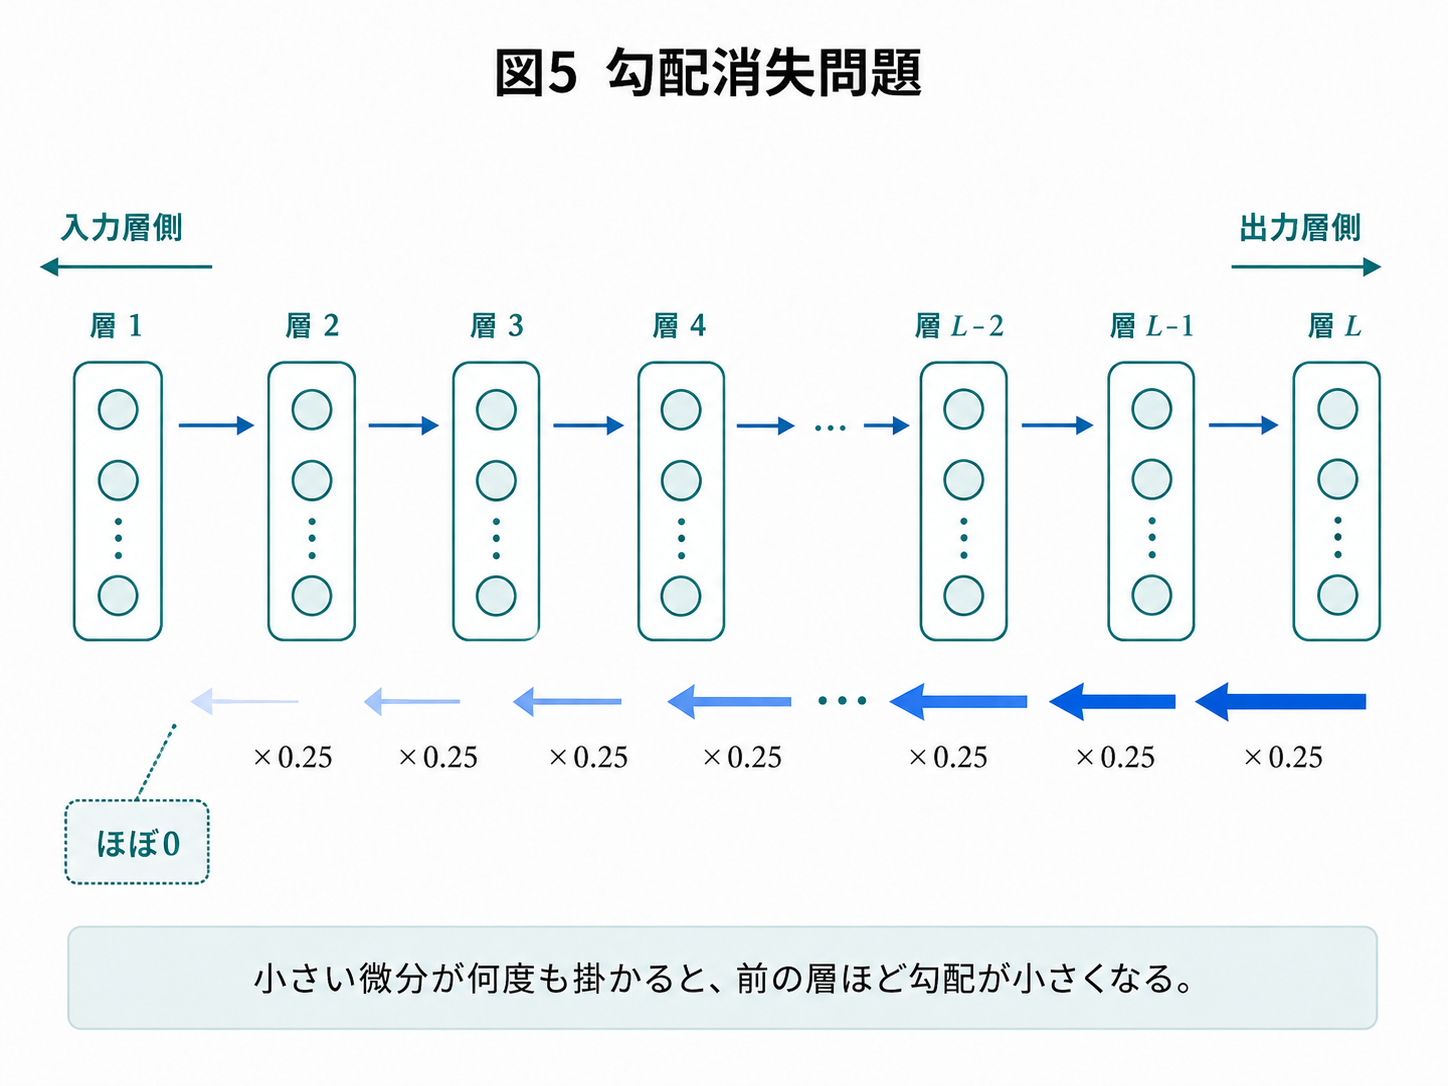
この場合、1層逆伝播するごとに、誤差(勾配)には最大でも という より小さな値が掛けられ続けることになります。
もし隠れ層が10層あるネットワークを構築した場合、入力層付近の勾配には が掛けられます。
このように、誤差(勾配)は層を遡るごとに最大でも 倍で指数関数的に減衰していきます。その結果、入力層に近いパラメータの勾配 はほぼ となります。
勾配が になるということは、更新式 における変化量が になることを意味し、入力層付近の重みが全く学習されなくなります。
これが「層を深くすればするほど賢くなるはずが、逆に学習が進まなくなる」という勾配消失問題の数学的メカニズムです。
2.5 勾配消失への対策(ReLU関数の導入)
前節で確認した通り、勾配消失問題の根本的な原因は、シグモイド関数の導関数の最大値が であり、微分の連鎖律によって微分値が掛け合わされるたびに勾配が指数関数的に へと減衰してしまうという数学的性質にありました。
この問題を解決し、多層化されたディープラーニングの学習を可能にしたのが、ReLU(Rectified Linear Unit)という新しい活性化関数の導入です。
1. ReLU関数の数式的定義
ReLU関数 は、入力 が より大きければそのまま出力し、 以下であれば を出力するという極めて単純な関数として定義されます。
2. ReLU関数の導関数と勾配の保存
勾配消失を克服する最大の鍵は、この関数の導関数(微分)にあります。 の点における厳密な微分は定義されませんが(実用上は劣微分として を割り当てます)、それ以外の領域では以下のように定数となります。
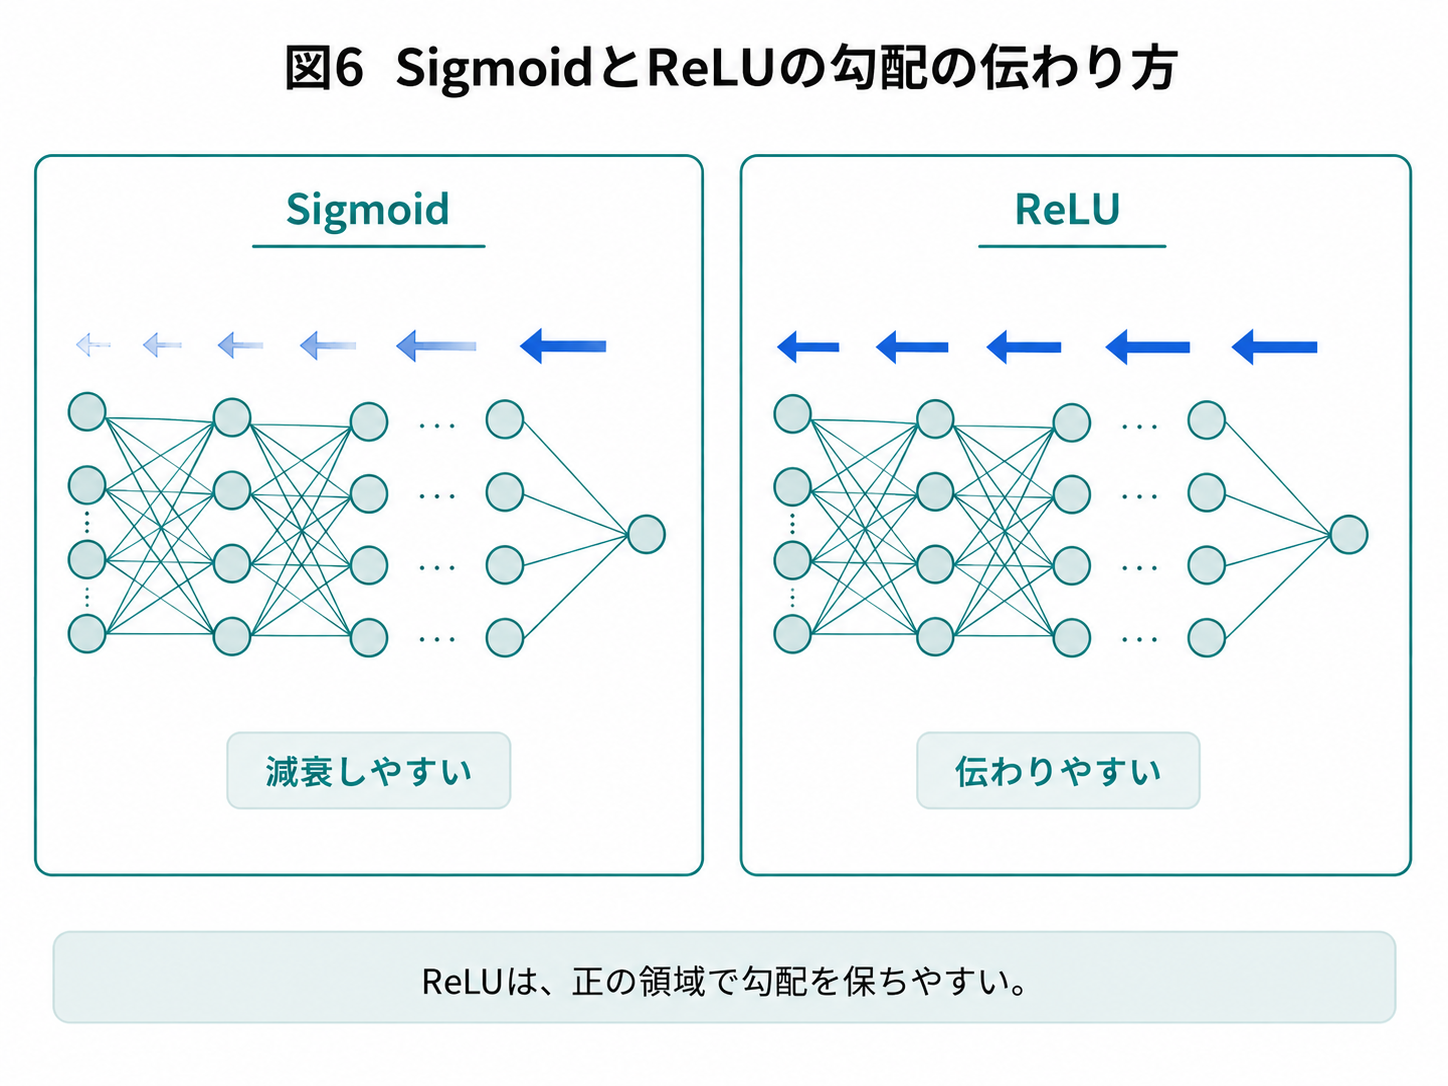
入力が正の領域(発火している状態)では、導関数が常に となります。
誤差逆伝播法において、連鎖律で勾配を計算する式 を再度考えます。ネットワーク内でシグモイド関数の代わりにReLUを用いた場合、経路上のニューロンが発火している()限り、掛けられる微分値は常に となります。
数学的に、 を何度掛け合わせても値は減衰しません。したがって、層が何十層と深くなっても、出力層からの誤差(勾配)が入力層まで消失することなく、そのまま伝播することが保証されます。
3. 非線形性の維持と最適化の効率化
導関数が になる線形な性質を持つ一方で、全体として見れば を境に出力が折れ曲がるため、数学的には「非線形関数」の条件を満たしています。そのため、多層ネットワークの「空間を非線形に変換し、XOR問題を解く」という能力は失われません。
また、シグモイド関数にあった のような計算コストの高い指数関数の演算が含まれないため、順伝播・逆伝播ともに計算速度が劇的に向上するという副次的な利点もあります。
シグモイド関数からReLUへのパラダイムシフトは、数式上は極めて些細な変更ですが、数学的には「連鎖律の乗算による勾配の減衰を完全に排除する」という決定的な解決策となりました。これによって深い層への学習が波及するようになり、今日のディープラーニングの隆盛をもたらすことになります。
2.6 過学習(オーバーフィッティング)
多層化とReLU関数の導入により、ニューラルネットワークは極めて高い非線形表現力を獲得しました。しかし、パラメータの数(重みとバイアスの総数)が増大し、モデルの表現力が高まりすぎることで、過学習(Overfitting)という新たな数学的課題が発生します。
1. 訓練誤差と汎化誤差の定義
機械学習の真の目的は、手元のデータに対する誤差を減らすことではなく、未知のデータに対する予測精度(汎化性能)を高めることです。これを数式で整理します。
手元にある 個の学習データセットに対する損失(訓練誤差)を とします。
一方で、モデルが未知のデータ(テストデータ)に対して出力する損失の期待値(汎化誤差)を とします。
2. 過学習の数学的メカニズム
勾配降下法は、あくまで手元の を最小化するようにパラメータ を更新するアルゴリズムです。
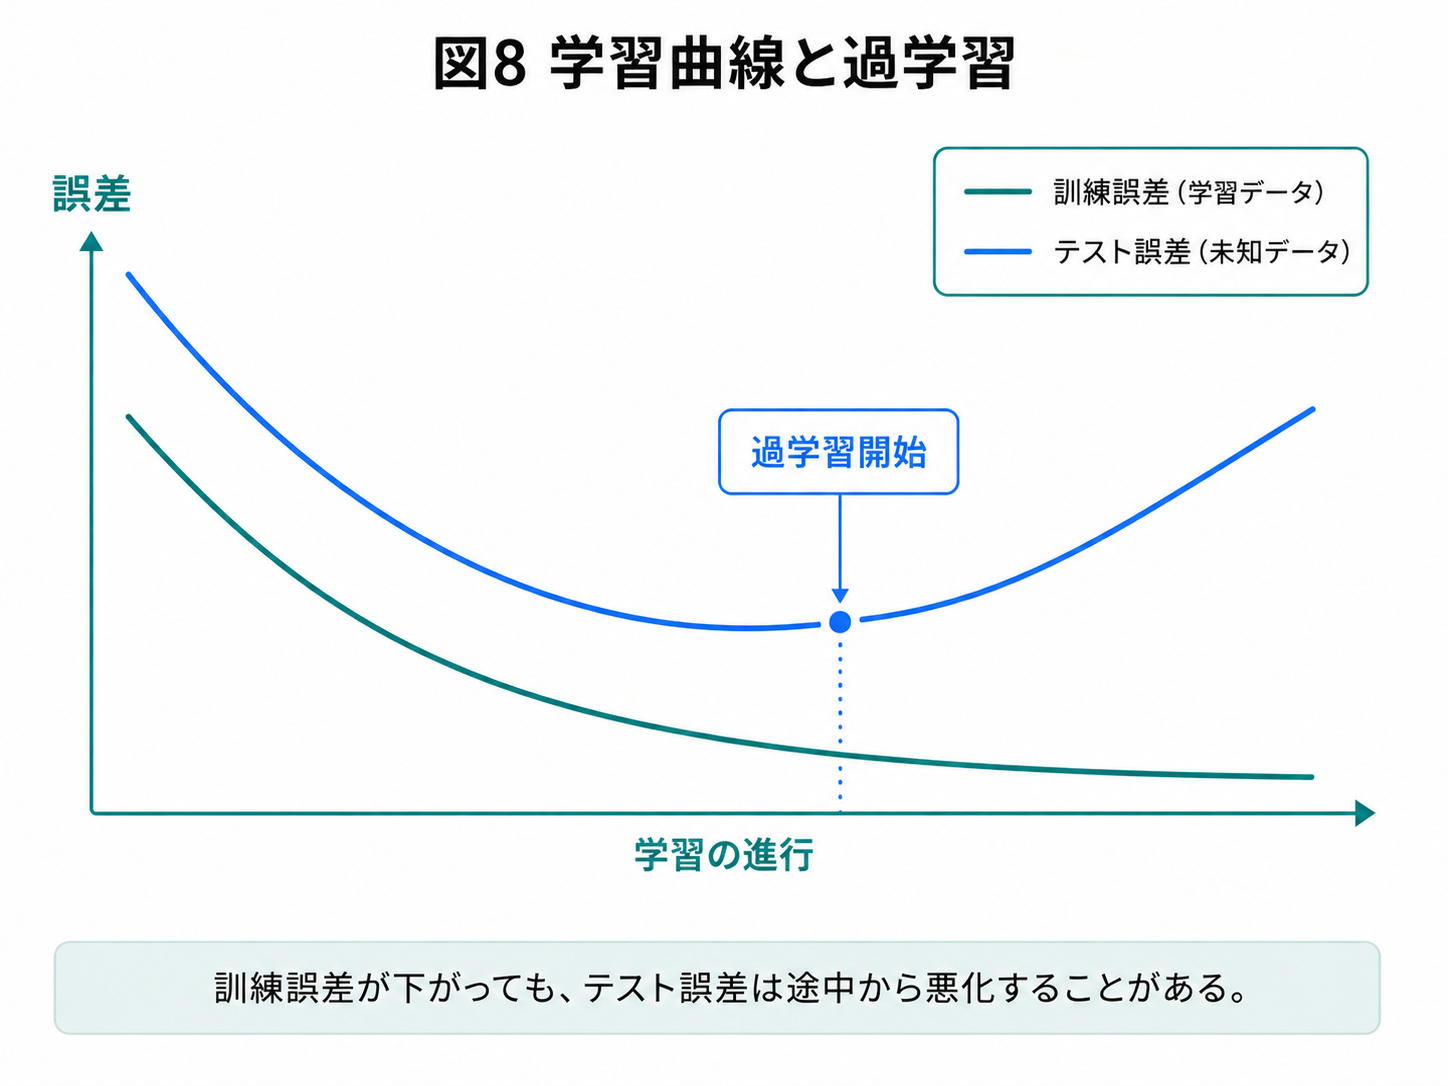
層が深く、パラメータの自由度がデータ数 に対して十分に大きい場合、ネットワークの表現力が高くなりすぎます。その結果、データに含まれる本質的な規則性(真の関数)だけでなく、確率的な観測ノイズや外れ値までも完全に内包するような、極度に複雑な決定境界を形成してしまいます。
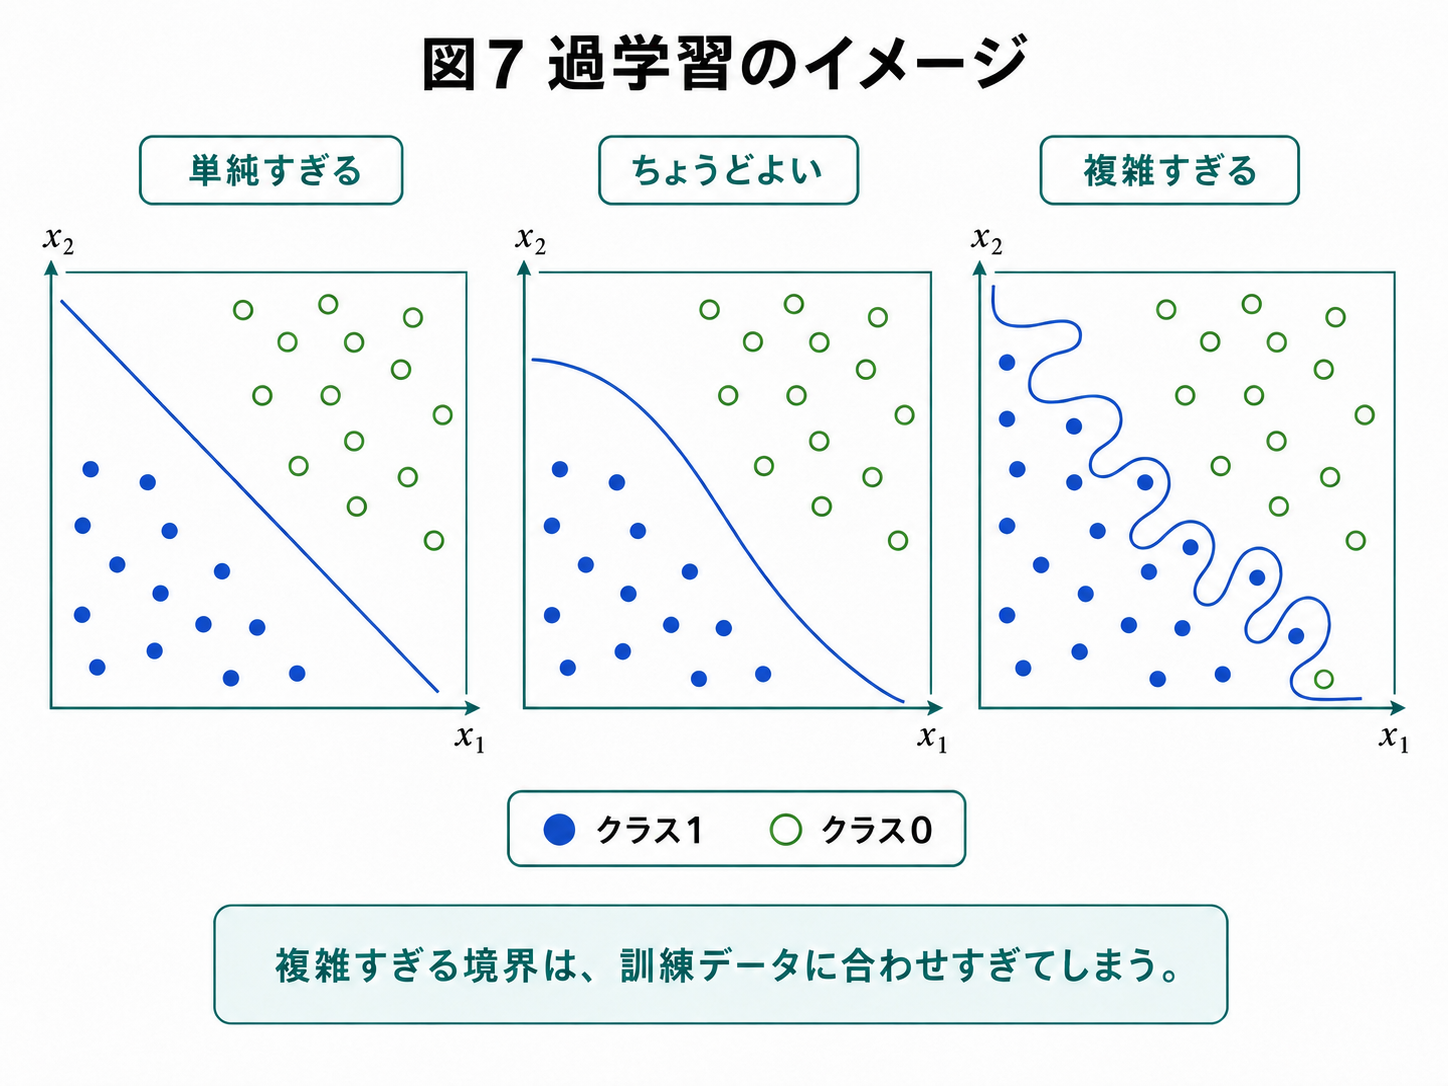
この状態では、手元の学習データには完璧に適合するため に近づきます。しかし、未知のデータに対しては予測性能が著しく低下し、 の値は逆に増大してしまいます。
3. バイアス・バリアンス分解
この現象は、統計学における「バイアス・バリアンス分解」によっても数学的に証明されます。モデルの予測誤差は以下のように分解できます。
- バイアス(Bias): モデルの表現力不足による誤差。単層パーセプトロンのように、モデルが単純すぎる(直線の)場合に大きくなります。
- バリアンス(Variance): 学習データの選び方によって生じるモデルの変動。ネットワークの層を深くして表現力を高めすぎると、特定のデータセットに過剰に適合するため、このバリアンスが極大化します。
過学習とは、このバリアンスが肥大化し、 と の間の乖離(ギャップ)が拡大し続けている状態を指します。これを抑制し、真の目的である汎化誤差 を小さく保つための数学的なアプローチが、次節の「正則化」となります。
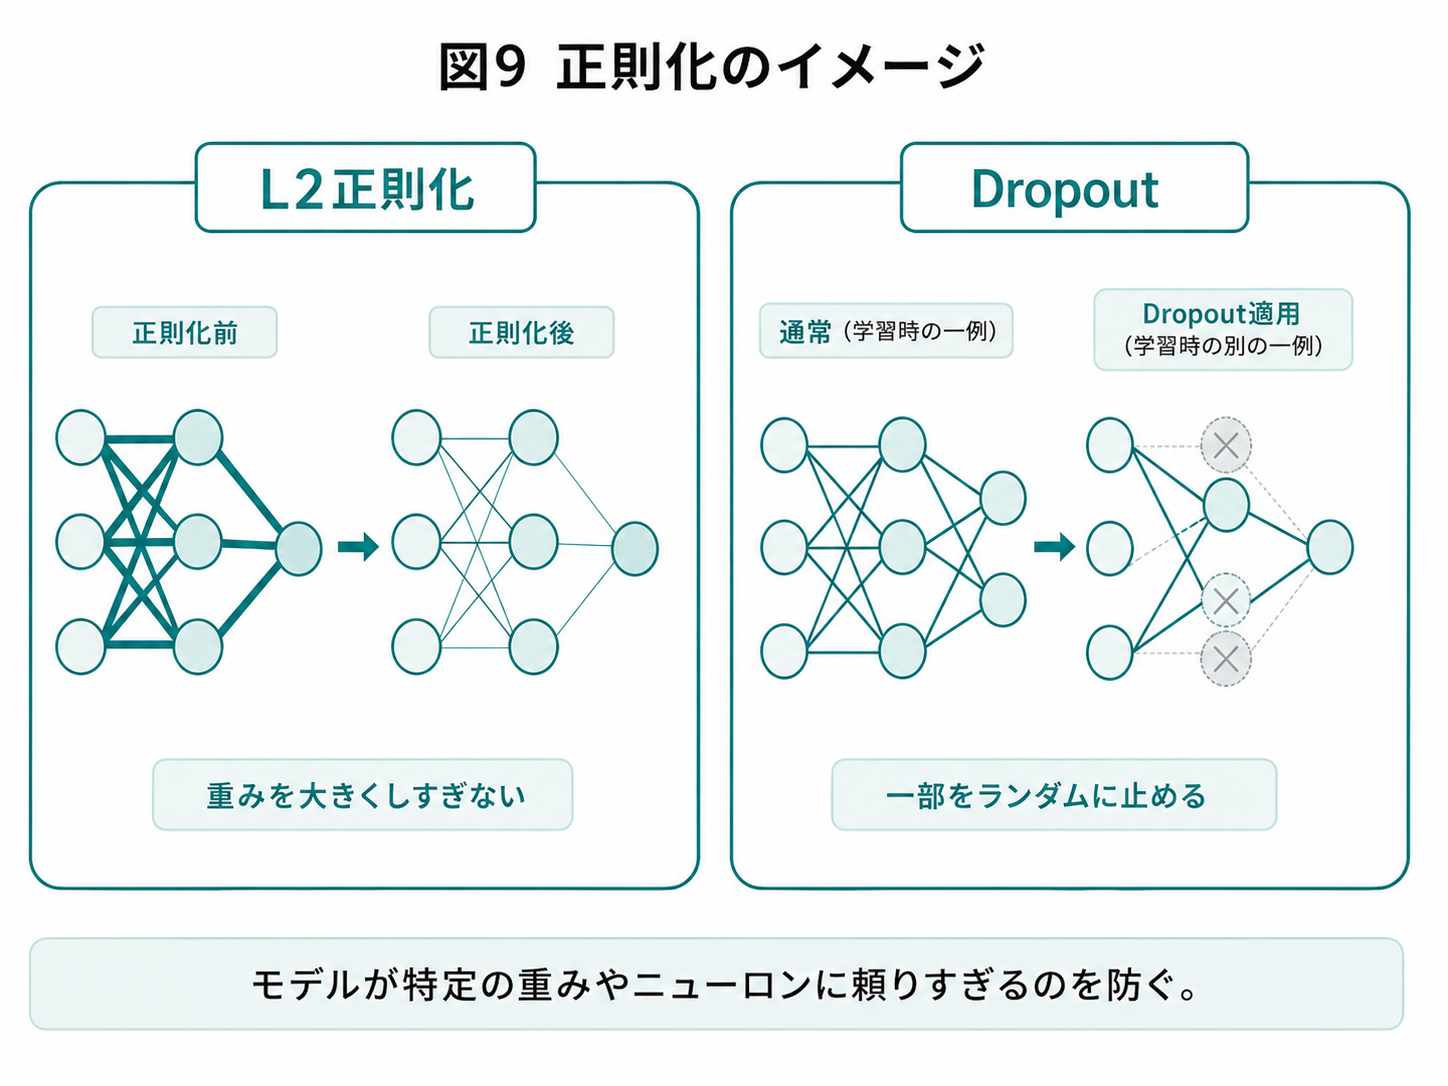
2.7 正則化(L2正則化とDropout)
2.6節で解説した通り、表現力が高すぎるモデルは訓練データに対して過剰に適合し、バリアンスが極大化することで汎化誤差 が増大(過学習)します。この現象を数学的に抑制し、モデルの汎化性能を向上させるアプローチが正則化(Regularization)です。
ここでは、代表的な手法であるL2正則化(重み減衰)とDropoutの数学的メカニズムについて解説します。
1. L2正則化(重み減衰:Weight Decay)
L2正則化は、本来の損失関数 に対して、パラメータ(重みベクトル )のL2ノルムの二乗(各重みの二乗和)をペナルティ項として加算する手法です。新しい損失関数 は以下のように定義されます。
ここで、 は正則化係数(ハイパーパラメータ)であり、ペナルティの強さを制御します。先頭の は微分時の係数を相殺するためのものです。
この損失関数 を用いて勾配降下法を適用します。ある重み に対する更新式は以下のようになります。
【数学的考察】
更新式における という項に注目してください。通常、学習率 および正則化係数 は非常に小さな正の値であるため、 は よりわずかに小さい値(例えば など)になります。
これは、通常の勾配更新を行う前に、重み自身を一定の割合で縮小させる操作が加わっていることを意味します。これがL2正則化が「重み減衰」と呼ばれる理由です。
重みの絶対値が小さく抑えられることで、特定の入力に対して出力が過敏に変動するのを防ぎ、結果としてバリアンスを減少させ、決定境界を滑らかにする数学的効果があります。
2. Dropoutの数学的解釈
Dropoutは、順伝播の計算時において、各層のニューロンの出力を確率 でランダムに (非活性化)にする手法です。
各層の活性化関数の出力ベクトルを としたとき、確率 で 、確率 で を取るベルヌーイ分布に従うマスクベクトル を生成し、要素ごとの積(アダマール積 )を計算します。
【アンサンブル学習としての近似】
Dropoutの数学的な本質は、独立した無数のネットワーク構造によるアンサンブル学習の近似にあります。
1回のステップごとに異なるマスク が適用されるため、ネットワークは毎回異なる不完全な構造で学習を行うことになります。全ニューロン数を とすると、最大で 個の異なるサブネットワークを同時に訓練していることと等価になります。
評価時(テスト時)は、すべてのニューロンを常に使用しますが、訓練時と評価時で出力の期待値を一致させるため、出力に対して を掛け合わせるスケーリング処理を行います。
(※現代の実装では、訓練時にあらかじめ を掛けておく「Inverted Dropout」が一般的であり、テスト時の計算を不要にしています。)
Dropoutにより、特定のニューロン間の結合だけに依存する(共適応する)ことが数学的に不可能となり、特徴量が分散して学習されるため、過学習が強力に抑制されます。