ChatGPT などの LLM(大規模言語モデル。大量の文章で学習して、文章を作る AI)がしていることは、「ここまでの文章を読んで、次に来る言葉を予想する」の1つです。予想した言葉を後ろに足し、足した文をもう一度読んで、その次を予想します。このとき文章を区切る細かいかけらを、トークンと呼びます。
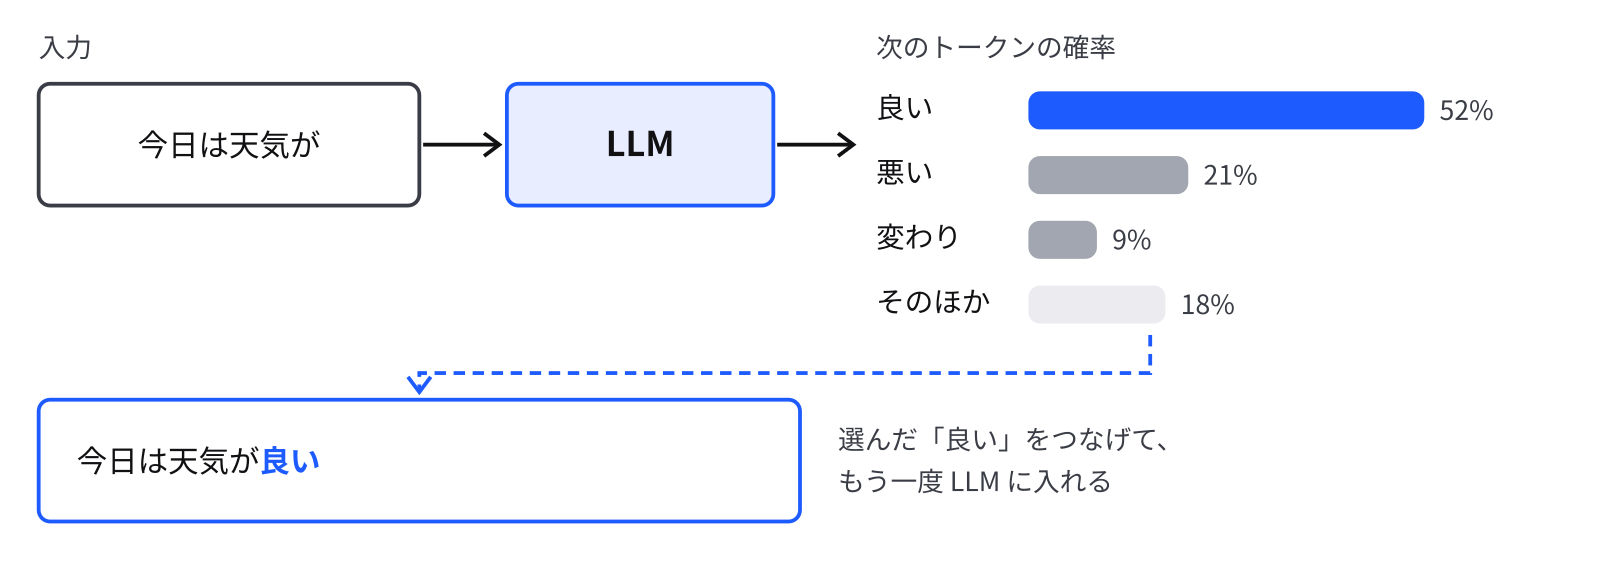
この記事では、昔話「ももたろう」の短い文章を使って、次の1文字を予想する、いちばん単純なモデルを考えます。本物の LLM と比べるとずっと小さく、見るのは直前の1文字だけです。それでも、文章を番号に直す、入力と正解を作る、確率から1文字ずつ選んで文章を作る、予想の外れ具合を数で測る、という流れは本物と同じです。
| この記事のモデル | 本物の LLM | |
|---|---|---|
| 入力 | 文字1つ | ここまでの文章(数千〜数十万トークン) |
| 当てるもの | 71種類の文字のどれか | 数万〜約20万種類のトークンのどれか |
| 出すもの | 次の文字の確率 | 次のトークンの確率 |
紙とペンを用意してください。プログラムは書きません。表を数えるところと、損失を計算するところを、小さな文章で手を動かして確かめます。
文章を番号の並びにする
文章を用意する
ニューラルネットワークが受け取れるのは数だけです。画像なら、小さなマスの明るさが最初から数になっています。文章は、そのままでは数になっていません。そこで、文章を数の並びに直します。
使う文章は、昔話「ももたろう」を短くしたものです。全部で 576 文字あります。
むかしむかし、あるところに、おじいさんとおばあさんが住んでいました。
おじいさんは山へしばかりに、おばあさんは川へせんたくに行きました。
おばあさんが川でせんたくをしていると、大きなももが流れてきました。
……(以下、いぬ・さる・きじを連れて、おにたいじをして帰るまで)
文字に番号を付ける
この文章に出てくる文字の種類を、全部並べます。重なりは1つにまとめ、五十音の順などの決まった順に並べます。この文章では 71 種類で、先頭は改行、読点「、」、句点「。」、「あ」、「い」、……と続きます。
並べた中での位置を、その文字の番号にします。改行が 0 番、「、」が 1 番、「。」が 2 番、と数えていくと、「も」は 38 番、「た」は 20 番、「ろ」は 45 番、「う」は 5 番になります。すると「ももたろう」は次の番号の並びになります。
ももたろう → [38, 38, 20, 45, 5]
反対に、番号の並びから文字に戻すこともできます。[6, 28] は「お」と「に」で、「おに」になります。文字から番号に直す操作と、番号から文字に戻す操作は、このあとの説明で何度も使います。
本物の LLM のトークン
ここで考えるのは、「1文字が1トークン」のいちばん単純な区切り方です。本物の LLM は、よく出てくる文字の並びを1つにまとめた、もっと大きなかけらを1トークンにします。たとえば GPT-4o が使う区切り方(o200k_base という名前の辞書)では、「日本の首都は東京です。」が次の8つのトークンに分かれます。
日本 / の / 首 / 都 / は / 東京 / です / 。
「日本」「東京」「です」は、2文字で1つのトークンです。それぞれのトークンにも番号が付いていて、モデルにはその番号が渡されます。区切り方が違うだけで、していることは同じです。文章を番号の並びに直し、モデルにはその番号を渡します。モデルが出す答えも番号で、それを文字に戻して読みます。
トークンの種類をまとめたものを語彙(ごい。英語で vocabulary)と呼びます。この記事のモデルは語彙が 71、GPT-4o は約 20 万です。1文字ずつ区切ると語彙は小さくて済みますが、同じ文章でも番号の並びが長くなります。この記事では、仕組みを追いやすい「1文字が1トークン」のまま進めます。
入力と正解の組を作る
学習には、入力と正解の組が要ります。画像を見分ける AI なら、人が1枚ずつ「これはブーツ」のように正解を付けたデータを用意します。文章の続きを予想する問題では、正解を付ける作業が要りません。文章の中で、ある文字の次にある文字が、そのまま正解になるからです。
文章全体を番号の並びにして、それを1つずらしたものを作ります。元の並びから最後の1文字を除いたものが入力 x、最初の1文字を除いたものが正解 y です。
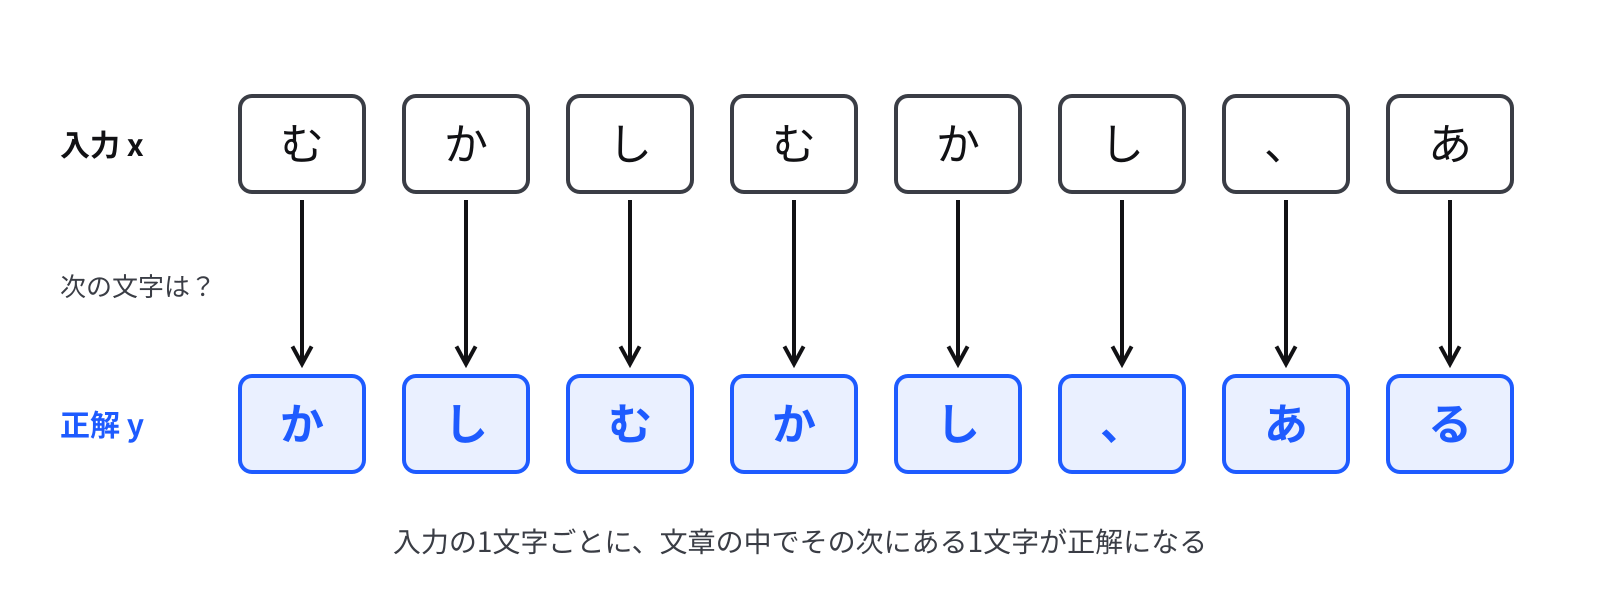
上と下を縦に見てください。入力が「む」のとき正解は「か」、入力が「か」のとき正解は「し」、入力が「し」のとき正解は「む」です。576 文字の文章から、575 組の「入力と正解」ができました。
ここで、同じ入力に違う正解が付いている組があります。3組目は入力が「し」で正解が「む」ですが、6組目は同じ入力「し」で正解が「、」です。「も」の次も、「もも」の1文字目なら「も」、「ももたろう」の2文字目なら「た」です。直前の1文字だけでは、次の文字は1つに決まりません。そこで、次の文字を「確率」で答えるモデルを考えます。
数えて確率の表を作る
ニューラルネットワークを使う前に、いちばん素直なやり方を考えます。「この文字の次に、どの文字が何回来たか」を数えるやり方です。
「も」の次を数える
文章の中の「も」を全部探して、その次の文字を集めます。「も」は 37 回出てきます。その次の文字は、「も」が 18 回、「た」が 15 回、「を」が 2 回、「が」と「の」が 1 回ずつでした。回数を合計の 37 で割ると、確率になります。
| 「も」の次の文字 | 回数 | 確率 |
|---|---|---|
| も | 18 | 18 ÷ 37 = 0.486 |
| た | 15 | 15 ÷ 37 = 0.405 |
| を | 2 | 2 ÷ 37 = 0.054 |
| が | 1 | 1 ÷ 37 = 0.027 |
| の | 1 | 1 ÷ 37 = 0.027 |
| そのほかの 66 種類 | 0 | 0 |
「もも」と「ももたろう」がたくさん出てくる文章なので、「も」の次は「も」か「た」がほとんどです。
71 種類すべてで数える
同じことを、71 種類の文字すべてについてします。結果は、71 行 71 列の表に入れます。行が「今の文字」、列が「次の文字」で、マスの中の数が回数です。575 組の入力と正解を1組ずつ見て、「入力の行、正解の列」のマスに 1 を足していくと、表ができます。「も」の行の「も」の列は 18、「た」の列は 15 になり、さっき数えた回数と合います。
71 × 71 では大きすぎるので、小さな文章で表の形を見てください。次の 12 文字の文章で作った表です。
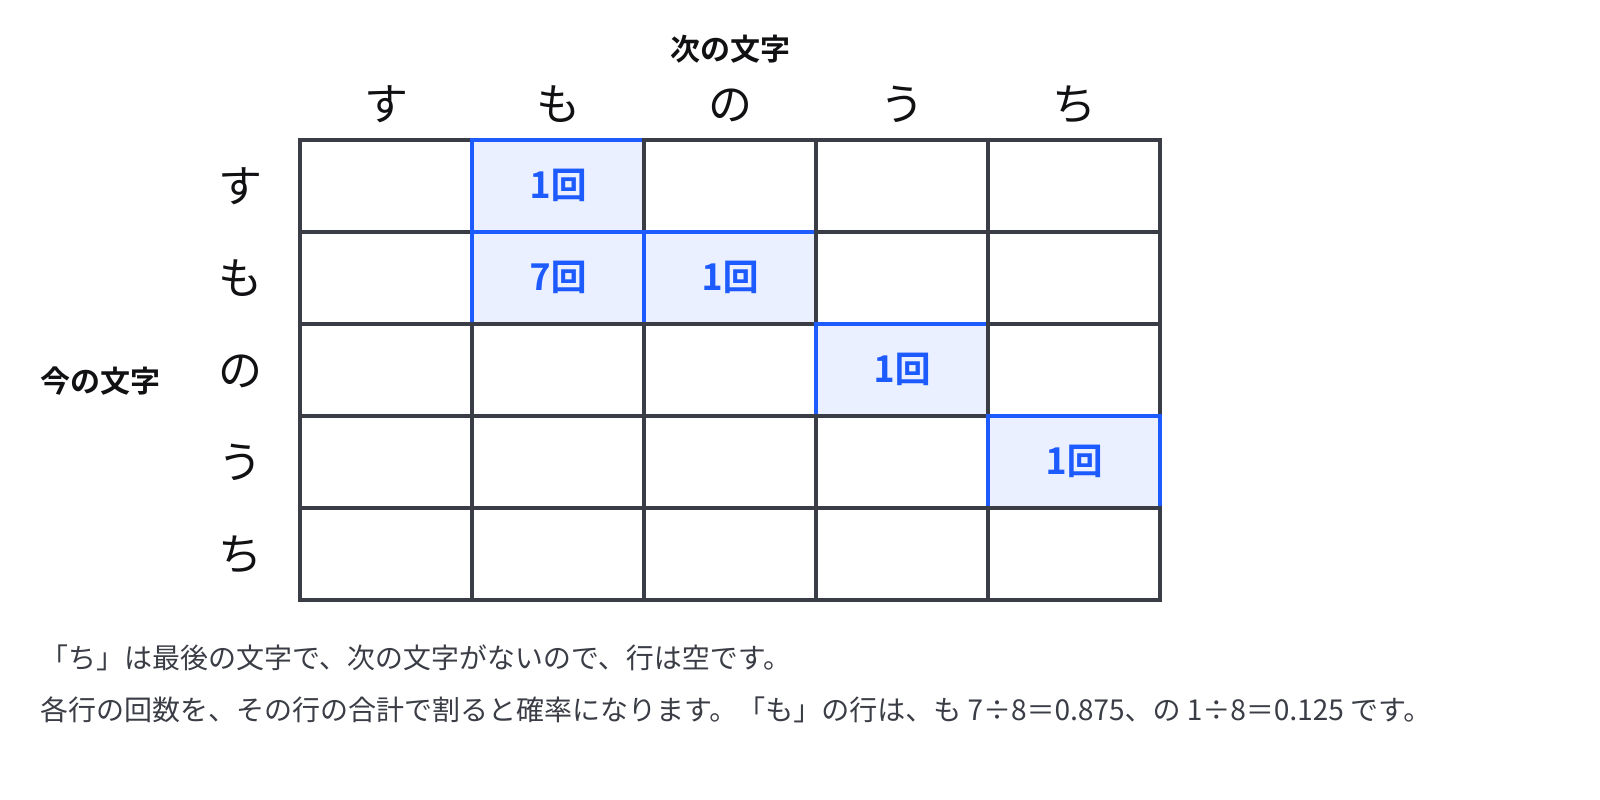
それぞれの行を、その行の合計で割ると、確率の表になります。この表が、学習の済んだモデルに当たります。「今の文字」を渡すと、その行を見て「次の文字」の確率を答えられます。パラメータを直す学習はしていませんが、文章という例から決まりを取り出した、という点では機械学習のモデルです。
確率から1文字選ぶ
確率が出たら、その確率に従って1つ選びます。「も」の行なら、約 49%で「も」、約 41%で「た」が出るくじを引くことになります。
いちばん確率の高い文字を毎回選ぶこともできます。そうすると「も」の次はいつも「も」になり、「ももももも…」と続いて止まりません。確率に従って選ぶと、「も」も「た」も、文章に出てきた割合で出てきます。
文章を作らせる
選んだ文字を次の入力にして、くり返します。最後の文字の行を見て、くじを引き、出た文字を後ろに足す、をくり返すと、文章ができます。「も」から始めて 60 文字作らせた例は、次のようになります。くじ引きなので、やるたびに違う文章になります。
もたろうは、おじに、中から元気なもたいるにをひろうは、もの家へ帰りましているといじは、もももた。
おばあさんごをついさると
できた文章を読んでみてください。「たろうは、」「中から元気な」「の家へ帰りまし」のように、もとの文章にあった並びが所どころに出ています。全体としては意味が通りません。「おじに」「もたいるにを」のような、もとの文章に無い並びもできています。
理由は、このモデルが直前の1文字しか見ていないことにあります。「おじ」まで作ったあと、モデルが見るのは「じ」だけです。「じ」の次は、「おじいさん」なら「い」ですが、「おにたいじに」「きじに」では「に」です。モデルは、今が「おじいさん」の途中だということを知らないので、「に」を選ぶことがあります。
このモデルの損失
このモデルがどのくらい良く予想できているかを、1つの数で測ります。このような「予想の外れ具合」を表す数を、損失(そんしつ、loss)と呼びます。損失は小さいほど良く、学習では損失が小さくなるようにモデルを直していきます。
確率を出すモデルでは、損失として、正解の文字に付けた確率の −log を使います。
損失 = −log(正解の文字に付けた確率)
log は対数(たいすう)で、ここでは「e を何乗するとその数になるか」を返す関数です。e は約 2.718 の決まった数で、ネイピア数と呼びます。円周率 π と同じように、数学でよく使う数です。log(1) = 0 で、1 より小さい数の log はマイナスになります。確率は 1 以下なので、頭に − を付けると、損失はプラスか 0 になります。
| 正解に付けた確率 | 損失 −log(確率) |
|---|---|
| 1.0 | 0 |
| 0.9 | 0.105 |
| 0.5 | 0.693 |
| 0.1 | 2.303 |
| 0.01 | 4.605 |
正解に高い確率を付けていれば損失は 0 に近く、低い確率しか付けていなければ大きくなります。この損失を、交差エントロピー(こうさエントロピー、cross entropy)と呼びます。名前は情報理論という分野から来ていますが、ここでは「正解に付けた確率の −log」と覚えておけば足ります。分類(いくつかの種類のどれかを当てる問題)で、広く使われる損失です。
575 組それぞれで「正解の文字に付けた確率」を取り出し、−log を計算して平均します。最初の組は入力「む」・正解「か」で、確率は 1.0 です。この文章では「む」の次は必ず「か」だからです。2つ目は入力「か」・正解「し」で、確率は 0.4 です。3つ目は入力「し」・正解「む」で、確率は 0.0345 と小さく、損失は大きくなります。575 組の平均は 1.109 になります。
比べる相手として、何も学習していないモデルを考えます。71 種類すべてに同じ確率 1/71 を付けるモデルの損失は、−log(1/71) = log(71) = 4.263 です。あてずっぽうの 4.263 に対して、数えた表は 1.109 です。損失を見るときは、このように「何も学習していないときの値」と比べると、どのくらい良くなったかが分かります。
課題:12 文字の文章で表と損失を出す
次の 12 文字の文章を使います。上の図の表は、この文章のものです。
すもももももももものうち
「す」が1つ、「も」が8つ、そのあとに「の」「う」「ち」が1つずつ並んでいます。
- この文章から、入力と正解の組は何組できますか
- 「も」の次に来る文字を数えて、確率を出してください
- 「す」「の」「う」の次に来る文字の確率は、それぞれどうなりますか
- 数えた確率の表で、すべての組の損失(正解に付けた確率の −log)を平均すると、いくつになりますか。log(0.875) = −0.134、log(0.125) = −2.079 を使ってください
- この確率の表で「す」から文章を作らせると、もとの文章と同じ「すもももももももものうち」が出てくるとは限りません。どんな文章が出てくる可能性がありますか
答えと解説
- 11 組です。12 文字の文章なので、最後の「ち」を除いた 11 文字が入力になります
- 「も」は8回出てきて、次は「も」が7回、「の」が1回です。確率は「も」が 7 ÷ 8 = 0.875、「の」が 1 ÷ 8 = 0.125 です
- 「す」の次は必ず「も」、「の」の次は必ず「う」、「う」の次は必ず「ち」で、確率はどれも 1 です。「ち」は最後の文字で、次の文字が無いので、「ち」の行は数えられません
- 約 0.274 です。11 組のうち、確率 1 の組が3つ(す→も、の→う、う→ち)で、損失は −log(1) = 0 です。確率 0.875 の組が7つ(も→も)で、損失は1つあたり 0.134 です。確率 0.125 の組が1つ(も→の)で、損失は 2.079 です。合計は 0 × 3 + 0.134 × 7 + 2.079 = 3.017 で、11 で割ると 0.274 です
- 「も」の数が変わります。「も」のあとは、毎回 87.5%で「も」、12.5%で「の」が選ばれます。運しだいで「すものうち」のように「も」が1つで終わることも、「も」が 20 個続くこともあります。このモデルは「も」を何個書いたかを覚えていないので、8個ちょうどで止めることができません。直前の1文字しか見ないモデルの限界です
この記事で出てきた言葉
| 言葉 | 意味 |
|---|---|
| トークン | モデルが文章を読み書きするときのかけら。この記事では1文字 |
| 語彙 | トークンの種類をまとめたもの。その数が、モデルの出す点数の個数になる |
| 入力と正解 | 文章を1つずらして作る組。ある文字が入力のとき、その次の文字が正解 |
| 損失・交差エントロピー | 予想の外れ具合を表す数と、正解に付けた確率の −log を使う損失 |
| バイグラム | 今の1トークンと次の1トークンの組だけを見るモデル |
続けて読む記事
この記事では、「この文字の次に何が来たか」を数えた確率の表で、文章を作る流れを考えました。表を作るのは数えるだけで済みますが、見る文字を増やすと表が大きくなりすぎます(直前の2文字を見るなら 71 × 71 行、3文字なら 357,911 行)。直前の1文字しか見ないので、文章も意味が通りません。
本物の LLM は、前にある文字をまとめて見て、今の予想に関係する文字を選び出す仕組み(アテンション)を使っています。その計算は、「Transformer のアテンションを小さな数で手計算する」で手計算します。
参考にした資料
- 3Blue1BrownJapan「LLMの仕組み(簡単バージョン)」(約8分。この記事で考えた「次を予想して1つ選び、つなげる」動きを、本物の LLM の大きさで見られます)