直前の1文字だけを見て次の1文字を予想するモデルでは、作られる文章の意味が通りません。たとえば昔話「ももたろう」の文章で学習させると、「た」の次の文字を決められません。
| ここまでの文字 | 次に来る文字 | 直前の1文字だけを見るモデルが付けた確率 |
|---|---|---|
| …行きまし「た」 | 。 | 「。」に 0.49、「ろ」に 0.37 |
| …もも「た」 | ろ | 同じ(「。」に 0.49、「ろ」に 0.37) |
人が読めば、「ました」のあとは「。」、「ももた」のあとは「ろ」だとすぐに分かります。1つ前や2つ前の文字を見ているからです。モデルにも、前にある文字を見せる必要があります。
数えた確率の表で見る文字を増やすと、行の数が大きくなりすぎます(文字が 71 種類なら、直前の2文字を見るのに 71 × 71 行、3文字なら 357,911 行)。ニューラルネットワークでも、前の 16 文字のベクトルをただ横につなげて入れるやり方だと、文字の位置ごとに別々の重みが要り、長い文章を扱えません。この問題の背景は、「LLM が次の1文字を予想する仕組みを、数えた確率の表で考える」で説明しています。
今の LLM のほとんどは、Transformer(トランスフォーマー)という形のニューラルネットワークを使っています。Transformer は、2017 年に Google の研究者たちが論文「Attention Is All You Need」で発表しました。その中心にあるのが、アテンション(attention、注意)という仕組みです。アテンションは、前にある文字のうち、今の予想に関係するものを選んで、そのベクトルを混ぜ合わせます。
この記事では、アテンションを小さな数で手計算して仕組みを理解し、Transformer を組み立てる部品を一通り見ます。紙とペンを用意してください。プログラムは書きません。
アテンションがしたいこと
「モデル」という言葉は、文によって意味が変わります。「機械学習のモデルを作る」のモデルは予測をする仕組みで、「ファッションのモデルが歩く」のモデルは服を着て見せる人です。
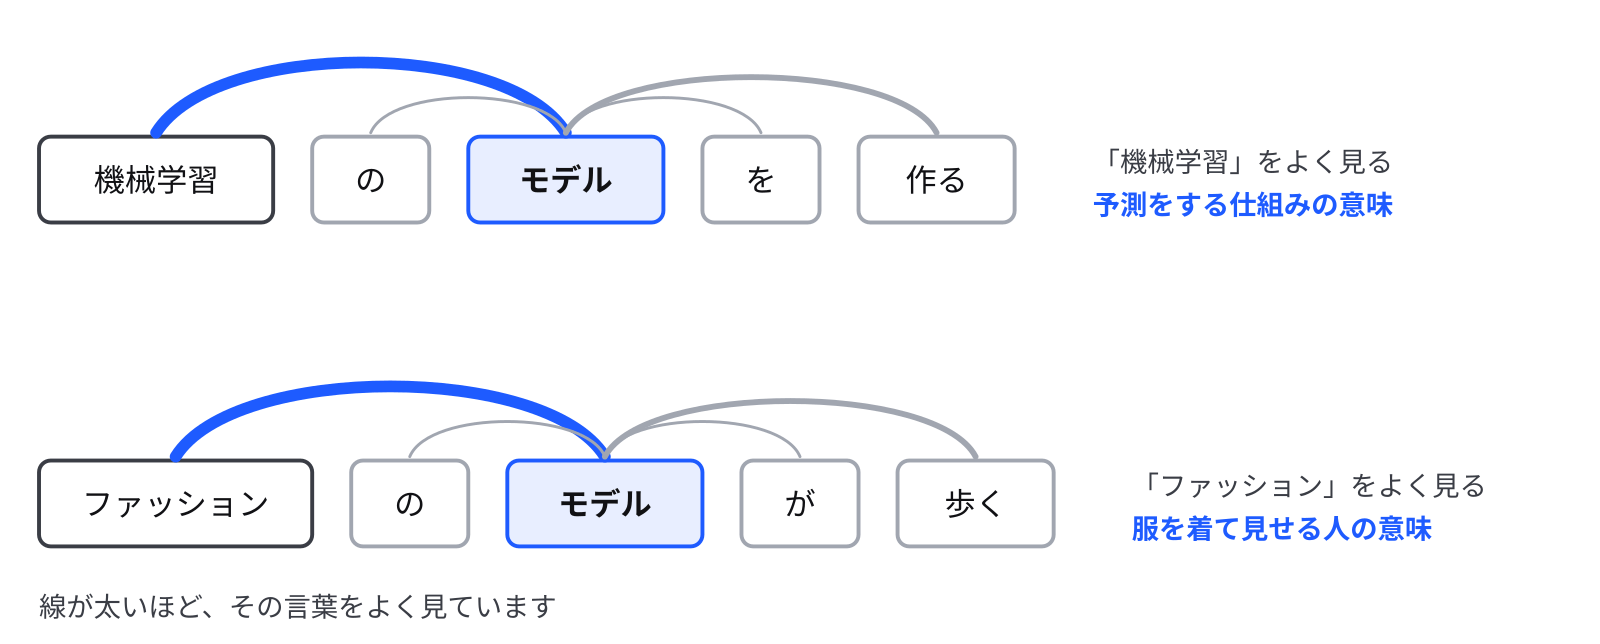
埋め込み(トークン1つに、数の並び=ベクトルを1つ割り当てる表)では、トークン1つにベクトルが1つ決まっています。「モデル」のベクトルは、どの文の中でも同じです。これでは、2つの意味を区別できません。
アテンションは、文の中のほかのトークンのベクトルを、「モデル」のベクトルに混ぜ込みます。「機械学習」をたくさん混ぜれば、予測をする仕組みのほうの意味に寄ったベクトルになります。「ファッション」をたくさん混ぜれば、人のほうの意味に寄ります。どのトークンをどれだけ混ぜるかは、決め打ちにせず、ベクトルどうしの計算で決めます。
することを順に書くと、次の3つです。
- ほかのトークンそれぞれに、「今のトークンにどれだけ関係があるか」の点数を付ける
- 点数をソフトマックスに通して、足すと 1 になる重みに直す
- それぞれのトークンのベクトルに重みを掛けて、足し合わせる
点数を付け、ソフトマックスに通す所は、画像の種類を見分ける AI が種類ごとの確率を出すときと同じ計算です。ソフトマックスは、点数 z を exp(z)(e の z 乗。e は約 2.718)に直し、全部の合計で割って、足すと 1 になる数にする計算です。
3つのベクトルで手計算する
文字が3つ並んでいて、それぞれが長さ 2 のベクトルになっているとします。数は、計算しやすいように選んだものです。
1番目の文字のベクトル = [1, 0]
2番目の文字のベクトル = [0, 1]
3番目の文字のベクトル = [1, 1]
3番目の文字のベクトルを、アテンションで作り直します。
点数は内積で付ける
「どれだけ関係があるか」の点数には、内積を使います。内積は、同じ位置の数どうしを掛けて足したもので、2つのベクトルの向きが近いほど大きくなります(くわしくは「AI で使うベクトルと行列」)。3番目のベクトル [1, 1] と、3つのベクトルそれぞれの内積を出します。
1番目との点数 = 1×1 + 1×0 = 1
2番目との点数 = 1×0 + 1×1 = 1
3番目との点数 = 1×1 + 1×1 = 2
3番目は、自分自身との点数も出します。
ソフトマックスで重みに直す
点数 [1, 1, 2] を、ソフトマックスで重みに直します。
exp(1) = 2.718
exp(1) = 2.718
exp(2) = 7.389
合計   = 12.825

重み = [2.718 ÷ 12.825, 2.718 ÷ 12.825, 7.389 ÷ 12.825]
     = [0.212, 0.212, 0.576]
重みを掛けて足す
3つのベクトルに、それぞれの重みを掛けて足します。
新しい3番目 = 0.212 × [1, 0] + 0.212 × [0, 1] + 0.576 × [1, 1]
            = [0.212 + 0 + 0.576,  0 + 0.212 + 0.576]
            = [0.788, 0.788]
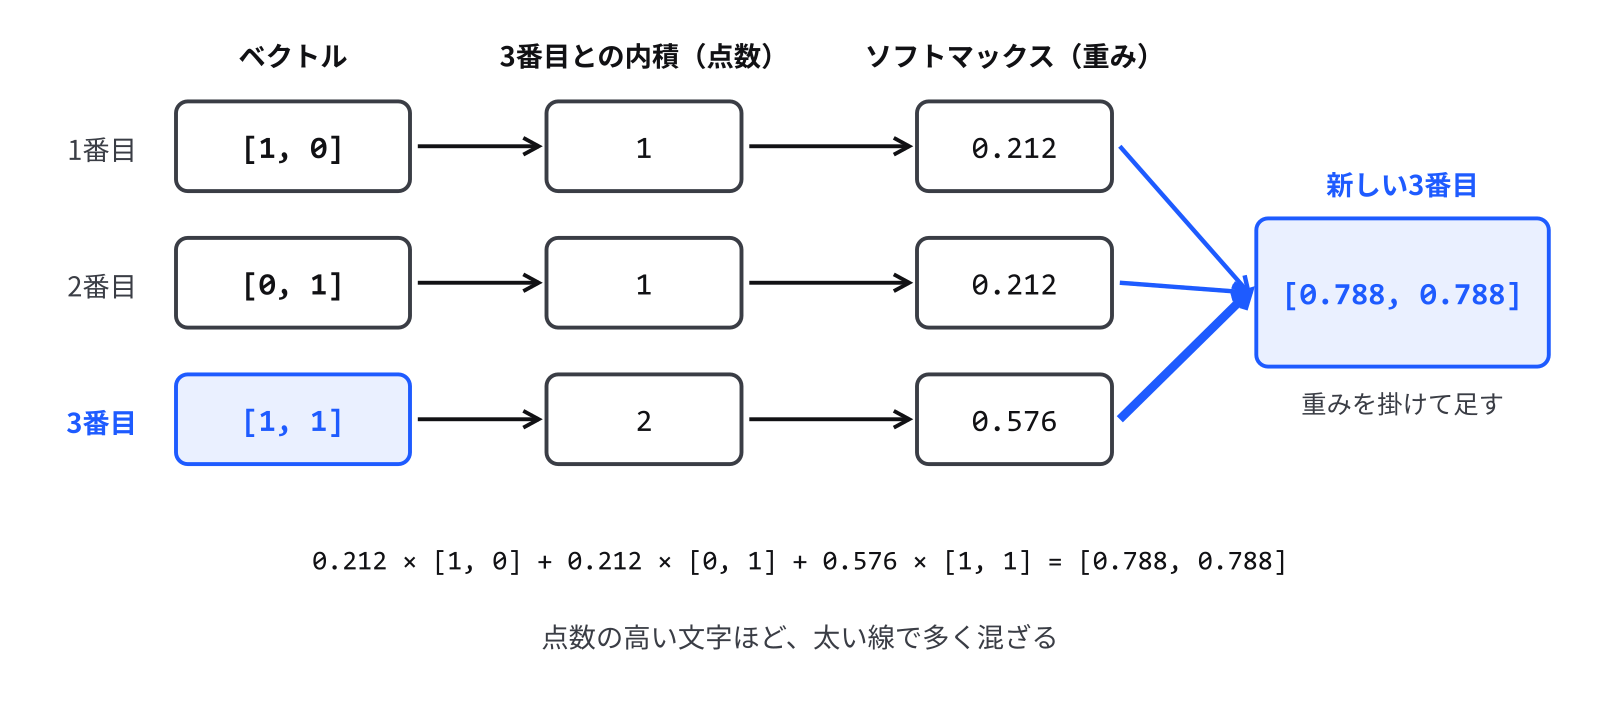
重みは足すと 1 なので、していることは「重みを付けた平均」です。新しい3番目のベクトルは、もとの [1, 1] に、1番目と2番目が 21%ずつ混ざったものになりました。この「混ぜた割合」のことを、アテンションの重みと呼びます。
3つの文字すべてで計算する
3番目だけでなく、3つの文字すべてについて同じことをします。まず、3つのベクトルの全部の組み合わせの内積を、3行3列の表にします。i 行 j 列が、「i 番目の文字から見た、j 番目の文字の点数」です。
        1番目  2番目  3番目
1番目     1      0      1
2番目     0      1      1
3番目     1      1      2
3行目は、さっきの点数 1、1、2 です。この表を、行ごとにソフトマックスにかけます。1行目は点数 [1, 0, 1] なので、exp を取ると [2.718, 1, 2.718]、合計は 6.437 で、重みは [0.422, 0.155, 0.422] です。2行目は点数 [0, 1, 1] なので、重みは [0.155, 0.422, 0.422] です。
重み
1番目の行  [0.422, 0.155, 0.422]
2番目の行  [0.155, 0.422, 0.422]
3番目の行  [0.212, 0.212, 0.576]
それぞれの行の重みで、3つのベクトルを混ぜます。1番目の行は 0.422 × [1, 0] + 0.155 × [0, 1] + 0.422 × [1, 1] = [0.845, 0.578]、2番目の行は [0.578, 0.845]、3番目の行は先ほどの [0.788, 0.788] です。
文字が 16 個でも 1,000 個でも、やることは同じです。「全部の組み合わせの内積の表を作る」「行ごとにソフトマックスで重みにする」「重みでベクトルを混ぜる」の3つです。文字の位置ごとに別々の重みを用意する必要がなく、表の計算は行列の掛け算で書けて、GPU が得意とする計算なので、長い文章でも速く計算できます。これが、アテンションが広く使われるようになった理由の1つです。
先の文字を見ないようにする
上の計算では、1番目の文字が、2番目と3番目の文字も見ています。次の文字を予想するモデルでは、これは困ります。
次の文字を予想するモデルでは、入力と正解を、同じ文章を1つずらして作ります。1番目の文字の所では2番目の文字を当て、2番目の文字の所では3番目の文字を当てます。1番目の文字が、アテンションで2番目の文字のベクトルを混ぜ込めるなら、答えを見てから答えることになります。学習のときだけ損失が下がり、文章を作るときには、まだ書いていない先の文字は見られないので、役に立たないモデルになります。
そこで、自分より後ろの文字の点数を、マイナス無限大(−∞)に書き換えます。点数の表は、次のようになります。
元の点数            マスクのあと
[1, 0, 1]           [1, −∞, −∞]
[0, 1, 1]           [0,  1, −∞]
[1, 1, 2]           [1,  1,  2]
1行目(1番目の文字)は自分だけ、2行目は1番目と自分、3行目は全部を見られます。こういう、見てよい所と見てはいけない所を表す表を、マスクと呼びます。
マイナス無限大にする理由は、ソフトマックスの計算にあります。ソフトマックスは、点数を e の何乗かに直してから合計で割りました。e のマイナス無限大乗は 0 です。その文字の重みがちょうど 0 になり、混ぜる計算にまったく入らなくなります。点数を 0 に書き換えるのではうまくいきません。exp(0) は 1 なので、重みが残ってしまいます。
2行目を手で確かめます。点数は [0, 1, −∞] で、exp を取ると [1, 2.718, 0]、合計は 3.718 です。重みは [0.269, 0.731, 0] になります。1行目は重みが [1, 0, 0] で、3行目は、もともと全部を見てよいので、変わらず [0.212, 0.212, 0.576] です。混ぜたベクトルは、1番目が [1, 0]、2番目が 0.269 × [1, 0] + 0.731 × [0, 1] = [0.269, 0.731]、3番目が [0.788, 0.788] になります。
何を探すかを、学習で決める
ここまでの点数の付け方には、足りない所が2つあります。
1つは、学習で直せる数が1つも無いことです。文字のベクトルが決まれば、点数は内積で決まってしまいます。「『た』の次を予想するときは、2つ前が『も』かどうかを見るとよい」といったことを、データから覚える場所がありません。
もう1つは、同じベクトルどうしの内積を取っているので、自分自身との点数が大きくなりやすいことです。「た」が探したいのは「も」のような別の文字で、自分に似た文字とは限りません。
そこで、内積を取る前に、ベクトルに、学習で直せる数を持つ層を掛けます。層は、ニューラルネットワークの層と同じ、行列を掛ける計算です。役目ごとに、3つの層を用意します。
| 層の名前 | 役目 | たとえ |
|---|---|---|
| クエリ(query、問い合わせ) | 今の文字が「どんな文字を探しているか」を表すベクトルを作る | 探している本の特徴を書いたメモ |
| キー(key、鍵) | それぞれの文字が「自分はどんな文字か」を表すベクトルを作る | 本の背表紙のラベル |
| バリュー(value、値) | 選ばれたときに「相手に渡す中身」のベクトルを作る | 本の中身 |
点数は、「今の文字のクエリ」と「それぞれの文字のキー」の内積にします。メモとラベルが合う本ほど、点数が高くなります。混ぜるのは、もとのベクトルの代わりに、バリューのベクトルです。3つの層の重みは学習で直されるので、どの文字がどの文字を探すかを、モデルがデータから決められます。
さっきの3つのベクトルでは、クエリ・キー・バリューを作る行列が、それぞれ 2 行 2 列で、全部で 12 個の数になります。最初はでたらめな数で、学習が進むにつれて、点数の付き方が変わります。計算の形は、これまでと同じです。点数の表を作る所では、ベクトルそのものの代わりに「クエリ」と「キー」の内積を取り、混ぜる所では、もとのベクトルの代わりに「バリュー」を混ぜます。
これまで:  点数 = ベクトルどうしの内積         混ぜる中身 = もとのベクトル
これから:  点数 = クエリとキーの内積 ÷ √2      混ぜる中身 = バリュー
最初のでたらめな数のままでは、点数に意味はありません。同じベクトルどうしの内積ではなくなったので、自分以外をいちばん多く見ることもできるようになりました。学習が進むと、「た」のクエリが「も」のキーと強く合う、といった点数の付き方を、モデルが見つけていきます。
「÷ √2」は、点数を「ベクトルの長さの平方根」で割っています。ここでは長さが 2 なので √2 です。ベクトルが長くなると、内積は足す項が増えて大きな数になりやすくなります。点数の差が大きいと、ソフトマックスの結果は1つの文字だけに集まります。そうなると、ほかの文字に傾きがほとんど流れず、学習が進みにくくなります。割って大きさをそろえているのは、それを防ぐためです。論文では、この割り算を入れたアテンションを Scaled Dot-Product Attention(大きさをそろえた、内積のアテンション)と呼んでいます。
残りの部品
アテンションのほかに、3つの部品を足します。
位置の埋め込み
アテンションは、重みを付けた平均でした。平均は、足す順番を入れ替えても結果が変わりません。「いぬがさるを」と「さるがいぬを」は、出てくる文字が同じなので、このままでは区別が付きにくくなります。「1つ前の文字」「2つ前の文字」という区別も、ベクトルの中身からは分かりません。
そこで、文字の埋め込みとは別に、「何番目の位置か」を表すベクトルを用意します。0番目の位置のベクトル、1番目の位置のベクトル…と、位置の数だけ行のある表を作り、文字の埋め込みに足します。足したあとのベクトルは、「どの文字か」と「何番目か」の両方を含みます。この表の数も、学習で直されます。
MLP
アテンションは、ほかの文字のベクトルを混ぜるだけです。混ぜて集めた情報から、次の文字を決めるのに役立つ形へ作り変える計算が、もう1段要ります。そのために、アテンションのあとに、文字1つ1つのベクトルを、「重みを掛けてバイアスを足す層、ReLU、もう一度重みを掛けてバイアスを足す層」の2層のネットワークに通します。これを MLP(エムエルピー。multilayer perceptron、多層パーセプトロン)と呼びます。論文では Feed Forward(フィードフォワード)という名前で出てきます。
アテンションが「文字と文字の間で情報を運ぶ」係で、MLP が「1文字ごとに、集まった情報を加工する」係です。
足し戻す
アテンションと MLP は、どちらも「通した結果で置き換える」代わりに、「通した結果を、通す前のベクトルに足す」形にします。式で書くと「新しい x = x + アテンション(x)」です。
こうすると、もとの文字が何だったかという情報が、アテンションで混ぜたあとも残ります。もう1つ、学習の面での理由があります。足し算は、逆伝播のときに傾きをそのまま通します。層を何十個も重ねても、出口の傾きが入口の近くまで弱まらずに届きます。この足し戻す道を、残差接続(ざんさせつぞく)と呼びます。画像認識のモデル ResNet の論文が広めた工夫です。
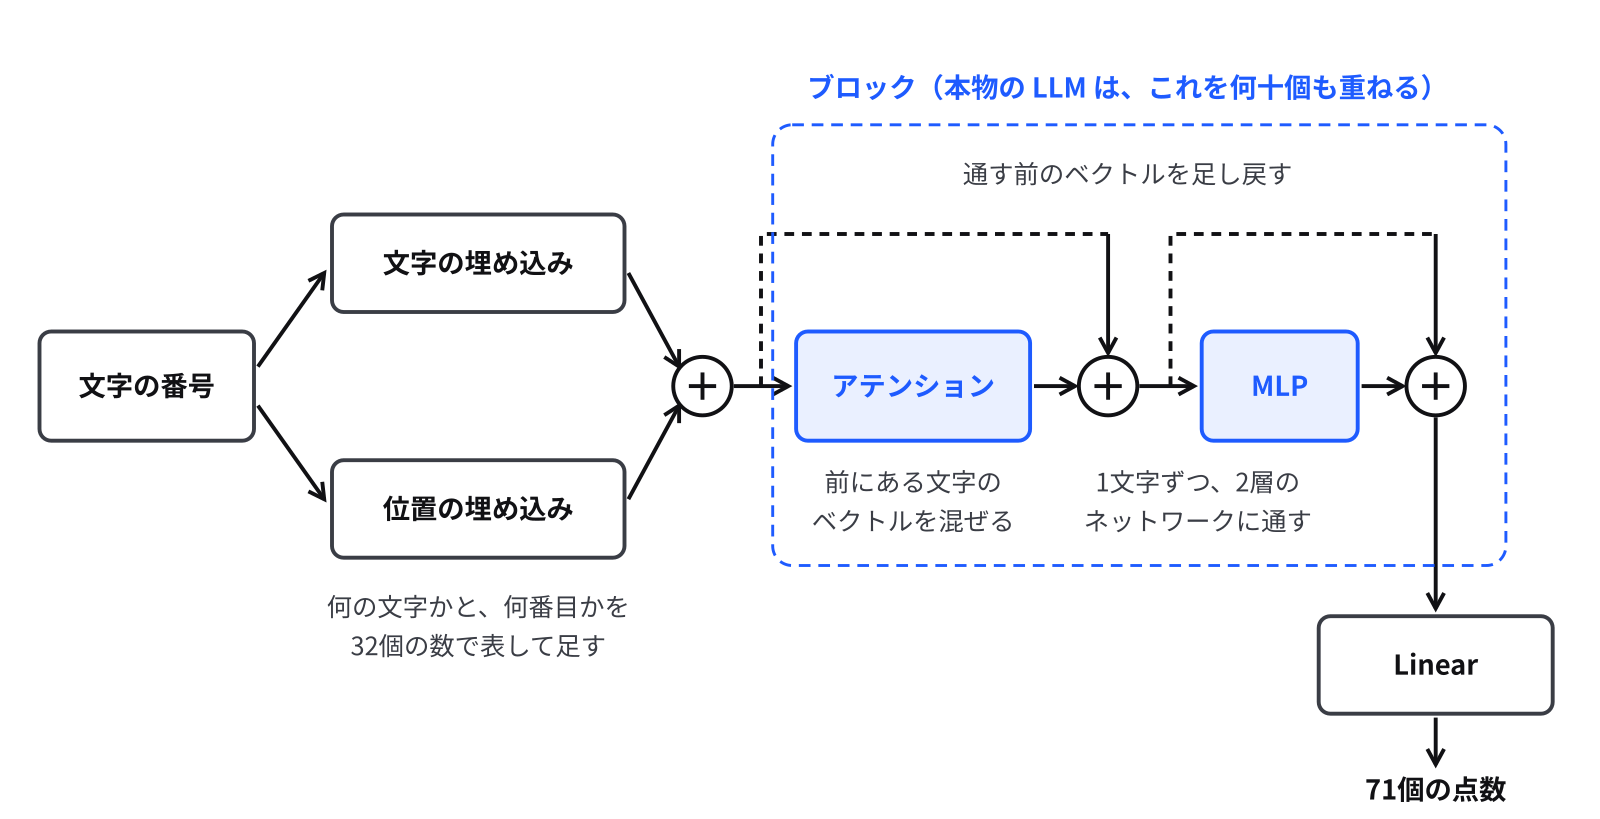
アテンション、MLP、2つの足し戻しをまとめたものを、ブロック(または層)と呼びます。図の小さな Transformer はブロックが1つですが、本物の LLM はこれを何十個も重ねています。
課題:紙でアテンションを計算する
3つの文字のベクトルが、次のとおりだとします。クエリ・キー・バリューの層は使わず、「3つのベクトルで手計算する」の節と同じやり方で計算してください。exp(1) = 2.718、exp(2) = 7.389 を使います。
1番目 = [2, 0]
2番目 = [0, 1]
3番目 = [1, 1]
- 3番目から見た、3つの文字の点数を出してください
- その点数を、ソフトマックスで重みに直してください
- 新しい3番目のベクトルを出してください
- 先を見ないマスクを付けたとき、2番目から見た重みと、新しい2番目のベクトルを出してください
答えと解説
- 3番目 [1, 1] との内積は、1番目が 1×2 + 1×0 = 2、2番目が 1×0 + 1×1 = 1、3番目が 1×1 + 1×1 = 2 で、点数は [2, 1, 2] です
- exp を取ると [7.389, 2.718, 7.389]、合計は 17.496 で、重みは [0.422, 0.155, 0.422] です
- 0.422 × [2, 0] + 0.155 × [0, 1] + 0.422 × [1, 1] = [0.844 + 0 + 0.422, 0 + 0.155 + 0.422] = [1.267, 0.578] です(四捨五入のしかたで、最後の桁が 1 ずれることがあります)
- 2番目 [0, 1] との内積は、1番目が 0、2番目が 1 です。3番目は後ろにあるので、点数をマイナス無限大にします。exp を取ると [1, 2.718, 0]、合計は 3.718 で、重みは [0.269, 0.731, 0] です。新しい2番目は 0.269 × [2, 0] + 0.731 × [0, 1] = [0.538, 0.731] です
この記事で出てきた言葉
| 言葉 | 意味 |
|---|---|
| Transformer | アテンションを中心に組み立てたニューラルネットワークの形。今の LLM のほとんどが使っている |
| アテンション | ほかのトークンに点数を付け、ソフトマックスで重みにして、ベクトルを混ぜ合わせる仕組み |
| アテンションの重み | それぞれのトークンをどれだけの割合で混ぜたか。足すと 1 になる |
| マスク | 見てよい所と見てはいけない所を表す表。後ろのトークンの点数をマイナス無限大にする |
| クエリ・キー・バリュー | 「何を探しているか」「自分は何か」「渡す中身」を表すベクトルを作る、3つの層 |
| 位置の埋め込み | 何番目の位置かを表すベクトル。トークンの埋め込みに足す |
| MLP(Feed Forward) | アテンションのあとに、1トークンずつ通す2層のネットワーク |
| 残差接続 | 層に通した結果を、通す前のベクトルに足し戻す道 |
| ブロック | アテンション・MLP・足し戻しをまとめたもの。重ねて使う |
続けて読む記事
Transformer を発表した論文「Attention Is All You Need」は、ここまでの内容を知っていれば要点を読める論文です。論文の図1(Transformer の全体の図)と、3.2 節の式 Attention(Q, K, V) を、この記事の計算と見比べてみてください。
参考にした資料
- 3Blue1BrownJapan「GPT解説2 アテンションの仕組み (Attention, Transformer) | Chapter6, 深層学習」(約26分。クエリ・キー・バリューが、この記事と同じ意味で出てきます)
- 3Blue1BrownJapan「LLMはどう知識を記憶しているか | Chapter 7, 深層学習」(約22分。ブロックの中の MLP の説明です)
- Vaswani ほか「Attention Is All You Need」(2017)