AI に文章やコードを頼むと、自然な日本語やそれらしいコードで答えが返ってきます。ところが、その中に事実と違うことが混ざっていることがあります。この記事では、AI がどんなときに、なぜ間違えるのかを、AI の仕組みから考えます。そのうえで、間違いを見つける確かめ方と、AI に入れてはいけない情報を整理します。
仕組みについて、先に2つだけ確かめておきます。
- LLM(ChatGPT・Gemini・Claude の中で文章を書いているモデル)は、ここまでの文章を読んで、続きの言葉としてそれらしいものを1つずつ予想して書いています
- モデル(AI の中にある、入力から答えを出す決まりのまとまり)が作られるのは学習のときだけです。チャットで質問しているときは、できあがったモデルを使って答えを出す推論をしていて、モデルの中身は変わりません。チャットで何かを教えても、モデルは覚えません
もっともらしい間違いが起きる理由
続きを予想する仕組みには確かめる工程がない
LLM は、「ここまでの文章の続きとして、最もそれらしい言葉は何か」を予想して書いています。この「それらしい」は、学習に使った大量の文章の中で、その続き方がどれだけありがちだったかで決まります。
ある大学の図書館が何時に開くかを聞いた場面で考えます。
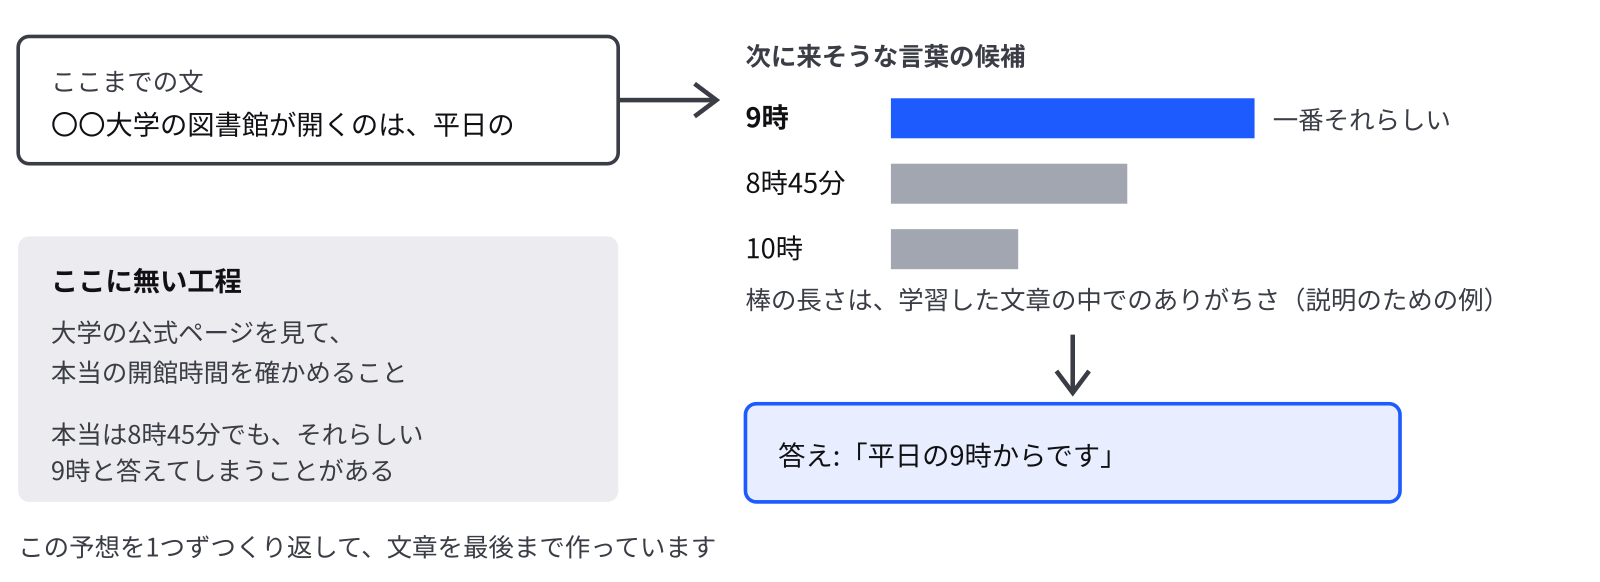
「〇〇大学の図書館が開くのは、平日の」の続きとして、学習した文章の中では「9時」がありがちだったとします。LLM は「9時」を選び、「平日の9時からです」と書きます。この大学の図書館が本当は8時45分に開くとしても、その大学のページを開いて確かめる工程は、この仕組みの中にありません。
その大学の開館時間がインターネット上の文章に何度も書かれていれば、学習の中でその続き方を覚えていて、正しく答えられることもあります。書かれた回数が少ない事実ほど、ほかの大学のありがちな時間に引っぱられて、それらしい別の答えになります。
こうしてできた間違いの文は、正しい答えと同じように自然な日本語で、迷いのない言い方で書かれます。LLM は、正しい答えを書くときも間違った答えを書くときも、同じようにそれらしい続きを選んでいるだけだからです。読む側からは、言い方だけで正しいか間違いかを見分けられません。AI が事実と違うことをもっともらしく書いてしまうことを、ハルシネーション(英語で幻覚の意味)と呼びます。
「本当ですか」と聞いても確かめたことにならない
間違いかもしれないと思ったとき、同じチャットで「本当ですか」と聞き返したくなります。これでは確かめたことになりません。
「本当ですか」と聞かれたあとの答えも、ここまでのやりとりの続きとしてそれらしい文です。疑われたあとの続きとしては「申し訳ありません、間違えていました」という文がありがちなので、もとの答えが正しくても謝って別の答えに変えることがあります。間違った答えのまま「はい、正しいです」と言い切ることもあります。どちらの場合も、外の情報を見て確かめたわけではありません。確かめるには、AI の外にある信用できる情報を自分で見る必要があります。
間違いやすい場面
続きを予想する仕組みと、学習と推論の分かれ方から、間違いが出やすい場面が決まってきます。
| 場面 | 間違いやすい理由 | 例 |
|---|---|---|
| 細かい事実(人名・数字・日付・出典) | 1文字や1桁違っても、文としては同じくらい自然に見える。それらしい別の数字や名前が選ばれやすい | 本の出版年、人の肩書き、法律の条文の番号 |
| ネットにあまり書かれていないこと | 学習した文章の中に少ししか出てこないので、似たほかのものの話に引っぱられる | 近所の店の定休日、自分の大学の細かい決まり、サークルの予定 |
| 最近の出来事 | モデルが学習したのは、ある時点までに集めた文章だけ。推論の最中には新しいことを学ばない | 今年の出来事、最新の製品、変わったばかりの制度 |
| 文字を数える | モデルは文章をトークンというかけらに区切って読んでいる | 「この文は何文字ですか」「『の』はいくつありますか」 |
| 桁の多い計算 | 計算の手順を踏まずに、答えの数字をそれらしく予想してしまうことがある | 4桁どうしの掛け算、割引のあとの合計金額 |
最近の出来事について補足します。学習に使う文章は、ある時点で集めるのを締め切ります。この締め切りを知識のカットオフと呼びます。カットオフより後の出来事はモデルの中にありませんが、聞かれればそれらしい続きを書いてしまいます。今のサービスの多くは、質問に合わせてインターネットを検索し、見つけたページを読んでから答える機能を持っています。答えにリンクや出典の一覧が付いているときは、検索して答えています。この場合は最近の出来事も答えられますが、ページの読み間違いや古いページを使った間違いは起きます。付いているリンクを自分で開いて確かめるのは同じです。
文字を数える場合は、LLM が文章をトークンというかけらに区切って受け取ることが理由です。「日本の首都は東京です。」という11文字の文は、あるモデルでは8つほどのかけらに区切られます(区切り方はモデルによって違います)。モデルが受け取るのはこのかけらで、11個の文字を1つずつ見ているわけではありません。単語のカードを渡されて、カードの中を見ずに全部で何文字かを答えるような状態です。サービスによっては、裏でプログラムを動かして数えるので、正しく答えることもあります。
得意なこととの違い
多少ずれていても困らない作業は得意です。
| 得意なこと | 間違っても困りにくい理由 |
|---|---|
| 文章の要約、言い換え、下書き | 元の文章が手元にあるので、自分で読み比べて直せる |
| アイデアをたくさん出す | 出たものから自分で選ぶので、変なものが混ざっても捨てればよい |
| 難しい説明を易しい言葉に直す | 分からなければ聞き直せる。大事な所は元の説明に戻って確かめられる |
| 翻訳 | 元の文がある。意味の大きなずれは、読めば気づきやすい |
得意なことと苦手なことの違いは、答えを自分で確かめられるかどうかです。苦手なことの側にある答えは、自分の知らないことを聞いていることが多く、間違っていても気づけません。そちらの答えは確かめるようにします。
コードを頼んだときの間違い
AI にプログラムを書いてもらうときも、同じ仕組みで間違いが起きます。コードも「それらしい続き」として書かれているからです。
| 間違い | 何が起きるか |
|---|---|
| 存在しない関数やコマンドを使う | それらしい名前で書かれているが、その言語には無い。動かすとエラーになる |
| 存在しない部品の名前を出す | 「このライブラリ(ほかの人が作ったプログラムの部品)を入れてください」と、実在しない名前を勧める。似た名前で悪意のある部品が置かれていることもあるので、入れる前に公式のページで実在を確かめる |
| 古い書き方を使う | 学習した時点より後に変わった書き方を知らず、今は使えない書き方を出す |
| 動くが、頼んだ仕様と少し違う | 「以上」と「より大きい」の取り違えのように、ふつうの値では動いて、境界の値でだけ間違う |
| テストを通すために、テストのほうを書き換える | 失敗するテストを、コードを直す代わりに消したり、条件をゆるくしたりする |
どれも、もっともらしい報告と一緒に出てきます。AI が書いたコードは、自分で動かし、変わった所を読み、テストを走らせて確かめます。
答えを一次情報で確かめる
確かめるときに見るのは一次情報です。一次情報は、その情報を出した本人が自分で出している情報です。図書館の開館時間ならその大学の図書館の公式ページ、法律ならその条文、会社の新しい製品ならその会社の発表のページ、研究の結果ならその論文が一次情報です。ほかの人のブログやまとめサイトは、一次情報をもとに書かれた二次的な情報で、読み間違いや古い内容が残っていることがあります。大事なことは一次情報までたどります。
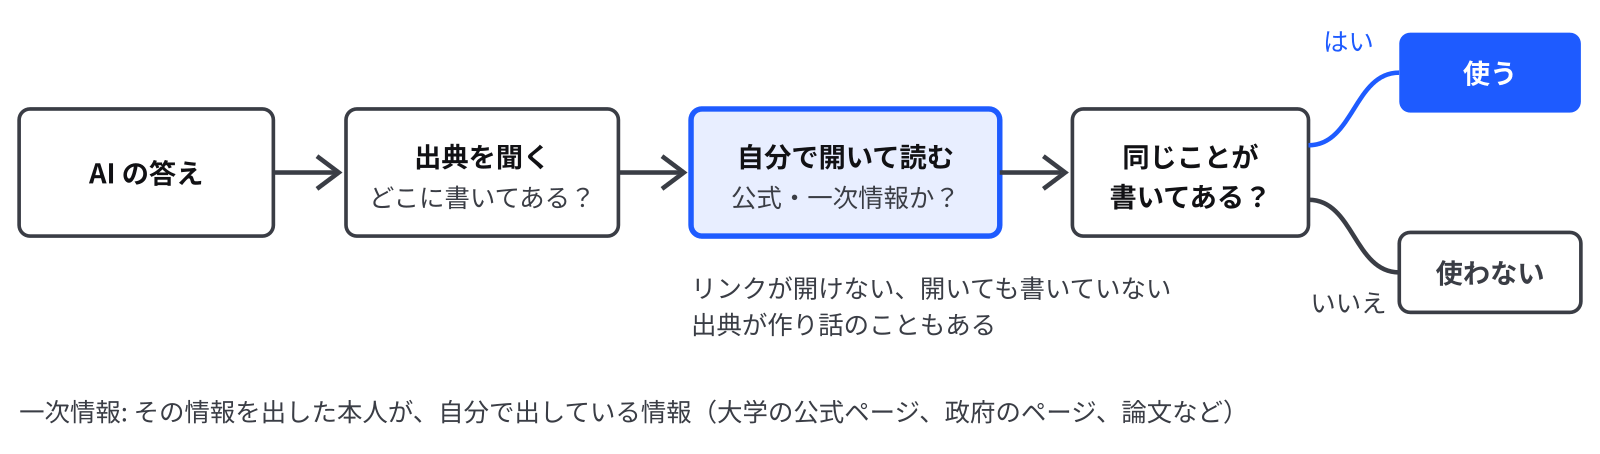
- AI の答えの中で、確かめる必要がある所(事実・数字・日付・名前)に印を付ける
- AI に「それはどこに書いてありますか。URL を教えてください」と聞く
- 返ってきたリンクを自分で開き、それが一次情報かどうかを見る
- 開いたページに、AI の答えと同じことが書いてあるかを読む
- 同じなら使う。違っていたり、リンクが開けなかったり、開いても書いていなかったりしたら、その答えは使わない
2 で出てくる出典そのものが作り話のことがあります。存在しない本の名前や、開くと「ページが見つかりません」と出る URL を、それらしく書くことがあります。出典の書き方も、続きを予想して作った文の一部だからです。3 で自分で開くところまでが、確かめる手順に入ります。出典が見つからないときは、自分で検索して一次情報を探します。
AI の間違いを1つ見つける
実際に AI に質問して、間違いを1つ見つけてみます。見つけたら、正しい情報とその出どころ(URL)をメモします。
まず試しやすい例です。次の文の文字数と、文の中の「の」の数を AI に聞きます。
次の文は、句読点も含めて何文字ですか。また、「の」は何回出てきますか。
大阪の駅前にある小さなパン屋では、毎朝六時から焼きたてのクロワッサンとメロンパンを売っていて、開店前から近所の人たちが列を作っています。
正しい答えは、68文字で、「の」は3回です。AI の答えが違っていたら、それが1つ目の間違いです。正しく答えたときは、答えの中に「プログラムで数えました」のような説明やコードの枠が出ていないかを見てください。サービスが裏でプログラムを動かして数えたときは、正しくなることが多いです。
次は、自分で質問を考えます。「間違いやすい場面」の表から場面を1つ選びます。たとえば次のような質問です。
- 自分の大学の細かい事実(学部ができた年、図書館の開館時間、学食のメニュー)
- 地元の、有名でない店の定休日や営業時間
- 「〇〇について書かれた本を3冊、著者名と出版年つきで教えてください」
- 好きなアニメやスポーツの細かい記録(第何話の題名、ある選手の去年の成績)
1つの AI で間違いが見つからなければ、ほかの AI でも同じ質問をします。答えの中の事実は、上の手順で一次情報で確かめます。見つけたら、送った質問・AI の答え・正しい情報・正しい情報の出どころの4つをメモします。AI が「分かりません」「確かな情報はありません」と答えることもあります。知らないことを知らないと言えているのでよい答えです。その場合は、もっと細かい事実や、本の出版年のように数字が出てくる質問にしてみてください。
答えの偏りに気をつける
AI は、学習に使った例の中から決まりを見つけます。例が少なかったり片寄っていたりすると、たまたま成り立っていただけの決まりを覚えてしまいます。たとえば、迷惑メールを分ける AI が、学習に使ったふつうのメールにたまたま全部「の」が入っていたせいで、「『の』が入っていなければ迷惑」と覚えてしまうような場合です。
LLM は、学習に使った大量の文章の中でよく出てくる考え方や組み合わせに寄った答えを返しやすくなります。これを偏り(バイアス)と呼びます。画像を作る AI に「料理をしている人」の画像を何枚か作らせると、同じ性別や同じ年代の人ばかりになることがあります。学習に使った画像や文章の中で、その組み合わせが多かったからです。学習に使われた文章は英語のものが多いので、日本の事情を聞いても、海外の事情を前提にした答えが返ることもあります。
偏りのある答えは、ハルシネーションと違って、1つ1つの事実が間違っているわけではありません。答えに入っていない見方があることに、読む側が気づきにくいのが困る所です。答えを読んだら、「ほかの立場の人から見たらどうか」「日本の場合はどうか」と考えたり、AI に「別の見方を3つ挙げてください」と聞き直したりします。
AI に入れてはいけないもの
AI に送った文章は、サービスを作っている会社のコンピュータに送られ、そこで推論が行われます。自分のスマホやパソコンの中で答えを作っているわけではありません。送った内容は、会社のコンピュータに記録として残ります。
チャットの最中にモデルが書き換わることはありません。ただし、会社が利用者とのやりとりを集めておいて、あとで次のモデルの学習に使うことはあります。記録された内容を、問題がないかを確かめるために会社の人が読むこともあります。多くのサービスには、送った内容を学習に使わせないための設定があります。ChatGPT なら「設定」の「データコントロール」の中にある、モデルの改善に関する項目です。この設定をオフにしても、送った文章が会社のコンピュータに届くことは変わりません。入れてはいけないものは、設定に関係なく同じです。
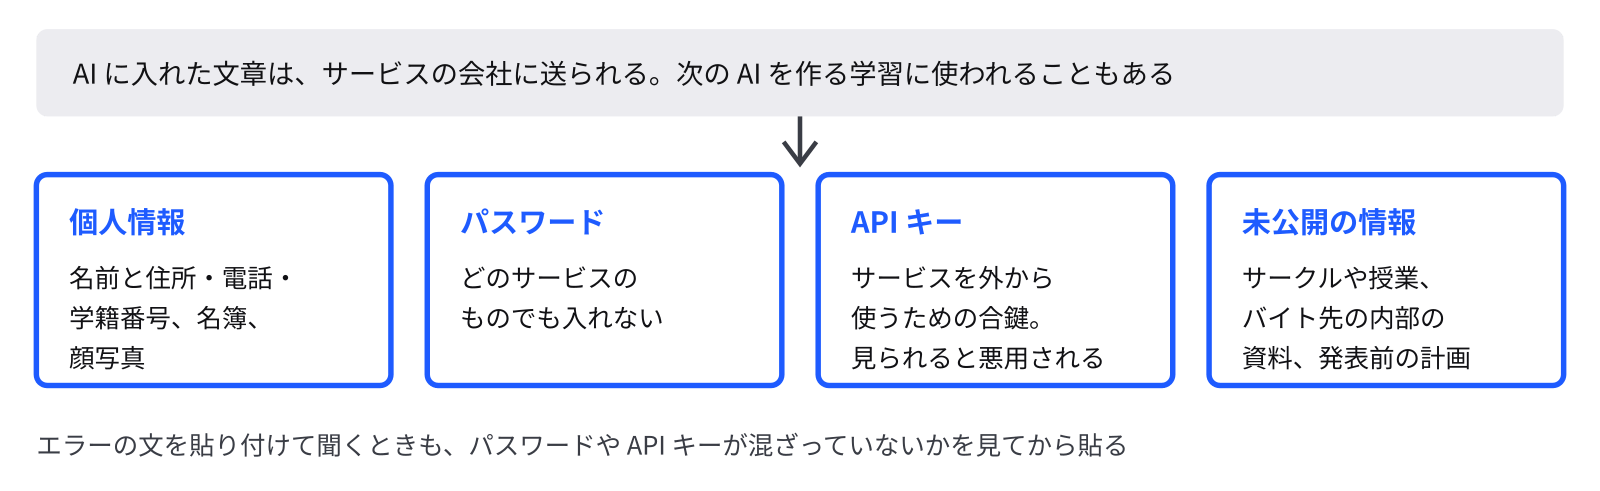
| 入れないもの | 例 | 入れると困る理由 |
|---|---|---|
| 個人情報 | 本名と住所・電話番号・学籍番号の組み合わせ、サークルの名簿、他人の写真 | 誰のことか分かる情報が、自分の手の届かない所に残る。他人の情報は、その人の許しなく外に出すことになる |
| パスワード | どのサービスのものでも | 記録を見た人がログインできてしまう |
| API キー | AI などのサービスを、自分の作ったプログラムから使うための合鍵の文字列 | 見られると勝手に使われ、使われた分の料金を請求されることがある |
| 未公開の情報 | 授業やサークル、アルバイト先の内部の資料、発表前の計画 | 外に出してよいかを決めるのは、その情報の持ち主。自分だけでは決められない |
プログラムを書くようになると、エラーの文(うまく動かないときに出る英語の文)を AI に貼り付けて聞くことが増えます。エラーの文や設定のファイルの中身には、パスワードや API キーが混ざっていることがあります。貼る前に一度読んで、混ざっていたらその部分を xxxx などに置き換えてから貼ります。
相談したいことに個人の事情が入るときは、誰のことか分からない書き方にします。「同じサークルの田中さん(3年)が」と書く代わりに「同じサークルの先輩が」と書けば、相談の中身は変わらずに伝わります。
課題やレポートに使うときの決まり
AI を課題やレポートに使ってよいかは、授業ごとに違います。使ってはいけない授業、使ってよいがどこにどう使ったかを書き添える授業、自由に使ってよい授業があります。決まりは、シラバス(授業ごとの計画書)か、先生の最初の授業での説明、授業のページのお知らせに書かれています。書かれていなければ、先生に聞きます。
使ってよい授業でも、AI に書かせた文章をそのまま出すのはやめておきます。理由は3つあります。1つ目は、AI の文章には間違いや偏りが混ざっていることがあり、出したレポートの中身の責任は自分が負うことです。2つ目は、課題は自分が考える練習のために出されていて、AI に書かせるとその分だけ自分の力が付かないことです。3つ目は、出典を書かずに他人の文章を使うのと同じ問題になる場合があることです。
AI は、考える手伝いに使うと役に立ちます。
| 頼み方 | 例 |
|---|---|
| 分からない言葉を聞く | 「授業で出てきた『機会費用』を、例を使って説明してください」 |
| 自分の考えの穴を探してもらう | 「次の主張の弱い所を3つ指摘してください」(自分で書いた文を貼る) |
| 構成の相談 | 「このテーマで書くとき、どういう順番で論を進めるとよいか、案を2つ出してください」 |
| 読み直し | 「誤字と、意味が通りにくい文を指摘してください。直した文は書かないでください」 |
最後の例の「直した文は書かないでください」のように、AI にしてほしくないことを書いておくと、自分で直す練習になります。
参考にした資料
- スタビジ「【6分半で分かる】生成AIでハルシネーションが起きる原因と対策について解説!」(動画。約7分): https://www.youtube.com/watch?v=xaW1JOkVigY
- 総務省「生成AIはじめの一歩~生成AIの入門的な使い方と注意点~」(偽・誤情報、情報流出、モラルの部分): https://www.soumu.go.jp/use_the_internet_wisely/special/generativeai/
- 安野貴博の自由研究「【OpenAI論文を読む】なぜAIは“もっともらしい嘘“をつくのか? ハルシネーションの正体をゆる解説」(動画。約18分): https://www.youtube.com/watch?v=j3ZOOl4y6GQ
- 文部科学省「大学・高専における生成AIの教学面の取扱いについて」(「留意すべき観点」の節): https://www.mext.go.jp/b_menu/houdou/2023/mext_01260.html
- 個人情報保護委員会「生成AIサービスの利用に関する注意喚起等について」(別添1「一般の利用者における留意点」): https://www.ppc.go.jp/news/careful_information/230602_AI_utilize_alert/