画像を見分ける AI は、「この画像は猫」のように正解の付いた例をたくさん見て学習します。これを教師あり学習と呼びます。ところが、正解を用意できない問題もあります。囲碁の1手1手に「この場面での正解の手」を付けることは、強い人間にもできません。ロボットが歩くときの関節の動かし方も、正解を書き出せません。
こういう問題で使うのが、強化学習(きょうかがくしゅう)です。強化学習では、正解の代わりに、行動の結果として報酬(ほうしゅう。点数のこと)だけを渡します。「勝ったら +1、負けたら −1」「転ばずに1歩進んだら +1」のような報酬です。AI は、いろいろな行動を試し、報酬が多くもらえた行動を選ぶようになっていきます。
強化学習は、囲碁で人間のトップ棋士に勝った AlphaGo(2016年)や、ChatGPT のような LLM を「人が良いと感じる答え」に寄せる調整(RLHF。続きの記事で説明します)にも使われています。
この記事では、強化学習の言葉を確かめたあと、いちばん単純な問題の「どのくじ引きを引くか」を手計算で考えます。紙とペンを用意してください。プログラムは書きません。
強化学習の言葉
強化学習では、登場するものに次の名前を付けます。
| 言葉 | 意味 | 囲碁の例 |
|---|---|---|
| エージェント | 行動を選ぶ側。学習する AI | 碁を打つ AI |
| 環境 | エージェントの外の世界。行動を受けて変わる | 碁盤と相手 |
| 状態 | 今の環境の様子 | 今の盤面 |
| 行動 | エージェントが選べること | どこに石を置くか |
| 報酬 | 行動のあとに環境から渡される点数 | 勝ったら +1、負けたら −1、途中は 0 |
| 方策 | 状態ごとに、どの行動を選ぶかの決め方 | 盤面から次の手を決めるやり方 |
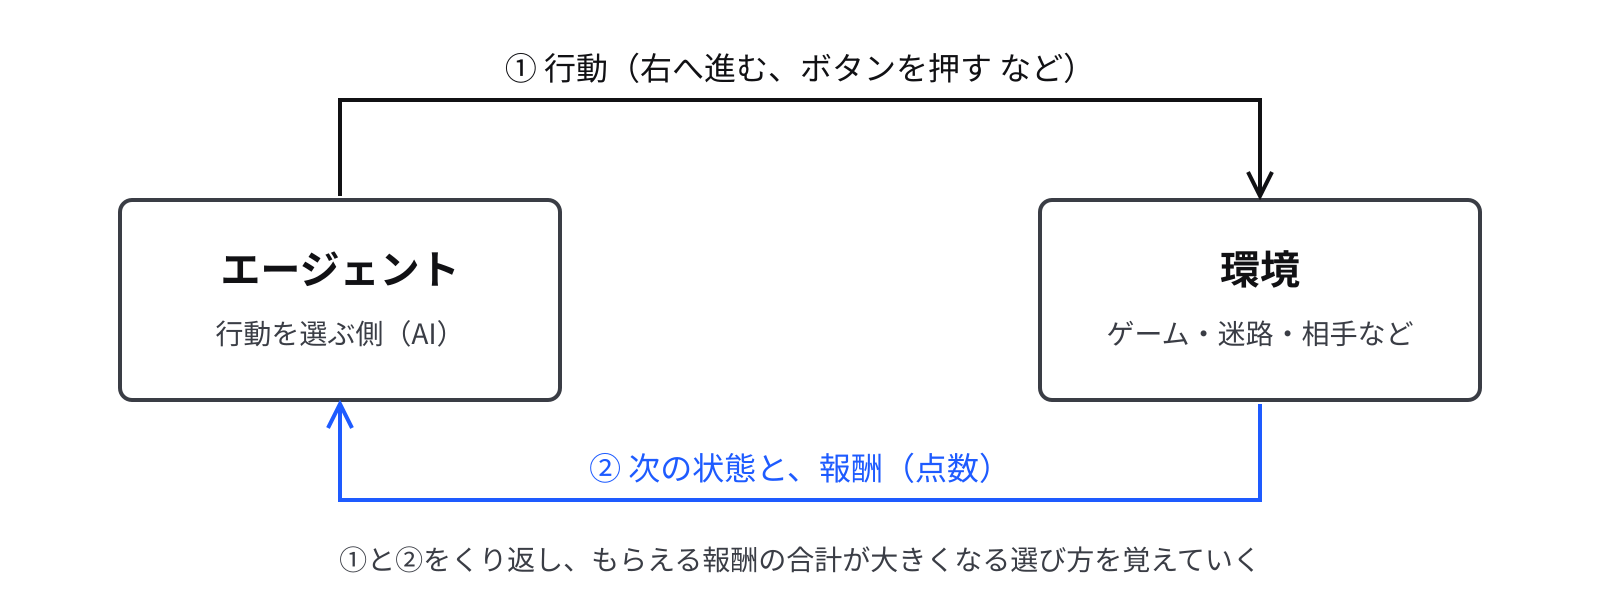
エージェントは行動を選び、環境は次の状態と報酬を返します。これをくり返す中で、エージェントは「報酬の合計が大きくなる方策」を探します。学習の目当ては、1回の報酬ではなく合計です。囲碁では、途中の1手ごとの報酬は 0 で、勝負がついたときにだけ +1 か −1 が来ます。どの手が勝ちに効いたのかを、あとから割り振って覚える必要があります。この「遅れて来る報酬」の扱いは、続きの記事で Q 学習を使って考えます。
教師あり学習との違いを、もう1つ挙げます。教師あり学習では、データは最初から全部そろっています。強化学習では、エージェントが選んだ行動の結果しか分かりません。選ばなかった行動の結果は、分からないままです。そのため、知っている中で一番よい行動を選び続けるか、まだよく分からない行動を試してみるか、という迷いが生まれます。この迷いを、くじ引きの例で見ます。
3台のくじ引きの問題
目の前に、くじ引きの機械が3台(A・B・C)あります。1回引くと、当たりなら報酬 1、はずれなら報酬 0 です。機械ごとに当たりやすさが違いますが、いくつなのかは知らされていません。引ける回数は全部で 100 回です。報酬の合計をできるだけ大きくするには、どう引けばよいでしょうか。
この問題は、カジノのスロットマシン(腕が1本ある機械)がたくさん並んでいる様子から、多腕バンディット問題と呼ばれます。状態が1つしかない、いちばん単純な強化学習の問題です。
行動の価値は、もらえた報酬の平均で見積もる
「その行動を選んだら、平均でどれだけの報酬がもらえるか」を、その行動の価値と呼びます。本当の価値は分からないので、これまでにもらえた報酬の平均で見積もります。見積もった価値を Q と書きます。
機械 A を4回引いて、報酬が 1、0、1、1 だったとします。
1回目のあと: Q = 1 ÷ 1           = 1.0
2回目のあと: Q = (1 + 0) ÷ 2     = 0.5
3回目のあと: Q = (1 + 0 + 1) ÷ 3 = 0.667
4回目のあと: Q = (1 + 0 + 1 + 1) ÷ 4 = 0.75
引くたびに全部を足し直すのは手間なので、1つ前の Q を使って直す書き方がよく使われます。
新しい Q = 今の Q + (1 ÷ 引いた回数) × (今回の報酬 − 今の Q)
3回目のあとの Q = 0.667 から、4回目(報酬 1)で直すと、0.667 + (1 ÷ 4) × (1 − 0.667) = 0.667 + 0.083 = 0.75 で、上の平均と同じになります。
この式は、「予想(今の Q)と実際(今回の報酬)のずれの分だけ、予想を直す」という形をしています。ずれがプラスなら Q を上げ、マイナスなら下げます。この形は、続きの記事の Q 学習でも、ニューラルネットワークの学習(勾配降下法)でも出てきます。
一番よさそうな機械を選び続けると、どうなるか
最初に3台を1回ずつ引いたら、A ははずれ、B は当たり、C ははずれでした。見積もった価値は A = 0、B = 1、C = 0 です。
ここから、いつも Q が一番大きい機械を選ぶことにします。このやり方を、欲張り法(greedy)と呼びます。B を引き続けると、B の Q は当たりやすさに近づいていきます。B の本当の当たりやすさが 0.5 なら、Q は 0.5 の近くに落ち着きます。A と C の Q は 0 のままです。0.5 は 0 より大きいので、欲張り法は B を最後まで引き続けます。
ところが、本当の当たりやすさが A = 0.3、B = 0.5、C = 0.8 だったとしたらどうでしょう。C は最初の1回でたまたまはずれただけで、本当は一番よい機械です。欲張り法では、C を二度と引かないので、それに気づく機会がありません。100 回引いたときの報酬の合計は、B だけを引いた場合で平均 50 くらい、C だけを引いた場合なら 80 くらいです。
試すことと、稼ぐことの釣り合い
今分かっている一番よい行動を選ぶことを活用、よく分からない行動を試すことを探索と呼びます。活用ばかりでは、上のように本当によい行動を見逃します。探索ばかりでは、よい行動が分かっても使わないので、報酬が増えません。この2つの釣り合いを取ることが、強化学習の中心にある課題の1つで、探索と活用のジレンマと呼ばれます。
簡単でよく使われるのが、ε-greedy(イプシロン・グリーディ)というやり方です。毎回、小さな割合 ε(たとえば 0.1)でサイコロを振るように機械をでたらめに選び、残りの 0.9 の割合で Q が一番大きい機械を選びます。
ε = 0.1 なら、100 回のうち 10 回くらいはでたらめに選ぶので、C も何回か引かれます。C を引くと 8 割は当たるので、C の Q は上がっていき、やがて B の Q を追い越します。追い越したあとは、活用で選ばれるのが C になります。でたらめに選ぶ 10 回ぶんは損をしますが、一番よい機械を見つけられることのほうが大きく効きます。
課題:価値の見積もりと選び方
- 機械 D を5回引いて、報酬が 0、1、1、0、1 でした。5回目のあとの Q はいくつですか
- 4回目のあとの Q から、上の「新しい Q = 今の Q + (1 ÷ 引いた回数) × (今回の報酬 − 今の Q)」の式で5回目のあとの Q を出し、1 と同じになることを確かめてください
- 3台の今の Q が A = 0.2、B = 0.6、C = 0.4 です。ε = 0.1 の ε-greedy で次に選ぶとき、B が選ばれる確率はいくつですか。でたらめに選ぶときは、3台を同じ確率で選ぶとします
答えと解説
- 0.6 です。(0 + 1 + 1 + 0 + 1) ÷ 5 = 3 ÷ 5
- 4回目のあとの Q は (0 + 1 + 1 + 0) ÷ 4 = 0.5 です。5回目は報酬 1 なので、0.5 + (1 ÷ 5) × (1 − 0.5) = 0.5 + 0.1 = 0.6 で、1 と同じです
- 0.933 です。0.9 の割合で Q が一番大きい B を選び、0.1 の割合ででたらめに選んだときにも 3分の1 で B が出ます。0.9 + 0.1 × (1 ÷ 3) = 0.9 + 0.033 = 0.933 です
この記事で出てきた言葉
| 言葉 | 意味 |
|---|---|
| 強化学習 | 正解の代わりに報酬だけを渡し、報酬の合計が大きくなる行動の選び方を覚えさせる学習 |
| 教師あり学習 | 正解の付いた例から学習するやり方 |
| エージェント・環境 | 行動を選ぶ側と、行動を受けて変わる外の世界 |
| 状態・行動・報酬 | 今の様子、選べること、行動のあとにもらえる点数 |
| 方策 | 状態ごとに、どの行動を選ぶかの決め方 |
| 価値(Q) | その行動を選んだときに、平均でもらえる報酬の見積もり |
| 探索と活用 | よく分からない行動を試すことと、今一番よい行動を選ぶこと |
| ε-greedy | 小さな割合 ε ででたらめに選び、残りは一番よい行動を選ぶやり方 |
続けて読む記事
この記事のくじ引きには、状態が1つしかなく、報酬もすぐに来ました。迷路やゲームでは、行動によって状態が変わり、報酬はゴールに着いたときにだけ来ます。そういう問題で、状態ごとの行動の価値を覚えていく Q 学習と、LLM の調整での強化学習の使われ方は、「強化学習の仕組み②:Q 学習を小さな迷路で手計算する」で扱います。
参考にした資料
- Richard S. Sutton, Andrew G. Barto「Reinforcement Learning: An Introduction」第2版(強化学習の標準的な教科書。英語。著者のサイトで無料で読めます。この記事の内容は2章に当たります)