Stable Diffusion のような画像生成 AI に「海辺を走る犬のイラスト」と頼むと、数秒から数十秒で画像が返ってきます。この中で動いているのが、拡散モデル(かくさんモデル)です。前の記事「生成モデルの仕組み①:データの分布を覚えて、新しいデータを作る」では、拡散モデルを「ノイズを少しずつ取り除いて作る」と一言で説明しました。
この記事では、その中身を手計算します。本物の画像は何万個もの数の並びですが、ここでは2マスだけの白黒の画像(2つの数の並び)を使います。数が2つでも、計算の形は本物と同じです。電卓(スマホの電卓でかまいません)と紙を用意してください。プログラムは書きません。
拡散モデルがすること
拡散モデルには、2つの向きの流れがあります。
- ノイズを足す流れ: 本物の画像に、でたらめな数(ノイズ)を少しずつ足していき、最後は完全なノイズにする。この流れは決まった計算で、学習しない
- ノイズを取り除く流れ: 完全なノイズから始めて、ノイズを少しずつ取り除き、画像にしていく。ここをニューラルネットワークにさせる
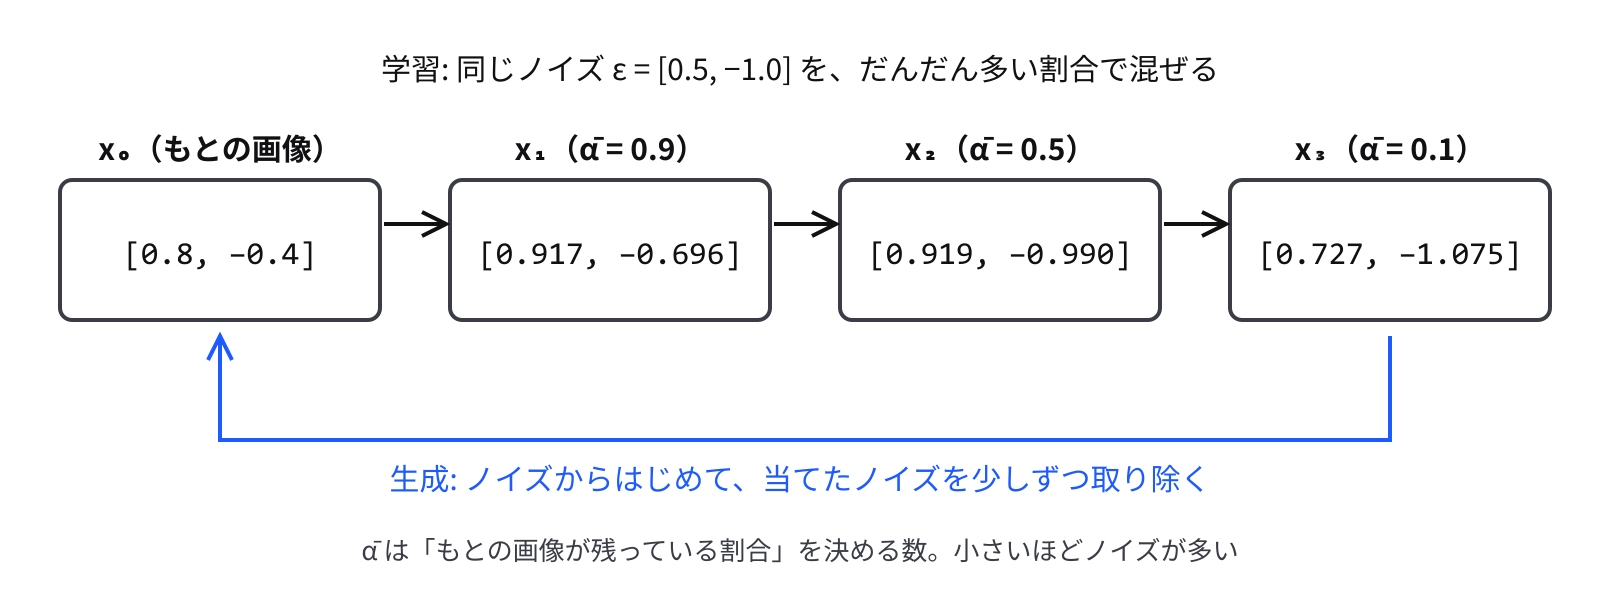
学習するのは、2 の「取り除く」ほうです。ただし、ネットワークに直接「きれいな画像」を答えさせるのではなく、「この画像には、どんなノイズが足されているか」を当てさせます。足されたノイズが分かれば、引けばもとの画像に戻せるからです。
ノイズを足す計算
2マスの画像を x₀ = [0.8, −0.4] とします。数はマスの明るさで、プラスほど白く、マイナスほど黒いとします。
ノイズは、平均 0・標準偏差 1 の正規分布(平均のあたりが出やすい釣り鐘の形の分布)から取り出した数の並びで、ε(イプシロン)と書きます。ここでは ε = [0.5, −1.0] が出たとします。
ノイズを混ぜた画像 xₜ(t は何段目か)は、次の式で作ります。
xₜ = √ᾱₜ × x₀ + √(1 − ᾱₜ) × ε
ᾱₜ(アルファバー)は、「もとの画像がどれだけ残っているか」を決める 0 から 1 の数です。段が進むほど小さくします。ここでは3段だけ使い、ᾱ₁ = 0.9、ᾱ₂ = 0.5、ᾱ₃ = 0.1 とします(本物では 1000 段ほどに分け、最後はほぼ 0 にします)。
1段目(ᾱ₁ = 0.9)を計算します。√0.9 ≈ 0.949、√0.1 ≈ 0.316 です。
x₁ = 0.949 × [0.8, −0.4] + 0.316 × [0.5, −1.0]
   = [0.759, −0.380] + [0.158, −0.316]
   = [0.917, −0.696]
2段目(ᾱ₂ = 0.5)と3段目(ᾱ₃ = 0.1)も、同じ式で x₀ から直接作れます。
| 段 | ᾱ | √ᾱ(画像の割合) | √(1 − ᾱ)(ノイズの割合) | xₜ |
|---|---|---|---|---|
| 0 | 1 | 1 | 0 | [0.8, −0.4] |
| 1 | 0.9 | 0.949 | 0.316 | [0.917, −0.696] |
| 2 | 0.5 | 0.707 | 0.707 | [0.919, −0.990] |
| 3 | 0.1 | 0.316 | 0.949 | [0.727, −1.075] |
段が進むほど、画像の割合が下がり、ノイズの割合が上がります。3段目では、もとの画像はほとんど残っていません。本物の画像で同じことをすると、写真がだんだん砂嵐のようになっていきます。
√ を使っているのは、混ぜたあとの数の散らばりの大きさを、どの段でもそろえるためです。画像の割合の2乗とノイズの割合の2乗を足すと、ᾱ + (1 − ᾱ) = 1 になります。
ノイズを当てる学習
学習では、次のことをくり返します。
- 本物の画像 x₀ を1枚選ぶ
- 段 t をでたらめに1つ選び、ノイズ ε を取り出して、上の式で xₜ を作る
- ネットワークに xₜ と t を渡し、足されたノイズを当てさせる。当てたノイズを ε̂(イプシロンハット)と書く
- 当てたノイズ ε̂ と本当のノイズ ε のずれ(損失)を出し、ずれが小さくなるように重みを直す
損失には、差を2乗して平均を取る平均二乗誤差を使います。2段目の x₂ = [0.919, −0.990] を見て、ネットワークが ε̂ = [0.4, −0.8] と当てたとします。
ε̂ − ε = [0.4 − 0.5, −0.8 − (−1.0)] = [−0.1, 0.2]
損失   = ((−0.1)² + 0.2²) ÷ 2 = (0.01 + 0.04) ÷ 2 = 0.025
正解(足したノイズ)は自分で作ったものなので、人が正解を付ける作業は要りません。画像さえたくさんあれば、何段目のどんなノイズでも、いくらでも練習問題を作れます。重みを直す計算は、ほかのニューラルネットワークと同じ誤差逆伝播法です(「誤差逆伝播法を手計算する」)。
ノイズを取り除いて画像を作る
当てたノイズから、もとの画像を見積もる
ノイズを足す式を、x₀ について解き直すと、次の式になります。
x₀ の見積もり = (xₜ − √(1 − ᾱₜ) × ε̂) ÷ √ᾱₜ
本当のノイズ ε = [0.5, −1.0] を入れると、x₂ からもとの画像にぴったり戻ります。
([0.919, −0.990] − 0.707 × [0.5, −1.0]) ÷ 0.707
= ([0.919, −0.990] − [0.354, −0.707]) ÷ 0.707
= [0.566, −0.283] ÷ 0.707
= [0.8, −0.4]
ネットワークが当てた ε̂ = [0.4, −0.8] を入れると、次のようになります。
([0.919, −0.990] − 0.707 × [0.4, −0.8]) ÷ 0.707
= ([0.919, −0.990] − [0.283, −0.566]) ÷ 0.707
= [0.636, −0.424] ÷ 0.707
= [0.9, −0.6]
本物の [0.8, −0.4] に近いけれど、少しずれた見積もりになりました。ノイズの当て方がずれると、見積もった画像もずれます。
一度に戻さず、1段ずつ戻す
ノイズの多い段では、当てたノイズのずれが大きく、一度で x₀ に戻すと、ぼやけた画像になります。そこで、見積もった x₀ を、1段前(ノイズが少し少ない段)の割合で、もう一度混ぜ直します。よく使われるやり方の1つ(DDIM と呼ばれるやり方)では、次の式で1段戻します。
xₜ₋₁ = √ᾱₜ₋₁ × (x₀ の見積もり) + √(1 − ᾱₜ₋₁) × ε̂
2段目から1段目(ᾱ₁ = 0.9)へ戻します。
x₁ = 0.949 × [0.9, −0.6] + 0.316 × [0.4, −0.8]
   = [0.854, −0.569] + [0.126, −0.253]
   = [0.980, −0.822]
この x₁ をネットワークにもう一度渡し、ノイズを当て直して、また1段戻します。ノイズの少ない段ほど、当てるのが簡単になるので、見積もりは段を下りるたびに本物らしくなっていきます。
生成は、完全なノイズから始める
ここまでは、もとの画像から作った x₂ を戻しました。新しい画像を作るときは、もとの画像はありません。正規分布から取り出した完全なノイズを一番上の段の xₜ として、ネットワークでノイズを当てては1段戻す、を一番下の段までくり返します。最後に出てきたものが、新しい画像です。
始めのノイズが違えば、できる画像も違います。同じ指示でも画像生成 AI が毎回違う絵を返すのは、始めのノイズを毎回取り出し直しているからです。
文章で指示する仕組み
「海辺を走る犬」のように文章で指示できるのは、ノイズを当てるネットワークに、xₜ と t に加えて、指示の文章を数の並び(ベクトル)に直したものも渡しているからです。学習では、画像と、その画像を説明した文章の組を使います。ネットワークは「この説明の画像なら、このノイズの下にはこういう画像がある」という当て方を覚えるので、生成のときに渡した文章に合った方向へ、ノイズが取り除かれていきます。
Stable Diffusion では、計算を軽くする工夫も入っています。画像をそのまま扱うと数が多すぎるので、先に VAE(画像を少ない数に縮め、作り戻すネットワーク)で縮めた数の並びの上で拡散モデルを動かし、最後に作り戻して画像にします。この形を、潜在拡散モデルと呼びます。
課題:3段目で計算する
3段目の x₃ = [0.727, −1.075](ᾱ₃ = 0.1)を使います。√0.1 ≈ 0.316、√0.9 ≈ 0.949 です。
- ネットワークが ε̂ = [0.5, −1.0](本当のノイズと同じ)と当てたとき、x₀ の見積もりはいくつですか
- ネットワークが ε̂ = [0.4, −0.8] と当てたとき、損失(平均二乗誤差)と、x₀ の見積もりはいくつですか
- 2 の見積もりのずれを、記事の2段目での見積もり([0.9, −0.6])のずれと比べてください。ノイズの多い段から一度に戻さない理由を、この結果から説明してください
答えと解説
- [0.8, −0.4] です。([0.727, −1.075] − 0.949 × [0.5, −1.0]) ÷ 0.316 = ([0.727, −1.075] − [0.474, −0.949]) ÷ 0.316 = [0.253, −0.126] ÷ 0.316 ≈ [0.8, −0.4](四捨五入で最後の桁がずれることがあります)
- 損失は 2段目と同じ 0.025 です。見積もりは ([0.727, −1.075] − 0.949 × [0.4, −0.8]) ÷ 0.316 = ([0.727, −1.075] − [0.380, −0.759]) ÷ 0.316 = [0.347, −0.316] ÷ 0.316 ≈ [1.1, −1.0] です
- 2段目では本物の [0.8, −0.4] から [0.1, −0.2] ずれただけでしたが、3段目では [0.3, −0.6] ずれました。ノイズの当て方のずれが同じでも、ノイズの多い段では √ᾱ(小さい数)で割るので、ずれが何倍にも大きくなります。一度で戻さず、少しずつ戻して当て直すのは、このためです
この記事で出てきた言葉
| 言葉 | 意味 |
|---|---|
| 拡散モデル | ノイズを当てて少しずつ取り除くことで、データを作る生成モデル |
| ノイズ(ε) | 正規分布から取り出した、でたらめな数の並び |
| ᾱₜ | 段 t で、もとの画像がどれだけ残っているかを決める数 |
| ε̂ | ネットワークが当てたノイズ |
| DDIM | 見積もった画像を1段前の割合で混ぜ直して、1段ずつ戻すやり方の1つ |
| 潜在拡散モデル | VAE で縮めた数の並びの上で拡散モデルを動かす形。Stable Diffusion が使っている |
続けて読む記事
拡散モデルが画像で使われる一方、文章を作る LLM は自己回帰モデル(次のかけらを1つずつ作る形)が中心です。その仕組みは、「LLM が次の1文字を予想する仕組みを、数えた確率の表で考える」と「Transformer のアテンションを小さな数で手計算する」で手計算しています。
参考にした資料
- Ho, Jain, Abbeel「Denoising Diffusion Probabilistic Models」(2020)(ノイズを当てる学習の形を示した論文)
- Song, Meng, Ermon「Denoising Diffusion Implicit Models」(2020)(DDIM の論文)
- Rombach ほか「High-Resolution Image Synthesis with Latent Diffusion Models」(2021)(潜在拡散モデル。Stable Diffusion のもとになった論文)