AI には、大きく分けて2種類の使い方があります。1つは、写真が猫か犬かを見分ける、明日の売り上げを予測する、のように、入力に対して答えを1つ出す使い方です。もう1つは、文章・画像・音声のように、新しいデータを作る使い方です。後者に使うモデルを生成モデルと呼び、生成モデルを使った AI をまとめて生成AI と呼びます。
見分けるモデルは、「この画像なら猫」という入力と答えの関係を覚えます。生成モデルが覚えるのは、データそのものの「ありそうな形」です。猫の写真をたくさん見て、「猫の写真らしい画像とはどういうものか」を覚え、そこから新しい1枚を作ります。
この記事では、その「ありそうな形を覚える」とはどういうことかを、小さな例で手計算します。そのあと、今使われている生成モデルの4つの作り方を整理します。紙とペンを用意してください。プログラムは書きません。
データの分布を覚えて、サンプルを作る
身長のデータで考える
ある大学の学生 5 人の身長(cm)が、次のとおりだったとします。
160, 165, 170, 175, 180
このデータに似た「6人目の身長」を、新しく作りたいとします。5人のどれかをそのまま写すと、作ったことになりません。かといって、でたらめに 30 cm や 250 cm を出しても、ありそうな身長になりません。
そこで、データから「どのあたりの値が、どのくらい出やすいか」を覚えます。これをデータの分布(ぶんぷ)と呼びます。身長のようなデータは、平均のあたりが一番出やすく、平均から離れるほど出にくい、釣り鐘の形の分布(正規分布)でよく近似できます。正規分布は、平均と標準偏差(散らばりの大きさ)の2つの数で形が決まります。
平均     = (160 + 165 + 170 + 175 + 180) ÷ 5 = 170
分散     = ((−10)² + (−5)² + 0² + 5² + 10²) ÷ 5 = 250 ÷ 5 = 50
標準偏差 = √50 ≈ 7.07
「平均 170、標準偏差 7.07 の正規分布」を覚えたことになります。正規分布では、全体の約 68%が平均 ± 標準偏差(約 163〜177 cm)の中に入ります。この分布からくじを引くように値を1つ取り出すと、168.4 や 176.9 のような、5人のどれとも同じではないのに、ありそうな身長が出てきます。分布から値を取り出すことをサンプリング、取り出した値をサンプルと呼びます。
生成モデルがしていることは、この2つです。
- データから、分布を覚える(学習)
- 覚えた分布から、サンプルを取り出す(生成)
平均や分散の計算は、「AI を読むための統計の基本」で説明しています。
画像では、分布を数で書き出せない
身長は数が1つなので、平均と標準偏差の2つの数で分布を書けました。画像はそうはいきません。縦横 64 マスのカラー画像は、1マスに赤・緑・青の3つの明るさがあるので、64 × 64 × 3 = 12,288 個の数の並びです。猫の写真らしい画像は、この 12,288 個の数が「ちょうどよく組み合わさった」ものです。どのマスが明るいと隣のマスも明るくなりやすいか、といった数どうしの関係まで含めて分布を覚える必要があり、平均と標準偏差では書けません。
そこで、分布をニューラルネットワークで表します。どうやって表すかの違いで、生成モデルはいくつかの種類に分かれます。
4つの作り方
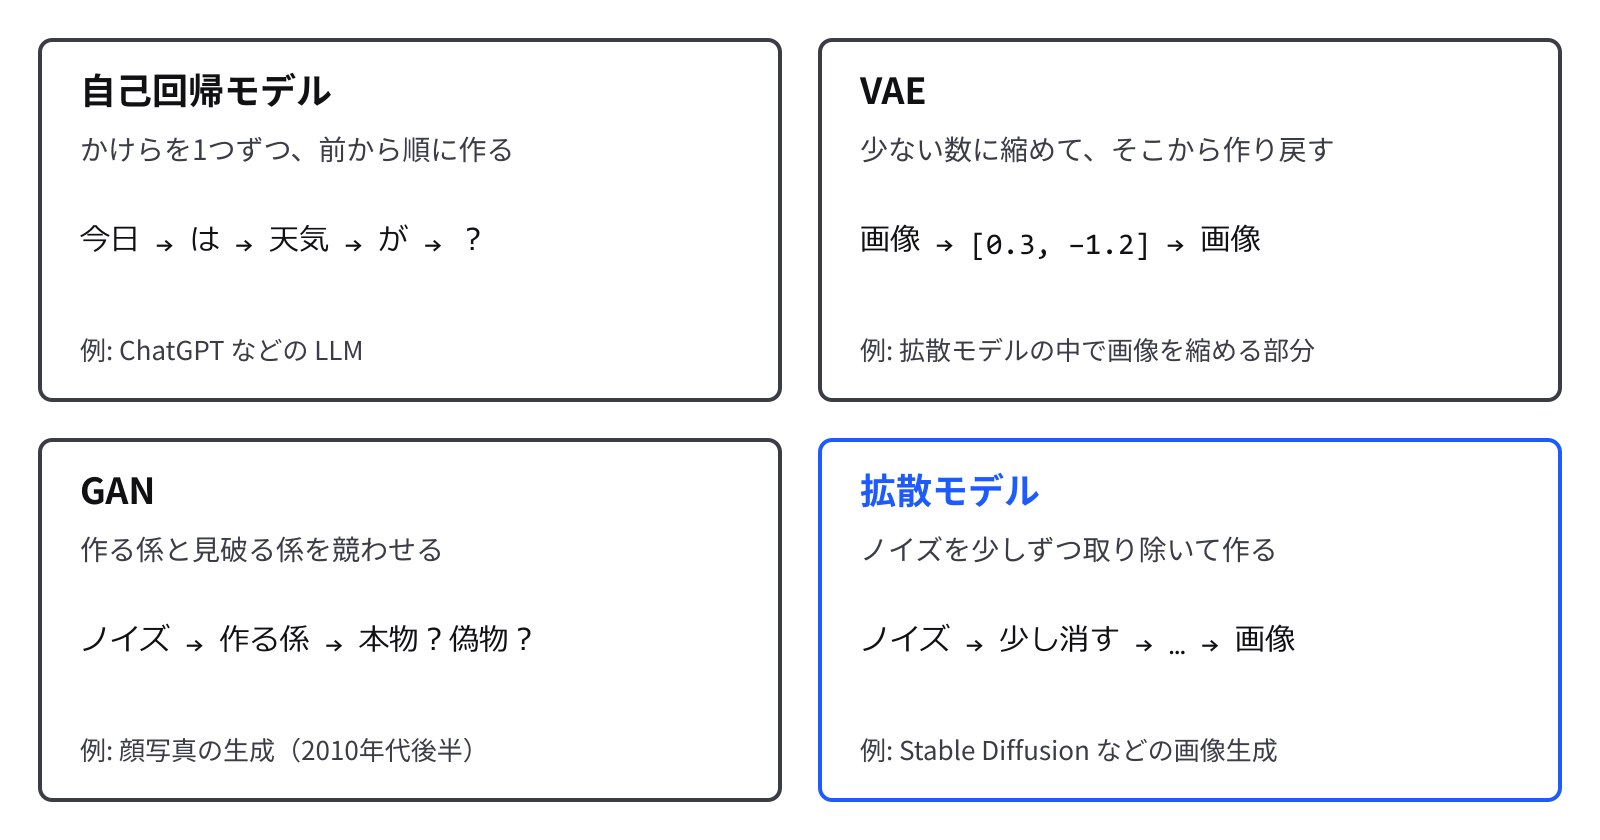
自己回帰モデル:かけらを1つずつ、前から順に作る
文章全体の分布を一度に覚えるのは大変です。そこで、「ここまでの部分を見て、次のかけら1つの分布を出す」問題に分けます。文章ならかけらはトークン(文字や言葉のかけら)で、画像なら1マスです。ChatGPT などの LLM は、この形の生成モデルです。
分けても、文章全体の確率はかけ算で出せます。短い文章「すもも」の確率を、次の確率から出してみます。
1文字目が「す」の確率        = 0.1
「す」の次が「も」の確率      = 1.0
「すも」の次が「も」の確率    = 0.875

「すもも」の確率 = 0.1 × 1.0 × 0.875 = 0.0875
1つ1つの「次のかけらの確率」さえ出せれば、どんなに長い文章でも、確率を掛けていけば全体の確率になります。生成するときは、次のかけらの分布からサンプルを1つ取り出し、後ろにつなげて、また次の分布を出す、をくり返します。
この形の仕組みと、次の文字の確率の出し方は、「LLM が次の1文字を予想する仕組みを、数えた確率の表で考える」で手計算しています。前から1つずつ作るので、長い文章や大きな画像を作るほど時間がかかる、という弱みがあります。
VAE:少ない数に縮めて、そこから作り戻す
VAE(Variational Autoencoder、変分オートエンコーダー)は、2013 年に発表された作り方です。2つのネットワークを使います。
- エンコーダー: 画像を、少ない数(たとえば2つの数 [0.3, −1.2])に縮める
- デコーダー: 少ない数から、もとの画像を作り戻す
縮めた数の並びを、潜在変数(せんざいへんすう)と呼びます。学習では、作り戻した画像がもとの画像に近くなるようにすると同時に、潜在変数の分布が、平均 0・標準偏差 1 の正規分布に近くなるようにします。こうしておくと、生成するときは、正規分布から2つの数を取り出してデコーダーに渡すだけで、新しい画像が作れます。身長の例と同じく、「簡単な分布からサンプルを取り出す」ところまで問題を戻しているのが工夫です。
作れる画像がぼやけやすいという弱みがあり、今は単独で使うより、拡散モデルの中で画像を小さく縮める部品として使われることが多くなっています。
GAN:作る係と見破る係を競わせる
GAN(Generative Adversarial Networks、敵対的生成ネットワーク)は、2014 年に発表された作り方です。ここでも2つのネットワークを使います。
- 生成器(作る係): でたらめな数の並び(ノイズ)を受け取り、画像を作る
- 識別器(見破る係): 画像を受け取り、本物のデータか、生成器が作った偽物かを、確率で答える
識別器は、本物には 1 に近く、偽物には 0 に近い確率を付けるように学習します。生成器は、自分の作った画像に識別器が 1 に近い確率を付ける(だまされる)ように学習します。偽札を作る人と見破る人が、互いに腕を上げていく関係にたとえられます。競い合いが進むと、生成器は本物と見分けにくい画像を作るようになります。
2010 年代の後半には、本物と区別できないほどの顔写真を作れるようになり、話題になりました。一方で、2つの学習の釣り合いがくずれると学習が進まなくなる、同じような画像ばかり作るようになる、といった扱いにくさがあります。
拡散モデル:ノイズを少しずつ取り除いて作る
拡散モデルは、2020 年ごろから画像生成で広く使われるようになった作り方で、Stable Diffusion などの画像生成 AI の中心になっています。
学習では、本物の画像に少しずつノイズ(でたらめな数)を足していき、最後は完全なノイズにします。ネットワークには、ノイズの混ざった画像を見て「どんなノイズが足されたか」を当てさせます。生成するときは逆に、完全なノイズから始めて、当てたノイズを少しずつ取り除いていきます。何十回も取り除くと、画像が現れます。
1回に取り除くノイズは少しなので、1回ごとの問題は簡単で、学習が安定します。そのぶん、何十回もネットワークに通すので、生成に時間がかかります。この仕組みは、続きの記事で小さな数を使って手計算します。
4つの比べ
| 作り方 | 作り方の考え | よく使われる場面 | 弱み |
|---|---|---|---|
| 自己回帰モデル | 次のかけらの分布を出し、1つずつつなげる | 文章(LLM) | 長いものほど作るのに時間がかかる |
| VAE | 少ない数に縮めて、作り戻す | 拡散モデルの部品 | 単独では画像がぼやけやすい |
| GAN | 作る係と見破る係を競わせる | 顔などの画像 | 学習の釣り合いを取りにくい |
| 拡散モデル | ノイズを少しずつ取り除く | 画像・動画・音声 | 何十回も通すので時間がかかる |
課題:分布とサンプル
- 5人の身長が 150, 160, 170, 180, 190 のとき、平均と標準偏差はいくつですか。記事の例(160〜180)と比べて、サンプルとして出てくる身長はどう変わりますか
- 「も」の次が「も」の確率が 0.875、「の」の確率が 0.125 です。「すも」から始めて、次の2文字が「もの」になる確率を出してください。「すもも」の次が「の」になる確率も 0.125 とします
- GAN の識別器が、生成器の作った画像に 0.5 の確率を付けるようになりました。これはどういう状態だと考えられますか
答えと解説
- 平均は 170、分散は (400 + 100 + 0 + 100 + 400) ÷ 5 = 200、標準偏差は √200 ≈ 14.1 です。平均は同じですが、散らばりが2倍になるので、サンプルも 156〜184 cm のように、もっと広い範囲から出てくるようになります
- 0.875 × 0.125 ≈ 0.109 です。「すも」の次が「も」(0.875)、「すもも」の次が「の」(0.125)で、掛け合わせます
- 識別器が、本物か偽物かを当てずっぽうと同じ割合でしか答えられなくなった状態です。生成器の作った画像が、識別器から見て本物と区別できないところまで来た、と考えられます
この記事で出てきた言葉
| 言葉 | 意味 |
|---|---|
| 生成モデル | データの分布を覚えて、新しいデータを作るモデル |
| 分布 | どの値が、どのくらい出やすいか |
| サンプリング・サンプル | 分布から値を取り出すことと、取り出した値 |
| 自己回帰モデル | 次のかけらの分布を出して、前から1つずつ作るモデル |
| VAE・潜在変数 | 少ない数に縮めて作り戻すモデルと、その縮めた数の並び |
| GAN | 作る係(生成器)と見破る係(識別器)を競わせて学習するモデル |
| 拡散モデル | ノイズを少しずつ取り除いて、データを作るモデル |
続けて読む記事
拡散モデルが、ノイズを足す計算と、ノイズを当てて取り除く計算を、2マスだけの小さな画像で手計算するのが、「生成モデルの仕組み②:拡散モデルを小さな数で手計算する」です。
参考にした資料
- Kingma, Welling「Auto-Encoding Variational Bayes」(2013)(VAE の論文)
- Goodfellow ほか「Generative Adversarial Networks」(2014)(GAN の論文)
- Ho, Jain, Abbeel「Denoising Diffusion Probabilistic Models」(2020)(拡散モデルが広く使われるきっかけになった論文)