HTMLとCSSでホームページを作っている間は、データベースを意識する機会があまりありません。会社名やプロフィールを書き換えたいときは、HTMLを直せば済みます。
ところが、ログインした利用者の情報、投稿された記事、予約、注文、商品の在庫などは、画面を閉じたあとも残らなければなりません。しかも、利用者の操作に応じて増えたり変わったりします。こうした情報を保存し、必要なときに取り出せるようにするのがデータベースです。
コーディングエージェントを使うと、データベースの処理もかなりのところまで書いてもらえます。ただし、データベースの変更は、CSSの変更とは性質が違います。間違えて既存のデータを消すと、コードを元に戻しただけでは復旧できないことがあります。
この記事では、SQLを一から書けるようになることを目指しません。エージェントが作ったテーブル、マイグレーション、データ取得処理を見たときに、何が変わるのか、どこを確認すべきかが分かるところまでを扱います。
データベースの見た目は表に近い
一般的なWebアプリでは、同じ種類の情報を「テーブル」にまとめます。たとえば、利用者を保存するusersテーブルなら、次のような形です。
| id | name | |
|---|---|---|
| 1 | 佐藤 | sato@example.com |
| 2 | 鈴木 | suzuki@example.com |
横一行が一人分のデータです。一つひとつの項目を列と呼びます。idは、それぞれの行を区別するための値です。
最初は、次の言葉が分かれば十分です。
- テーブル:同じ種類の情報をまとめる場所
- 行:利用者や記事など、一件分のデータ
- 列:名前、メールアドレス、作成日時などの項目
- ID:一件ずつを区別する値
- スキーマ:どんなテーブルと列を用意するか決めた設計
表計算ソフトと見た目は似ていますが、データベースでは「メールアドレスを重複させない」「存在する利用者だけを記事の作者にできる」といったルールも設定できます。
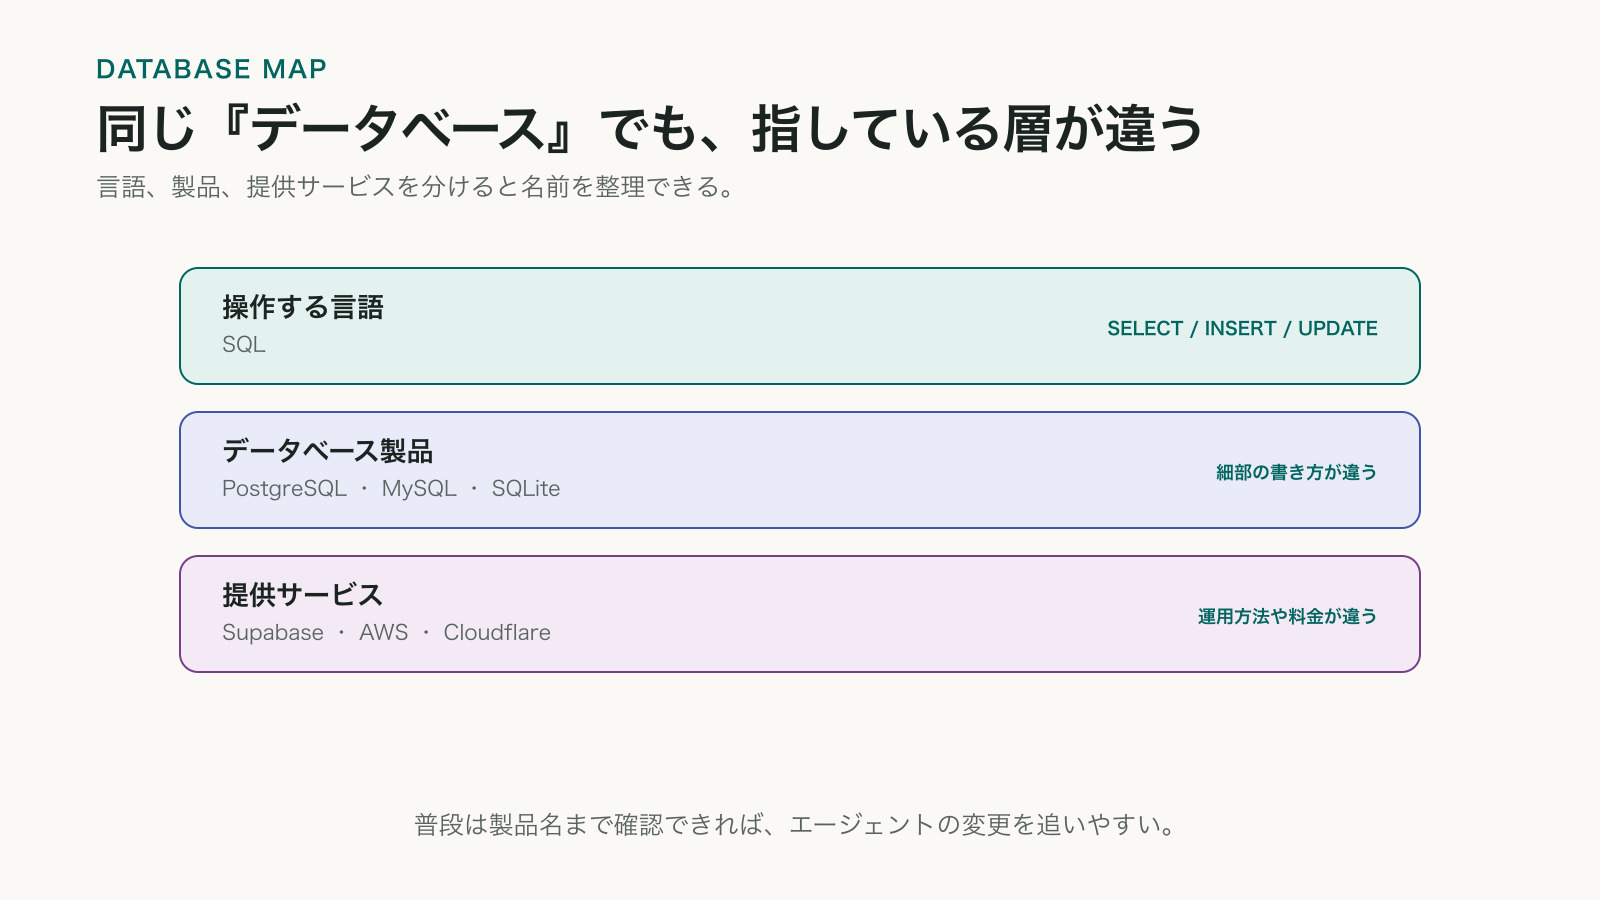
SQLは言葉、PostgreSQLは保存する仕組み、Supabaseはサービス
SQLは、データベースへ指示を出すための言葉です。「記事の一覧を読みたい」「新しい利用者を追加したい」「登録済みの名前を書き換えたい」といった操作を、決められた書き方で伝えます。
PostgreSQLは、そのSQLを受け取り、データを実際に保存したり探したりするソフトウェアです。MySQLやSQLiteも同じ種類の名前で、それぞれSQLを使ってデータを管理します。
Supabaseは、PostgreSQLをインターネット上で使いやすく提供するサービスです。データベースを動かす環境や管理画面に加えて、認証、API、ファイル保存などの機能もまとめて利用できます。
エージェントの説明では、次のような言い方で登場します。
| エージェントの言い方 | 何について話しているか |
|---|---|
| 「SQLを変更しました」 | データベースへ送る指示の内容 |
| 「PostgreSQLへ接続します」 | データを保存・管理するソフトウェア |
| 「Supabaseにプロジェクトを作ります」 | PostgreSQLなどを利用するためのサービスと設定 |
SupabaseとPostgreSQLは、どちらか一方を選ぶ関係ではありません。Supabaseを使うと、その中心にあるPostgreSQLへSQLで指示を送ることになります。
Cloudflare D1もインターネット上で使えるデータベースサービスですが、こちらはSQLiteと同じ系統の仕組みを使います。AWSはさらに広いサービス群の名前で、RDSやAuroraではPostgreSQLやMySQLを選べる一方、DynamoDBのようにSQLを前提としないデータベースも用意されています。
SQLでよく見る単語
エージェントが作ったファイルを見ると、次の単語がよく出てきます。
SELECT
INSERT
UPDATE
DELETE
CREATE TABLE
ALTER TABLE
DROP TABLE
CREATE INDEX
SELECT:データを読むINSERT:新しいデータを追加するUPDATE:既存のデータを書き換えるDELETE:データを削除するCREATE TABLE:テーブルを作るALTER TABLE:既存テーブルの構造を変えるDROP TABLE:テーブルごと削除するCREATE INDEX:検索を速くするための索引を作る
すべての文法を暗記する必要はありません。ただし、DELETE、DROP、ALTERを見かけたら、既存データへの影響をエージェントに説明させてから実行する習慣をつけてください。
MySQL、PostgreSQL、SQLite
SQLには共通の基本がありますが、どのデータベースでもまったく同じように動くわけではありません。使える機能、データ型、細かな書き方に違いがあります。この違いは「SQL方言」と呼ばれることもあります。
MySQL
長く多くのWebサービスで使われてきた、サーバー型のデータベースです。レンタルサーバーでWordPressを使った経験があるなら、裏側でMySQLや、その互換データベースであるMariaDBを使っていたかもしれません。
PostgreSQL
MySQLと同じくサーバー型のデータベースです。複雑な検索、JSON、さまざまなデータ型や拡張機能を扱えます。Supabaseが採用しているのもPostgreSQLです。
SQLite
SQLiteは、アプリとは別にデータベースサーバーを立てるのではなく、通常は一つのファイルへデータを保存する軽量なデータベースです。スマートフォンアプリ、デスクトップアプリ、開発中のテストなど、さまざまな場所で使われています。
ただし、Cloudflare D1は、手元の.sqliteファイルをそのまま公開するサービスではありません。SQLiteのSQLと考え方をもとにした、Cloudflare管理のサーバーレスデータベースです。
同じ目的でも書き方が少し違う
新しい行へ自動的にIDを付ける場合、たとえば次のような違いがあります。
-- MySQL
id INT AUTO_INCREMENT PRIMARY KEY
-- PostgreSQL
id BIGINT GENERATED ALWAYS AS IDENTITY PRIMARY KEY
-- SQLite
id INTEGER PRIMARY KEY
真偽値にも違いがあります。PostgreSQLにはboolean型があります。MySQLのBOOLEANはTINYINT(1)として扱われます。SQLiteには独立した真偽値の保存形式がなく、通常は0と1で保存します。
違いを暗記する必要はありません。見慣れないSQLが出てきたときに、すぐ間違いだと決めつけず、「これはどのデータベース向けのSQLですか」と確認できれば大丈夫です。
Supabase、AWS、Cloudflareを比べる
Supabaseは、機能を早くそろえやすい
Supabaseでは、PostgreSQLに加えて、ログイン、ファイル保存、API、管理画面などをまとめて利用できます。試作品や会員機能のあるアプリを早く作りたいときに便利です。
一方、無料プランで利用の少ないプロジェクトは、一週間の活動状況をもとに停止される場合があります。再開はできますが、久しぶりに開いた試作品がすぐ動かず、理由が分かりにくいことがあります。有料プランのプロジェクトは、利用が少ないことを理由に自動停止されません。
また、ブラウザからデータベースを利用する構成では、Row Level Security(RLS)という権限設定が重要になります。Supabaseは始めやすい一方、公開前には「誰がどの行を読んだり変更したりできるか」を確認する必要があります。
AWSは、できることが多いぶん選ぶことも多い
AWSには、RDS、Aurora、DynamoDBなど、多数のデータベースがあります。データ量、アクセス数、可用性、地域、バックアップ、企業のセキュリティ要件に合わせて細かく構成できます。大きく育ったサービスや、厳しい要件のあるシステムでは、この選択肢の多さが強みになります。
しかし、初めてデータベースを使う人にとっては、エンジン、ネットワーク、接続先、権限、容量、バックアップなど、決める項目が多くなります。エージェントに設定してもらうことはできますが、確認する範囲も広がります。
Cloudflare D1は、最初の構成を小さくしやすい
Cloudflare D1は、WorkersやPagesから利用できる、SQLite系のサーバーレスデータベースです。サーバーの台数や常時接続を最初から管理する必要がなく、Cloudflareのアプリと一緒に扱えます。
設定はwrangler.jsoncなどのファイルに残るため、コーディングエージェントも構成を読み取りやすくなります。マイグレーションもプロジェクト内のSQLファイルとして管理できます。
この教材では、小規模から中規模のWebアプリをコーディングエージェントと作る人に、まずCloudflare D1を勧めます。構成が比較的小さく、読者が確認する場所を絞りやすいからです。
もちろん、どんなサービスにもD1が最適という意味ではありません。D1は一つのデータベースに保存できる容量や同時処理に制限があります。大量の書き込みや大容量データが必要になったら、PostgreSQLやAWSの別サービスを検討します。
プロジェクトのどこを見ればよいのか
データベースを使うプロジェクトでは、次のようなファイルやフォルダーを見かけます。
migrations/0001_create_users.sql0002_add_profile_image.sql
schema.tsdb.tsqueries.tsseed.tswrangler.jsonc.env.local
名前や置き場所はプロジェクトごとに違いますが、役割はおおむね次のとおりです。
schema.ts:テーブルと列の設計をTypeScriptで表したものdb.ts:アプリからデータベースを利用する入口queries.ts:データの読み書きをまとめた処理migrations/:データベース設計の変更履歴seed.ts:開発やテストに使う初期データwrangler.jsonc:CloudflareのアプリとD1を結びつける設定.env.local:接続情報や秘密情報を置くファイル
.envで始まるファイルには、パスワードやAPIキーが入ることがあります。中身を記事、Issue、チャットへそのまま貼らないでください。エージェントに相談するときも、値そのものではなく、変数名だけで説明できることが多いです。
ORMとは何か
PrismaやDrizzleという名前が出てくることもあります。これらはORMと呼ばれ、SQLをすべて直接書かなくても、TypeScriptなどからデータベースを扱えるようにする道具です。
ORMを使うと、エージェントが次のようなTypeScriptを書くことがあります。
const articles = await db.query.articles.findMany();
SQLが見えなくても、裏側ではデータベースへ問い合わせています。ORMを使っているからデータベースを気にしなくてよい、というわけではありません。
マイグレーションは変更手順の記録
データベースを使う開発では、migrationという言葉が頻繁に出てきます。
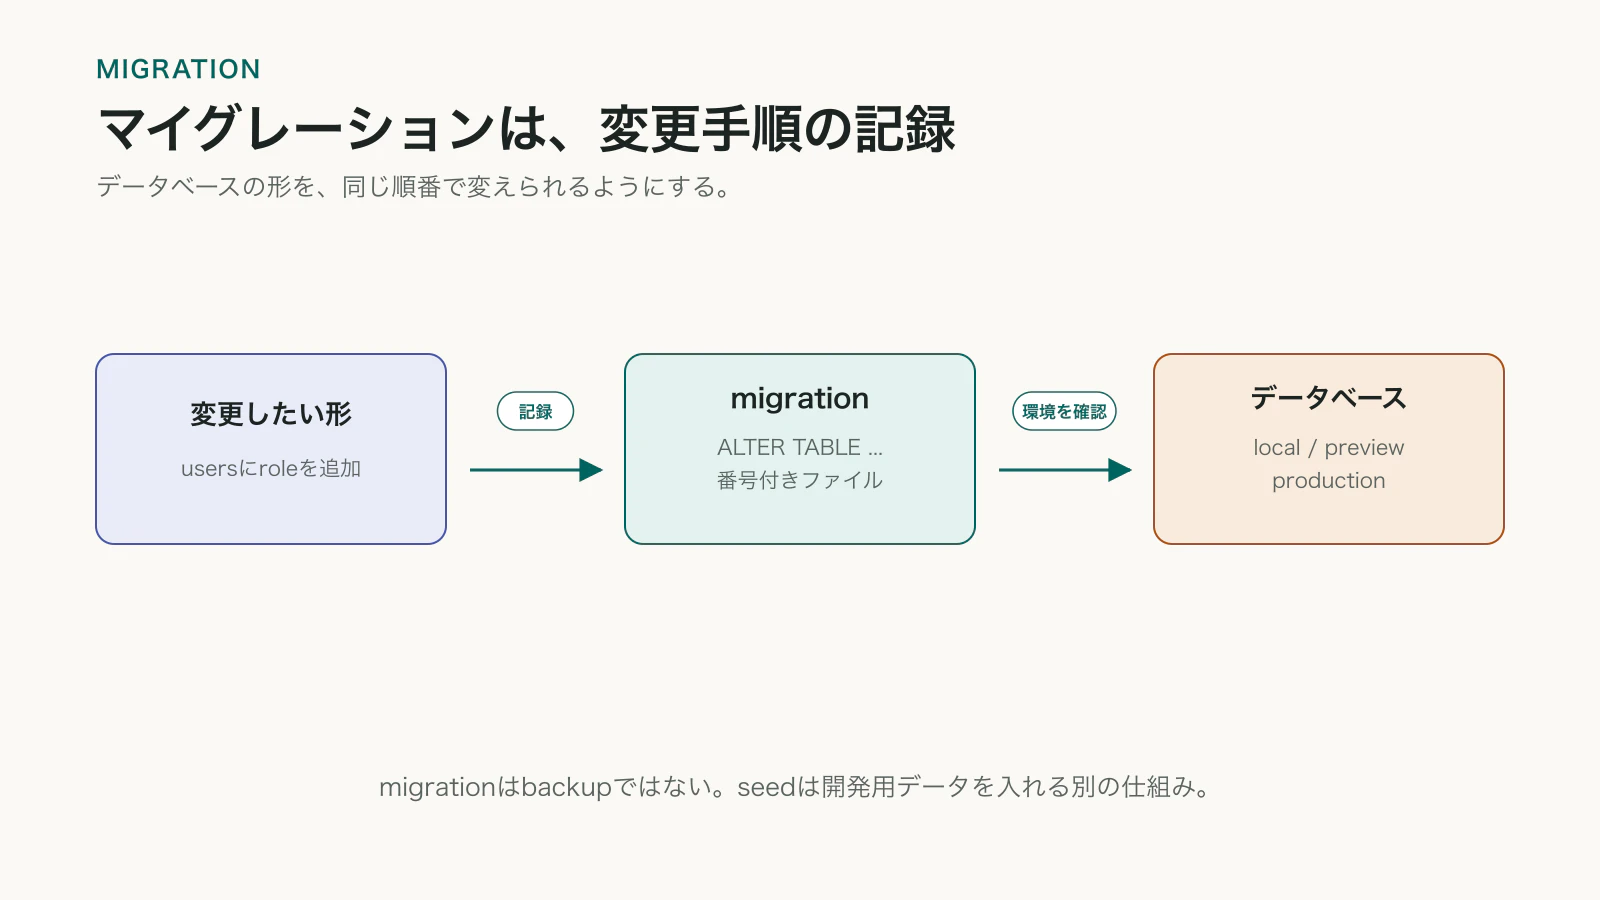
たとえば、すでにあるusersテーブルへ表示名を追加するとします。
ALTER TABLE users ADD COLUMN display_name TEXT;
このSQLは、「usersテーブルへdisplay_nameという列を追加する」という変更です。こうした変更を番号順に保存したファイルがマイグレーションです。
migrations/0001_create_users.sql0002_add_display_name.sql
Gitがコードの変更履歴を管理するのに対し、マイグレーションはデータベースの変更手順を管理します。
ここで大切なのは、コードとデータベースが自動的に同じ状態になるとは限らないことです。schema.tsを変更しても、既存のデータベースにマイグレーションを適用していなければ、新しい列は存在しません。反対に、本番データベースだけを管理画面から直接変更すると、プロジェクト内のマイグレーションと実際の状態が合わなくなります。
適用済みの古いマイグレーションは書き換えない
一度適用された0001_create_users.sqlを書き換えても、すでに動いているデータベースで自動的にやり直されるわけではありません。修正が必要なら、通常は0002_...sqlのような新しいマイグレーションを追加します。
新しい空のデータベースで成功するだけでは十分ではありません。すでに利用者や記事が入ったデータベースへ適用しても安全かを確認する必要があります。
たとえば、既存のusersテーブルへ、空にできない列を追加するとします。
ALTER TABLE users ADD COLUMN plan TEXT NOT NULL;
すでに存在する利用者のplanへ何を入れるのか決まっていなければ、適用に失敗する可能性があります。デフォルト値を用意する、いったん空を許可する、既存データを埋めてから制約を追加するなどの手順が必要です。
マイグレーション、シード、バックアップは別物
名前が近い場所に出てきますが、役割は違います。
- マイグレーション:テーブルや列をどう変更するかという手順
- シード:開発やテストで使う初期データ
- バックアップ:ある時点の実データを復元するための控え
マイグレーションが残っていても、削除した会員情報や注文内容を復元できるとは限りません。破壊的な変更の前には、別途バックアップや復元方法を確認します。
適用先を必ず確認する
エージェントが次のような言葉を使ったら、実行前にどのデータベースが変わるか確認してください。
migratepushapplyremoteproduction
ローカル、開発環境、本番環境では、通常は別のデータベースを使います。デプロイ方法そのものは別の記事で扱いますが、remoteやproductionが付いた操作は手元だけの変更ではない、と覚えておきましょう。
エージェントが作ったスキーマを読む
次の三つのテーブルを例にします。
usersidname
articlesidauthor_idtitle
commentsidarticle_idbody
articles.author_idには、記事を書いた利用者のusers.idが入ります。comments.article_idには、コメント先の記事のarticles.idが入ります。このように、IDを使ってテーブル同士をつなぎます。
スキーマでよく見る指定も確認しておきましょう。
PRIMARY KEY:その行を一つに特定する主キーFOREIGN KEY:別のテーブルの行を参照する外部キーNOT NULL:空のまま保存できないUNIQUE:同じ値を重複して保存できないDEFAULT:値が指定されなかったときに入れる値INDEX:よく使う検索を速くする索引
たとえば、メールアドレスでログインするなら、同じメールアドレスが複数登録されないようにUNIQUEを付けることがあります。記事の作者には、存在する利用者だけを指定できるように外部キーを付けます。
アプリの入力画面でチェックしていても、別の処理や不具合によって不正なデータが入ることがあります。重要なルールは、データベース側にも持たせます。
よくあるデータベースの問題
N+1問題
記事一覧を表示するために、まず記事を一回取得し、そのあと記事ごとに作者を取得する処理を考えます。
const articles = await getArticles();

for (const article of articles) {
  const author = await getUser(article.authorId);
}
記事が100件なら、記事一覧の一回に加えて、作者の取得が100回発生します。合計101回です。これがN+1問題です。
読者が解決コードを暗記する必要はありません。一覧を処理するループの中で、毎回データベースへ問い合わせていないかを確認します。対策には、JOIN、まとめて取得する処理、ORMの関連データ読み込みなどがあります。
インデックス不足
利用者をメールアドレスで探すたびに、usersテーブルを最初から最後まで調べていると、データが増えるほど遅くなります。検索によく使う列へインデックスを付けると、目的の行を探しやすくなります。
ただし、すべての列へ付ければよいわけではありません。インデックスも保存容量を使い、データを書き込むときには更新が必要です。「どの検索で使うインデックスか」を説明できることが大切です。
処理の一部だけ成功する
注文を保存し、在庫を減らす処理で、注文だけ保存されたあとにエラーが起きると、データのつじつまが合わなくなります。
複数の変更を一まとまりとして扱い、全部成功したときだけ確定する仕組みがトランザクションです。エージェントが複数のテーブルを同時に変更するときは、途中で失敗した場合を確認します。
必要以上のデータを読む
何万件もある記事をSELECT *で一度に取得すると、表示もデータベースも重くなります。取得件数の上限やページネーションがあるか確認します。
入力文字列をSQLへ直接つなぐ
利用者が入力した文字をそのままSQLへつなげると、SQLインジェクションという攻撃につながります。値はプレースホルダーへ渡すか、ORMの安全なAPIを使います。
ログインできれば何でも読める状態にする
ログインできることと、すべてのデータを読んでよいことは別です。一般の利用者、記事の作者、管理者では、読めるデータや変更できる範囲が違います。
SupabaseではRLS、Cloudflare WorkersからD1を使う構成ではAPI側の認可などが関わります。実装方法を覚える前に、「認証」と「データへの権限」は別々に確認する、と覚えてください。
エージェントの変更を確認する
データベースを変更してもらったら、次の点を確認します。
- どのテーブルと列が追加、変更、削除されるか
- MySQL、PostgreSQL、SQLiteのどれを対象にしているか
- 新しいマイグレーションが追加されているか
- 適用済みの古いマイグレーションを書き換えていないか
- 既存データが入った状態でも適用できるか
DROP、DELETE、列名変更などの破壊的な変更がないか- 必須列を追加するとき、既存の行へ何が入るか
- 主キー、外部キー、
UNIQUEなどの制約があるか - インデックスを付けた理由を説明できるか
- 一覧のループ内で問い合わせを繰り返していないか
- 一度に全件取得していないか
- ローカル、開発環境、本番環境のどこへ適用するか
- 失敗した場合にデータを戻せるか
エージェントには、次のように頼めます。
今回のデータベース変更を、SQLを書けない人にも分かるように説明してください。 変更されるテーブルと列、既存データへの影響、破壊的な変更の有無を分けてください。
この画面を一回表示したとき、データベースへの問い合わせが何回発生するか確認してください。 N+1問題と、必要以上の全件取得がないかも調べてください。
このマイグレーションを、新しい空のデータベースと、既存データが入ったデータベースの両方で検証してください。 実行前に、適用先がローカル、開発環境、本番環境のどれかを明示してください。
エージェントがSQLを書けることと、その変更が安全であることは同じではありません。何を保存し、どのデータが変わり、失敗したときに戻せるのか。そこを人が確認できれば、データベースを使うAI開発で迷いにくくなります。