アプリを公開して一週間。自分の画面では、今も問題なく動いています。ところが利用者から、「昨日の夜、投稿を保存できなかった」と連絡が来ました。今試すと保存できます。どの利用者の、何時の、どの処理が失敗したのかを示す記録は残っていません。
デプロイの成功は、新しい版を公開できたことを示します。その版が翌日も使えること、外部サービスが止まったときに気づけること、壊れたデータを戻せることまでは保証しません。実際の利用者、増えていくデータ、期限切れになる認証情報、失敗して再試行される処理は、公開後も動き続けます。
運用に必要なのは、画面を一日中見張ることではありません。利用者にとっての正常な状態を決め、それを記録し、異常が続いたときに知らせ、影響を止め、安全に戻せるようにすることです。
「正常に使える」を、利用者の操作で決める
サーバーが起動していて、トップページが200 OKを返していても、データベースへ接続できず投稿を保存できないなら、アプリは正常とは言えません。何を監視するか決める前に、サービスの中心となる操作を少数に絞ります。
たとえば投稿サービスなら、次のような操作です。
- ログインできる
- 投稿を保存できる
- 保存した投稿を再び表示できる
メール通知が中心なら、「送信APIが成功した」だけでなく、Queueから処理され、一定時間内に送信サービスへ渡ったことまでが正常です。決済なら、支払い画面を開けることと、決済後の注文状態が更新されることを分けて見ます。
URLへ定期的にアクセスし、応答が返るかを見るhealth checkは、サーバー全体が停止したことを素早く見つけるのに役立ちます。ただし、本番データを作る操作や有料APIをhealth checkのたびに呼ぶと、それ自体がデータや料金を増やします。軽い生存確認と、主要操作の確認は分け、後者は安全なテスト用データや頻度で実行します。
正常の定義には、環境も含めます。Previewで動いたことは、本番のデータベース、Secrets、ドメイン、外部サービスとの接続が正しい証拠にはなりません。本番で確認するときは、テスト用の利用者や識別できるデータを使い、確認後に残るものまで決めます。
一回の操作を、途中で見失わない記録にする
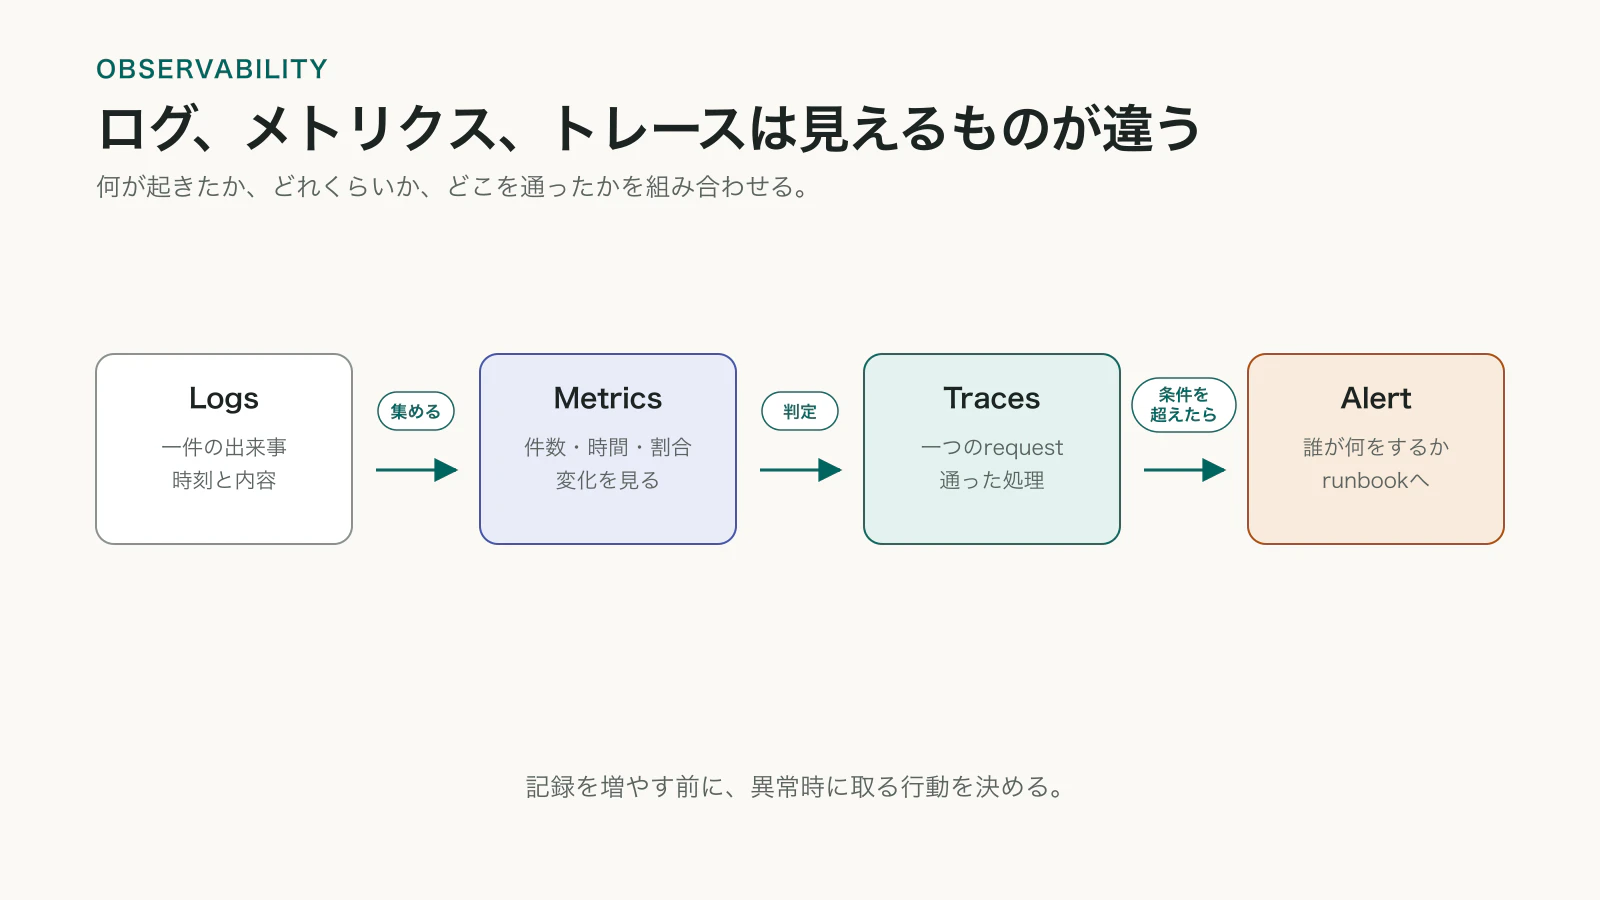
「保存できなかった」という一件を調べるには、その操作がブラウザ、API、データベース、外部サービスのどこまで進んだかを結び付ける必要があります。そこで使われるのが、ログ、メトリクス、トレースです。
ログは、個々の出来事を残します。人が自由文で書いた文章だけでなく、項目を揃えたstructured logにすると検索しやすくなります。
{
  "timestamp": "2026-08-25T12:34:56Z",
  "level": "error",
  "event": "article.create.failed",
  "requestId": "req_abc123",
  "route": "POST /api/articles",
  "durationMs": 1520,
  "errorCode": "DATABASE_TIMEOUT"
}
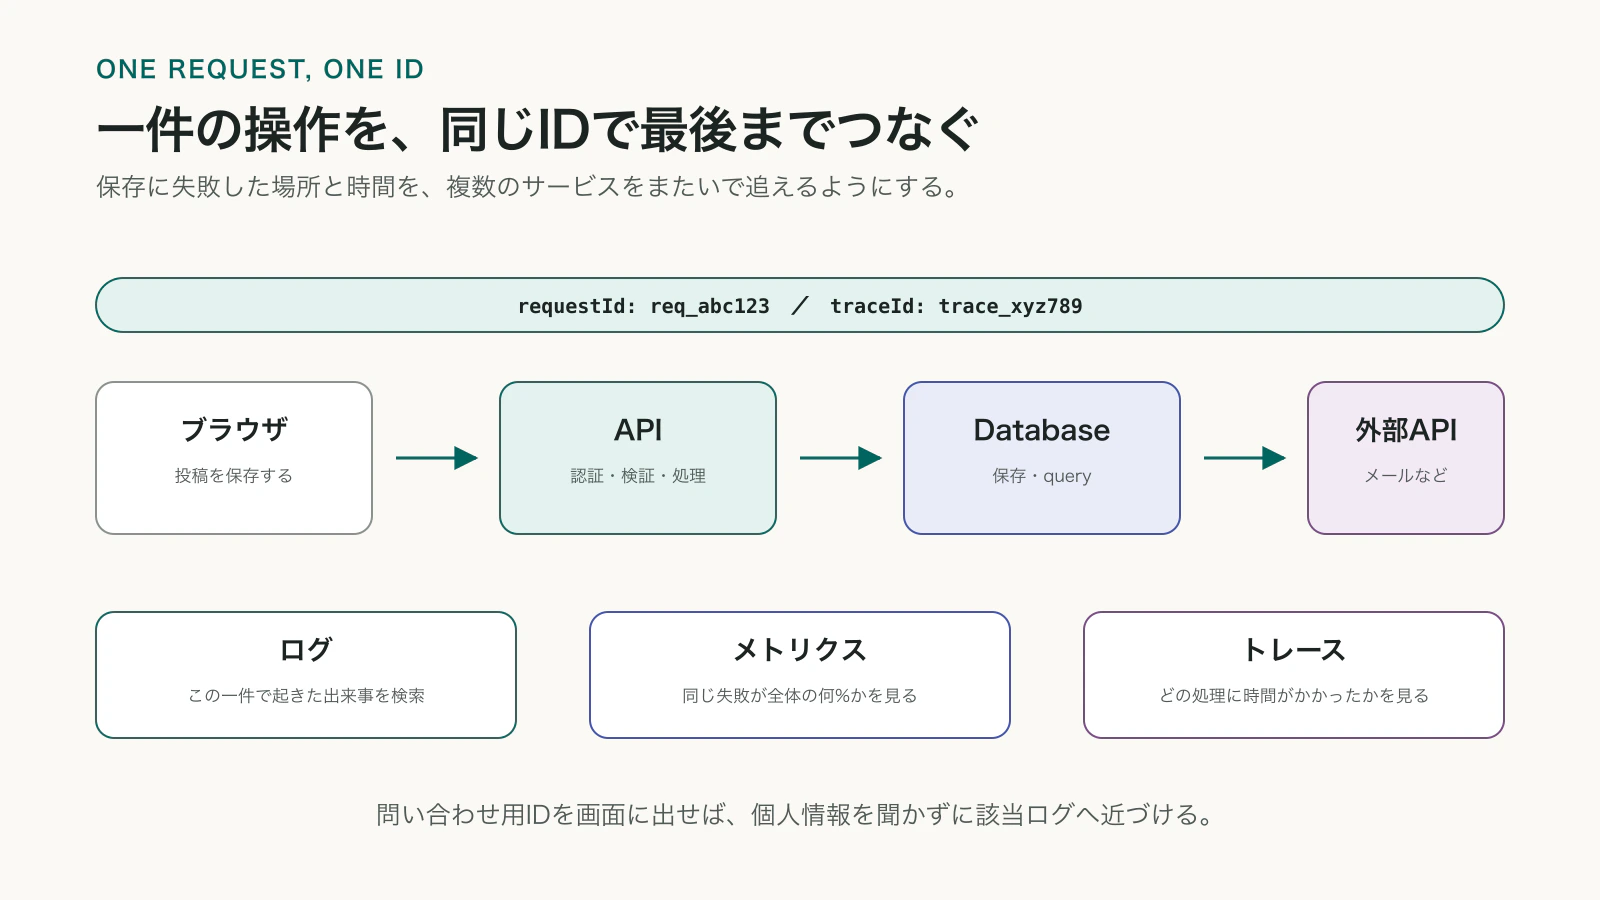
requestIdは、一回のリクエストへ付ける識別子です。ブラウザからAPI、APIからデータベースや外部APIへ同じIDを引き継ぐと、「この問い合わせで失敗した一回」を検索できます。利用者へエラー画面を出す場合も、問い合わせ用IDとして表示すれば、時刻や個人情報を聞き回らずに該当ログへ近づけます。
メトリクスは、一定期間の数値です。1分あたりのリクエスト数、エラー率、応答時間、Queueの未処理件数、データベース容量などを記録します。一件の詳しい原因はログで追い、同じ失敗が全体の何%で起きているかはメトリクスで見ます。
トレースは、一つの操作が複数の処理を通る流れをつなぎます。投稿の保存に1.8秒かかったとき、認証に20ミリ秒、データベースに1.7秒、残りがAPIの処理だと分かれば、遅い場所を絞れます。複数のサービスやQueueをまたぐ構成ほど、trace IDやspanによるつながりが役立ちます。
三つを別々に集めるだけでは、調査で行き来できません。アラートになったメトリクスから、その時間帯のログを開ける。ログのrequest IDからトレースを開ける。トレース内の失敗した外部APIを特定できる。このつながりがあると、通知から原因候補までを短くできます。
調査に必要な情報と、残してはいけない情報を分ける
ログを増やすと調査しやすくなりますが、入力値を丸ごと記録すればよいわけではありません。ログは本番データのコピーになりやすく、閲覧できる人や保存先もデータベース本体とは異なります。
次の値は、原則として記録しません。
- パスワード
- APIキー、access token、session cookie
- データベース接続文字列
- クレジットカード番号
- メールやチャットの本文
- 調査に不要な氏名、住所、メールアドレス
利用者を区別する必要があるなら、メールアドレスではなく内部の利用者IDを使います。エラーになった入力を調べたい場合も、値そのものではなく、項目名、長さ、検証エラーの種類などで足りないか考えます。
例外をそのまま記録すると、外部APIのURLに含まれたtokenや、SQLに渡した個人情報まで混ざることがあります。共通のloggerで伏せ字にする項目を決め、通常ログだけでなくエラーログやトレースにも同じ規則を適用します。
ログには保存期間と閲覧権限が必要です。障害調査に30日あれば足りるログを無期限に残すと、料金と漏えい時の影響だけが増えます。誰が検索できるか、監査のために何を残すか、削除要求の対象になる個人情報が含まれていないかを決めます。
アラートは、通知後に取る行動から逆算する
エラーを一件記録するたびに通知すると、botによる404や一時的な通信失敗まで届きます。通知が多すぎると、重要なアラートも読まれなくなります。反対に、日次集計だけでは、保存できない状態を翌日まで見逃します。
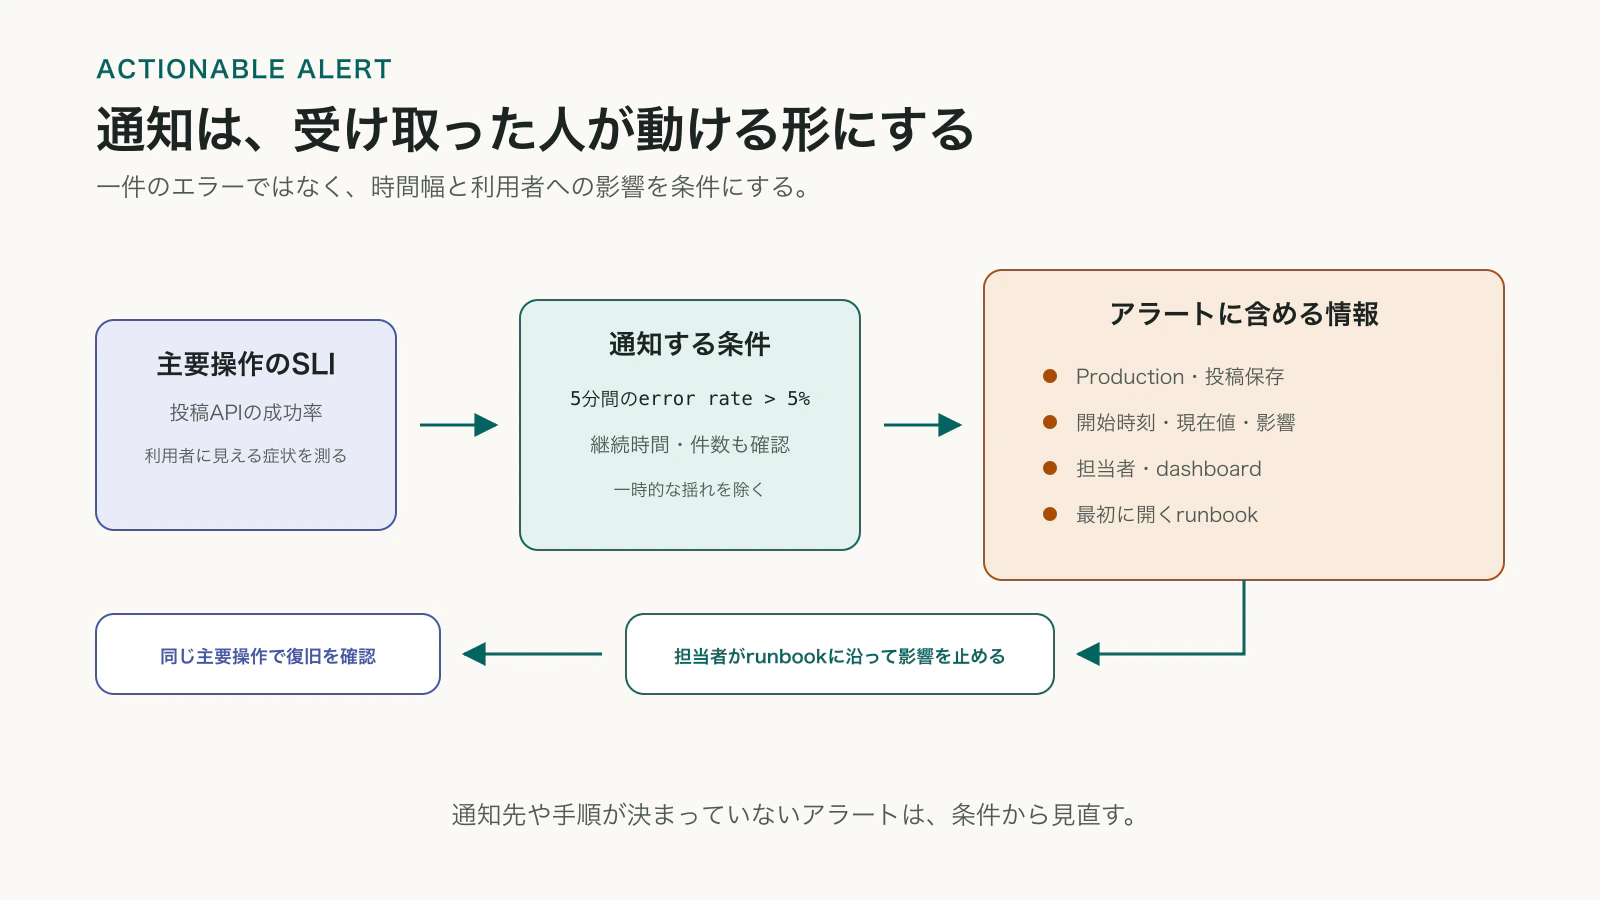
行動できるアラートには、条件だけでなく、時間幅、重要度、通知先、最初の確認場所があります。
- 5分間の投稿APIのエラー率が5%を超えたら、担当者へ緊急通知する
- Queueの最古のjobが15分以上待っていたら、処理Workerと外部APIを確認する
- データベース容量が80%へ達したら、翌営業日までに増加原因と拡張方法を確認する
- 月間費用が予算の80%へ達したら、利用量と異常な再試行を確認する
一件の失敗ではなく、一定時間の割合や継続時間を見ると、一時的な揺れと利用者へ影響する障害を分けやすくなります。アクセスが少ないサービスでは、割合だけだと一件の失敗で100%になります。その場合は失敗件数や、連続して失敗した回数も合わせます。
原因ではなく、利用者に見える症状を優先して通知することも大切です。CPU使用率が高くても、主要操作が正常なら緊急でない場合があります。CPUが平常でも、外部APIの認証切れで決済だけが全滅していることもあります。資源のメトリクスは原因調査に使い、主要操作の成功率や遅延を入口にすると、利用者への影響を見失いにくくなります。
通知には、環境、開始時刻、影響する機能、現在値、関連ダッシュボード、runbookへのリンクを含めます。「エラーが起きました」だけでは、受け取った人が何をすべきか分かりません。夜間に起こす必要があるものと、翌日に確認すればよいものも分けます。
SLIとSLOで、感覚ではなく状態を比べる
SLIは実際に測る指標、SLOはその指標で目指す水準です。
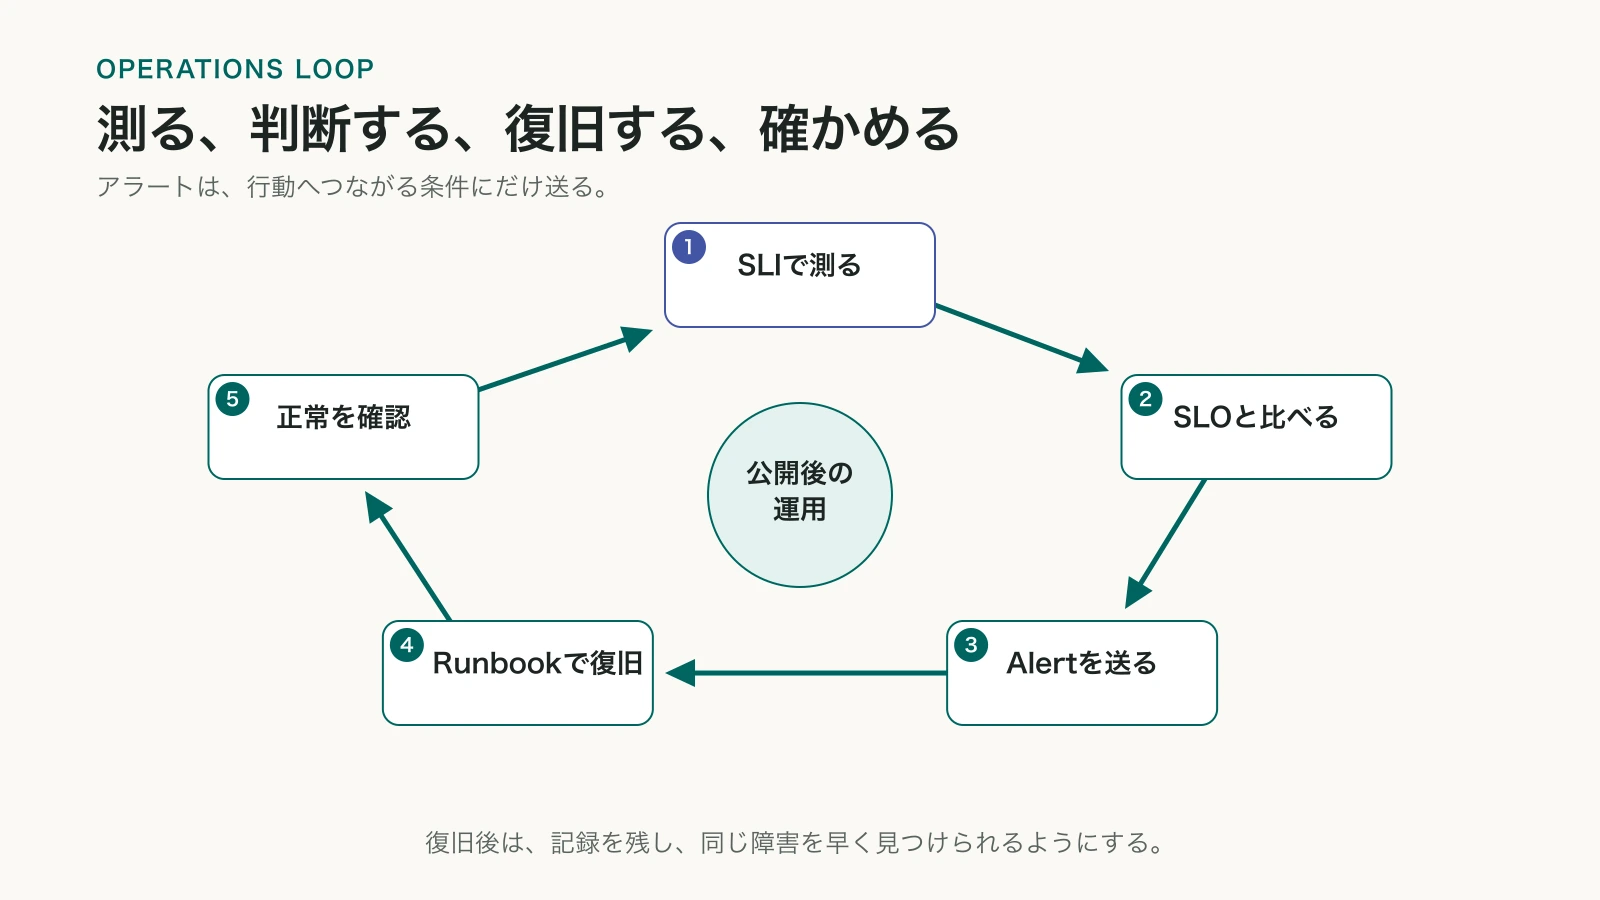
投稿APIなら、成功したリクエスト数を全リクエスト数で割った成功率をSLIにできます。30日間で99.9%以上を保つことをSLOにすれば、1万回のうち失敗を10回未満に抑える水準です。
ただし、利用者の入力ミスによる400までサービス障害として数えると、アプリ側では改善できない失敗が混ざります。反対に、サーバーが誤って200を返したものの保存できていない場合を成功に数えると、実態よりよく見えます。どのstatus codeと結果を成功・失敗に数えるかを、利用者の体験に合わせて決めます。
100%をSLOにすると、短いメンテナンスや外部サービスの一時停止も一切許されません。必要な水準は、サービスの重要さと対応できる体制に合わせます。使える余裕をerror budgetと考えると、新機能を急いで出すか、安定性の修正を優先するかを判断しやすくなります。
最初からすべての画面へSLIを作る必要はありません。ログイン、保存、決済など、失敗するとサービスの価値が大きく損なわれる操作から始めます。指標を集めること自体が目的にならないよう、悪化したときにどの判断へ使うかを決めます。
障害時は、原因究明より先に影響を止める
障害が起きると、すぐコードを直したくなります。しかし、原因がまだ分からない状態で本番へ変更を重ねると、状況を悪化させたり、最初の原因を追えなくしたりします。まず事実を揃え、利用者への影響を小さくします。
- 何が使えず、何は使えるかを確認する
- 影響する利用者、環境、開始時刻を絞る
- 直前のデプロイや設定変更との時間関係を見る
- 新規受付の停止、機能の無効化、以前の版へのロールバックを判断する
- 同じ主要操作で復旧を確認する
- 復旧後に原因と再発防止を調べる
新しいデプロイ直後からエラー率が上がったなら、以前の版へ戻すのが早いことがあります。ただし、同時にデータベースの構造を変更している場合、コードだけを戻すと新しい構造と合わない可能性があります。ロールバックできる範囲を、変更前に確認しておきます。
外部サービスが止まっているなら、呼び出しを何度も繰り返すより、その機能を一時停止してQueueへ残すほうが安全な場合があります。読み取りだけを提供する、書き込みを一時的に止めるなど、サービス全体を落とさず影響部分を切り離す方法もあります。
本番データを直接直す必要があるときは、対象条件と予想件数を先に出し、変更前のバックアップと戻し方を用意します。実行した時刻、担当者、コマンド、変更件数を記録します。急いでいるときほど、あとから何が起きたかを再現できる情報が必要です。
障害中の記録には、確定した事実と推測を分けて書きます。「12時34分から保存APIのエラー率が上がった」は事実です。「データベースが原因らしい」は調査中の仮説です。この二つが混ざると、別の担当者が誤った前提で作業を進めます。
Runbookは、実際に開ける場所と確認順序まで書く
runbookは、よくある障害や運用作業の手順書です。「ログを確認する」だけでは、緊急時に使えません。どのサービスの、どの環境の、どの画面を開き、何を検索するかまで書きます。
投稿を保存できない場合なら、次のような流れです。
- 本番Statusページで、外部サービスを含む広い障害がないか確認する
POST /api/articlesの成功率と応答時間を開く- 発生時間とrequest IDでログを検索する
- データベースの接続エラー、容量、遅いqueryを確認する
- 直前のデプロイと環境変数の変更履歴を確認する
- ロールバックまたは保存機能の一時停止を判断する
- テスト用アカウントで保存と再表示を行い、同じ指標が戻ったことを確認する
runbookには、必要な権限の取得方法、連絡先、判断する人、利用者への告知先も含めます。secretそのものは貼り付けません。「本番DBを確認する」と書かれていても、権限を持つ人しか実行できないなら、その人へ連絡する条件が必要です。
作ったまま使われないrunbookは、画面名やURLが古くなります。定期的に手順をなぞり、権限、コマンド、リンクが今も有効か確認します。実際の障害で詰まった箇所は、復旧後にrunbookへ戻します。
バックアップは、戻せる範囲と時間で考える
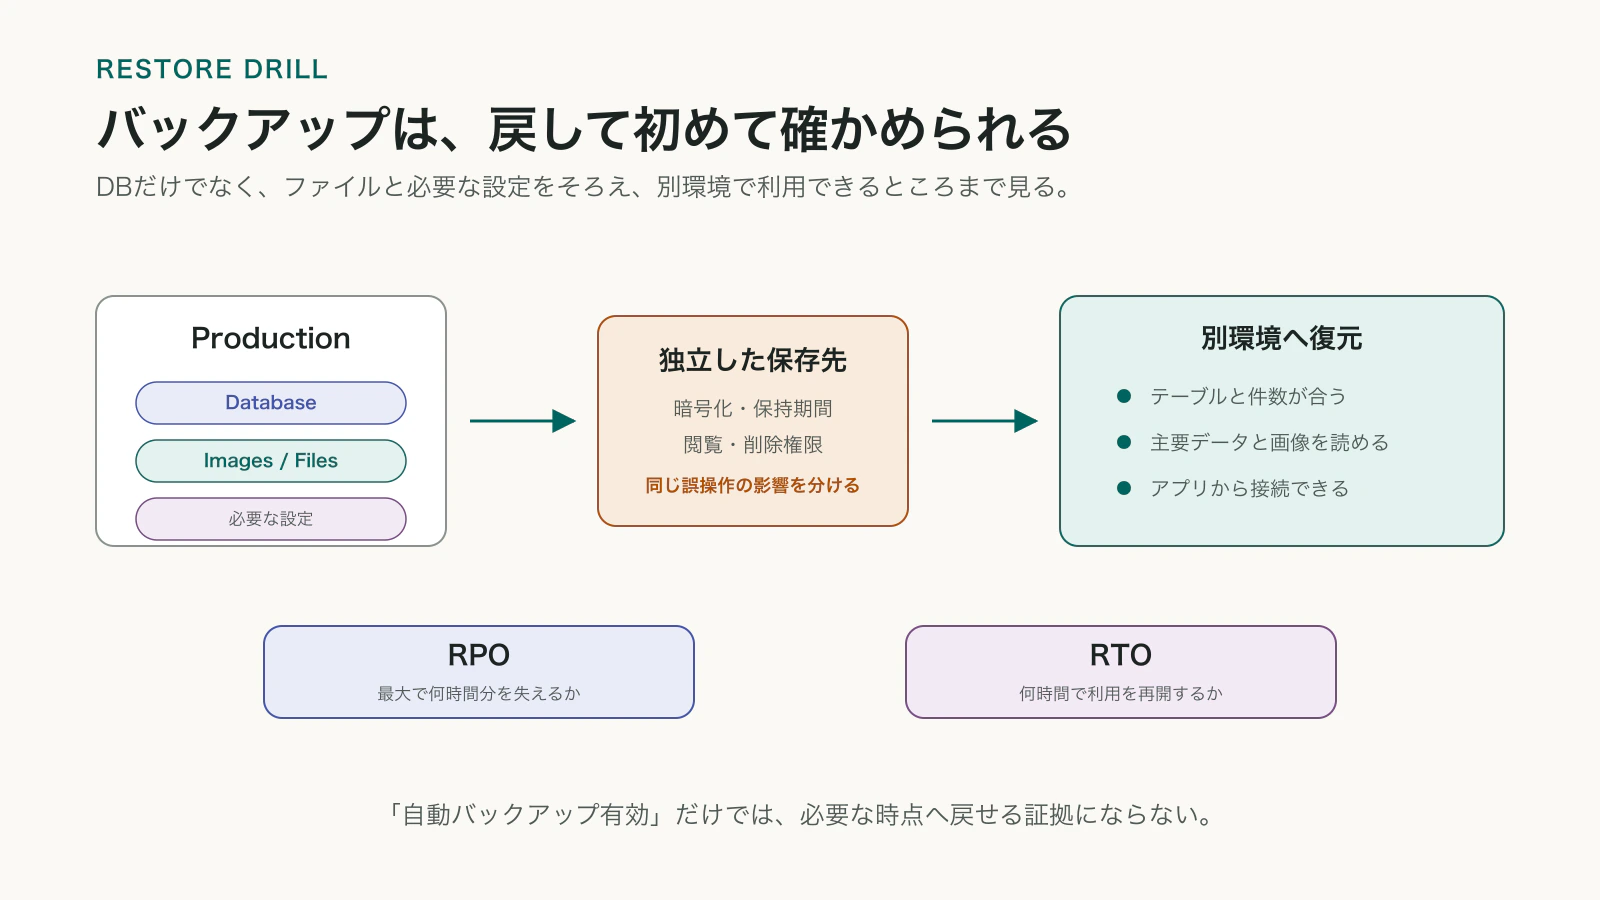
バックアップが有効でも、必要なデータが含まれているとは限りません。データベースだけを保存しても、利用者がアップロードした画像が別ストレージにあれば、完全には戻りません。復旧対象には、データベース、ファイル、必要な設定、外部サービス側の構成を含めます。
二つの時間を決めると、必要な仕組みを選びやすくなります。
- どの時点まで戻れればよいか:1時間ごとのバックアップなら、最大で約1時間分の更新を失う可能性がある
- どれくらいで利用を再開したいか:復元と確認に半日かかるのか、30分以内が必要なのか
前者はRPO、後者はRTOと呼ばれます。言葉よりも、「最大で何時間分を失えるか」「何時間止められるか」という意味を決めることが重要です。毎日一回のバックアップでは足りないサービスもあれば、個人用の小さなツールなら十分な場合もあります。
バックアップは、本番と同じ認証情報だけで触れられる場所へ一つ置くのではなく、障害や誤操作の影響を一緒に受けにくい保存先と権限を選びます。暗号化、保持期間、削除権限も確認します。
そして、実際に別環境へ復元します。テーブルが作られた、件数が合う、主要なレコードを読める、画像を開ける、アプリから接続できるところまで確かめます。「自動バックアップ有効」という表示や、ファイルが存在することだけでは、復元できる証拠になりません。
マイグレーションはデータベース構造の変更手順であり、失ったデータを戻すバックアップではありません。構造変更の前にバックアップが必要なことはありますが、二つは別の役割です。
CronとQueueは、画面に出ない成功を監視する
毎日0時の集計、期限切れデータの削除、定期メールなどは、利用者がボタンを押さないため、失敗しても問い合わせが来るまで気づけないことがあります。Cronの監視では「決めた時刻に起動したか」だけでなく、最後まで処理できたかを見ます。
- 開始時刻と終了時刻
- 成功、失敗、処理件数、スキップ件数
- 前回成功した時刻
- 途中から再実行できるか
- 二重に起動しても同じ結果になるか
対象0件で正常終了したのか、データベースへ接続できず0件になったのかを区別します。UTCと日本時間の取り違えも起こりやすいため、設定値とログのtimezoneを明記します。
Queueは、メール送信や画像処理を一度受け付け、あとから処理する仕組みです。画面へ早く応答でき、外部サービスの一時的な失敗も再試行できます。一方、APIが成功してもQueueの処理が止まっていれば、利用者にはメールが届きません。
Queueでは、未処理件数だけでなく、最も古いjobが何分待っているかを見ます。新しいjobが少なければ件数は小さくても、一件が何時間も残ることがあるからです。再試行回数、次の実行時刻、最後に失敗した理由、処理不能になったjobの保存先も必要です。
再試行では、同じ処理が複数回動く前提を持ちます。決済完了のjobを二度処理しても注文を二重作成しない、メール送信の状態を記録する、といった重複防止をidempotencyと呼びます。処理の途中で停止すると、「外部APIでは成功したがDBには未記録」という状態も起こるため、どこから安全にやり直せるかを決めます。
料金と容量は、止まる前の増え方を見る
クラウドサービスは、利用量に応じて料金や上限が変わります。現在の合計だけでなく、何が増加を作っているかを分けて見ます。
- リクエスト数とCPU時間
- データベースの読み書き回数と容量
- 画像や動画の保存量と転送量
- LLMへ送るtoken数
- Queueの処理回数と再試行
- ログ、メトリクス、トレースの保存量
利用者が増えていないのに料金が上がったなら、無限に近い再試行、同じ定期処理の二重起動、必要以上に詳しいログ、botアクセスなどを疑います。料金は経理上の数字だけでなく、異常な動作を知らせるメトリクスにもなります。
予算の50%、80%、100%など段階的に通知すると、停止前に調査できます。hard limitで処理を止める場合は、何が使えなくなるかを確認します。料金を守るための上限が、予告なくログインや保存を全面停止させることもあるからです。低優先の処理だけを止める、LLMの利用回数を制限するなど、中心機能を守る順序を決めます。
容量も、上限へ達した時点では遅いことがあります。現在値、先週からの増加量、今の増え方ならいつ上限に届くかを見ます。不要なデータを消す場合は、保持期間、法的・業務上の必要性、バックアップとの関係を確認します。
保守は、期限と担当を予定に入れる
コードを変えなくても、周囲の環境は変わります。Node.jsのサポートが終わる、外部APIの旧版が廃止される、tokenや証明書が期限切れになる、ドメインの更新日が来る、といった変化です。
月に一度、四半期に一度など、対象に合う間隔で次を確認します。
- Next.js、Node.js、npm packageの更新とセキュリティ情報
- 外部APIの廃止予定と仕様変更
- token、証明書、ドメインの期限
- データベースとストレージの容量
- バックアップの復元結果
- 利用していないPreview、Queue、ストレージ、監視設定
- アラートの通知先とrunbookのリンク
項目だけでなく、誰が、いつ、どの結果を残すかを決めます。期限通知が退職した人のメールへ届いていたり、緊急アラートのチャンネルを誰も見ていなかったりすると、設定があっても機能しません。
不要に見えるリソースを削除するときは、名前だけで判断しません。現在の接続先、参照している環境変数、最終アクセス、バックアップを確認します。古い名前の本番DBや、失敗時だけ使うQueueを消してしまうことがあるからです。
運用設定の変更を確認する
監視設定やrunbookを追加しても、実際の環境と結び付いていなければ役に立ちません。変更後は、記録、通知、復旧を一つの流れとして確かめます。
- 主要操作と、その正常・失敗の判定が決まっているか
- 一件の操作をrequest IDやtrace IDで追えるか
- secretや不要な個人情報がログとトレースへ出ていないか
- アラートに時間幅、重要度、通知先、最初の行動があるか
- 通知をテスト送信し、担当者が受け取れるか
- ロールバック後に、同じ主要操作で復旧を確認できるか
- バックアップを別環境へ復元し、アプリから読めるか
- Cronの最終成功時刻と処理件数が分かるか
- Queueの滞留時間、再試行、重複防止、処理不能jobを確認できるか
- 料金、容量、期限が上限へ達する前に分かるか
必要な記録と確認方法を揃えるには、次のように依頼できます。
利用者にとって重要な操作を三つ以内に絞り、各操作の成功条件、ログ、メトリクス、アラートを対応させてください。通知後に最初に開く画面と確認順序も示してください。
一件の操作をrequest IDでブラウザからAPI、データベース、外部サービスまで追えるようにしてください。ログとトレースにAPIキー、token、Cookie、本文、不要な個人情報が含まれないことを確認してください。
バックアップの対象、頻度、保持期間、失ってよい時間、復旧に使える時間を示してください。別環境へ復元し、件数、主要データ、ファイル、アプリからの接続を確認する手順を作ってください。
CronとQueueについて、最終成功時刻、処理件数、最古の未処理job、再試行、重複防止、処理不能jobの確認場所を示してください。失敗を発生させ、通知と再処理を確認してください。
運用できる状態とは、障害が起きない状態ではありません。利用者への影響を数字と記録で見つけ、一件の操作を追い、変更を増やしすぎずに復旧し、同じ操作で正常に戻ったことを確かめられる状態です。公開後にしか起きない問題も、その流れがあれば、手がかりのない問い合わせではなく、調査と判断ができる出来事になります。